6.1 渲染性能优化策略
6.1 渲染性能优化策略
本节摘要:性能损耗落在三个维度——调用开销、状态切换、带宽。本节给出每个维度的归因方法与对应手段,并强调优化的第一纪律:度量先于动手,复测确认结案。
一个反例:越优化越慢
某项目为救帧率,工程师把所有能想到的优化一波全上:纹理全部转压缩格式、批量合并绘制调用、把大量资源搬进默认堆。一周后复测,帧率不升反降。复盘发现:压缩纹理在他担心的场景根本不是瓶颈,反而增加了采样前的解码负担感(带宽确实省了,但该场景瓶颈在像素着色器);合并绘制把原本可以按状态分批的提交揉成一团,状态切换没少、缓存局部性变差;资源搬堆制造了大批一次性拷贝。反例的教训:没有度量支撑的优化是赌博,多管齐下等于不知道哪张牌有用、哪张牌有毒。 这个反例还有个续集:那位工程师后来把同一批优化逐项拆开重做,发现真正有效的只有一项(实例化),其余全是负贡献——度量不是流程洁癖,它是唯一能把"有效"从"感觉有效"里分拣出来的筛子。 本节的方法论由此展开:先归因,再开方,后复测。
归因:瓶颈在哪个维度
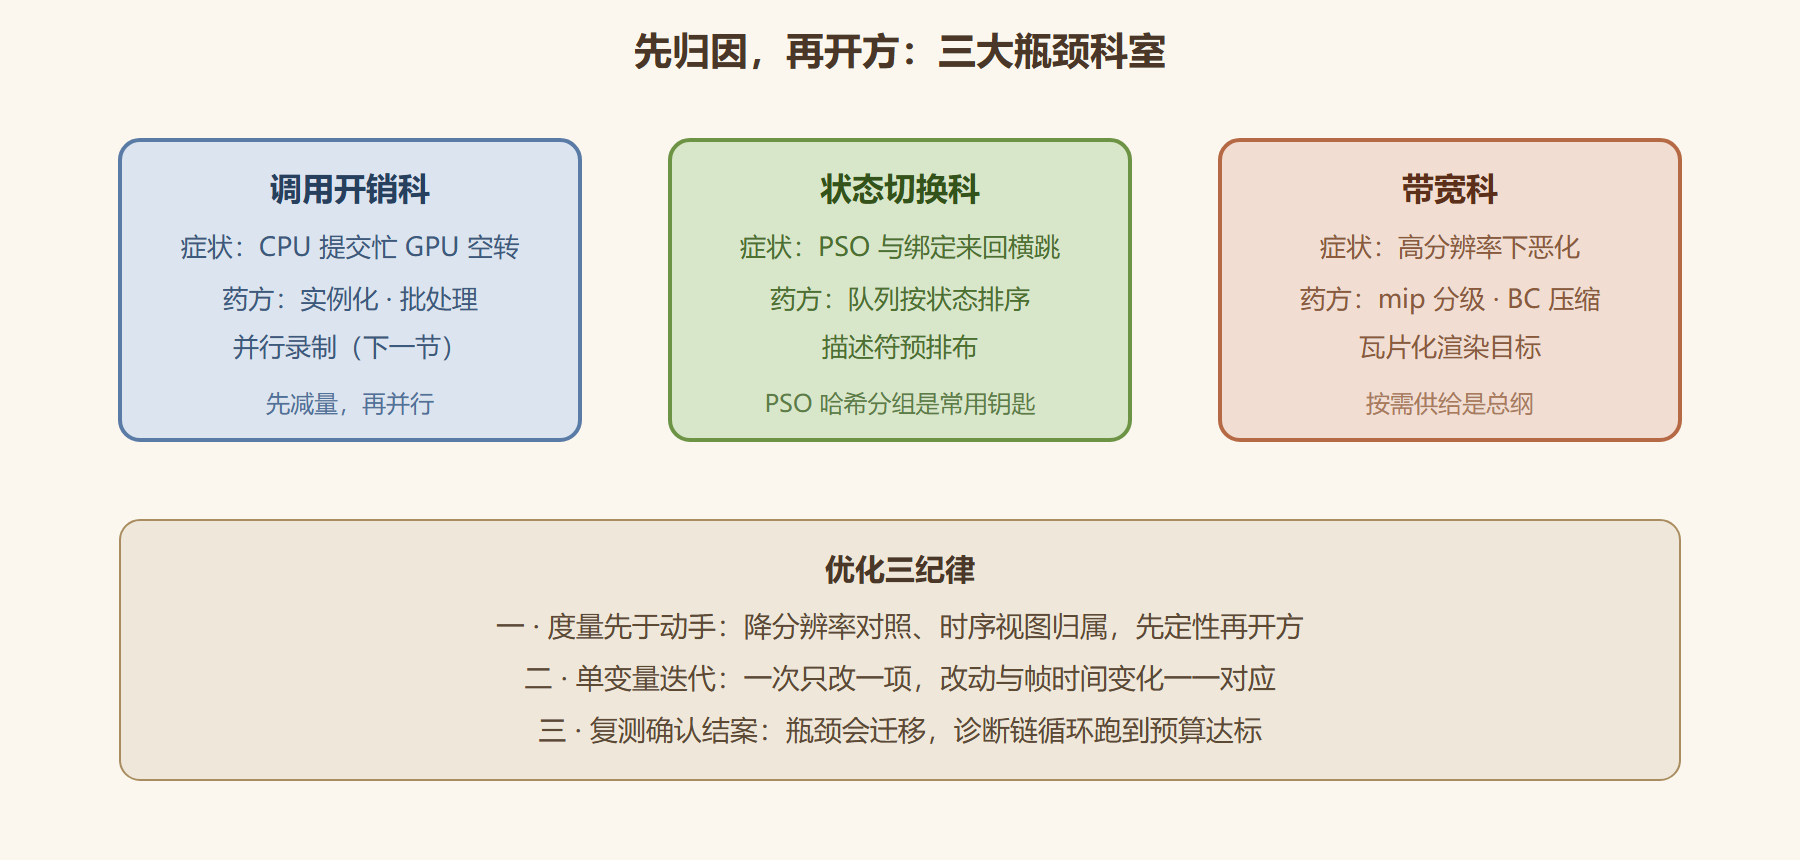
第一步永远是拿数据。PIX 的 GPU 时序视图给出各 pass 耗时;配合几组对照实验即可归因:降一半分辨率跑一遍——帧时间大幅下降说明像素着色器或带宽是瓶颈;把场景复杂度减半而帧率不变——瓶颈在 CPU 侧提交;单 pass 内更细的归属靠时序视图逐段看。几分钟的对照实验,换来的是整个优化方向不跑偏。三个维度的典型症状与手段如下表:
| 维度 | 典型症状 | 诊断手段 | 对应药方 |
|---|---|---|---|
| 调用开销 | CPU 单帧提交耗时长,GPU 有空转 | 看提交线程耗时与队列水位 | 减少绘制调用、多线程录制、批处理 |
| 状态切换 | 帧内 PSO 与绑定切换频繁 | 事件列表数切换次数 | PSO 分组排序、描述符预排布 |
| 带宽 | 高分辨率下恶化明显 | 降分辨率对照、时序里看读写量 | mip 分级、纹理压缩、瓦片化目标 |
调用开销维度:少提交、并行提交
调用开销的本质是每条命令都有固定成本——验证、翻译、入队,单位成本小但架不住次数多。两条路线压降:减量与并行。减量走实例化(Instancing,同一网格多份实例一次绘制)与批处理(相同材质的物体合并网格),把"千次调用"压成"数十次";并行走 6.2 节的多线程录制——总提交量不减,但录制与提交的 CPU 成本被摊到多个核心。两者不互斥,正式项目通常先减量后并行。
状态切换维度:让切换变成排序问题
第三章 3.5 节讲过 PSO 创建贵、运行快,但"运行快"的前提是切换次数本身可控。常见的隐性问题:场景按空间顺序遍历,材质与 PSO 在帧内来回横跳。解法是把渲染队列按状态分组排序——不透明队列按 PSO 哈希排序,同组内的绑定变化降到最低;半透明队列按深度排序(正确性要求),但要与状态分组的需求权衡。描述符同理:4.1 节"预排布、快绑定"的总纲在此兑现——堆里按材质预排好,帧内只换根参数。排序的代价也别忽略:按状态排序意味着渲染顺序与空间局部性脱钩,剔除效率与缓存命中可能受损——两头的平衡要在实测里找,没有免费的排序。
带宽维度:让每个字节物尽其用
带宽优化的核心思路是按需供给。三个主力手段:
// 手段一:mip 链 + 采样器自动选级(3.4 节已埋线,此处兑现) // 远处物体采样小 mip,带宽占用随距离自然衰减 Texture2D albedo : register(t0); SamplerState trilinear : register(s0); float4 c = albedo.Sample(trilinear, uv);
手段二,纹理压缩:块压缩格式(BC 系列)在 GPU 上直接解压采样,显存占用降到几分之一——画面敏感的中低频纹理(漫反射、法线)普遍适用,4.2 节教训里"用对工具"的又一例。手段三,瓦片化渲染目标:延迟渲染的 G-Buffer 只在需要时写入、按瓦片驻留,把全屏多重渲染目标的带宽峰值削平——这是进阶话题,方向上记住"渲染目标的内存布局可以不再是一整块平面"即可,术语见到时别慌——瓦片化、寄存器化渲染说的大致是同一族思想。
图1 三维瓶颈的归因与药方
帧率之外:分位数与卡顿才是手感
度量环节还有一层进阶认知:平均帧率是个会骗人的指标。60 帧的平均值,可能由 55 帧的多数与 300 毫秒的偶发尖刺平均出来——玩家不会夸"平均流畅",只会记住那次突然的顿挫。所以正式的性能验收要看帧时间分位数:95 分位与 99 分位的帧时间,以及最大尖刺的来源。卡顿的惯犯值得列队:首次遇见到不了的 PSO 在运行期编译(下一节细说)、资产流式加载的 IO 高峰、显存驻留抖动引发的驱逐风暴、以及垃圾回收式的集中清理。它们的共同点是平均无害、瞬时致命——只能靠抓长时间帧时间曲线(PIX 的计时捕获能连录几十上百帧)来定位,单帧分析反而看不见。优化验收的标准随之升级:不仅平均达标,尾部的尖刺也要压进预算。
常见疑问:配置够却莫名掉帧,第一件事查什么
先查着色器编译卡顿。D3D 12 的 PSO 创建在部分驱动上是重活——首次创建某组合时驱动要现场完成底层编译与优化,一帧里集中创建十几个 PSO,就是一次肉眼可见的顿挫。对策在 3.5 节已埋线:PSO 预热(加载期把候选组合全部建一遍)加 PSO 缓存序列化(首次运行后把编译产物存盘,二次启动直接加载)。排查动作也简单:掉帧是否发生在新敌人类型首次出场、新特效首次触发这些"第一次"时刻——是,基本可以定罪。这类卡顿的开发机复现率低(开发机天天跑、缓存早就热了),玩家首启体验才是重灾区,务必用全新环境实测。
案例复盘:一次完整的优化循环
背景:中端机上某开放场景帧时间超标约四成。第一轮度量:降分辨率对照发现瓶颈在带宽,时序显示 G-Buffer 写入占比最高。第一轮开方:G-Buffer 从四目标减为三目标(法线改八位打包),并给漫反射纹理换 BC 压缩——帧时间回落过半。第二轮度量:瓶颈迁移到 CPU 提交(场景物体多、绘制调用破千)。第二轮开方:静态物体按材质批处理加实例化,绘制调用数量降一个数量级。第三轮复测:达标,且低分位帧时间同步改善。解读:这个循环里每次只动一个变量、每次都有前后对照——优化是迭代控制实验,不是灵感集邮。变式:若第一轮归因结果不同(比如像素着色器过载),药方会完全不同(LOD、着色器简化、VRS——第七章的可变速率着色正是这条线的延伸)。再补一条"什么时候停"的经验:优化的收益曲线递减,头几轮改动往往拿走八成收益,剩下两成要花八成力气。工程上的止损线是"预算达标且尾部无恶性尖刺",达标后把工时投给内容与测试,比继续压榨帧时间划算——性能优化的目标从来不是极限,而是够用且稳。
本节要点回顾
- 三维度归因:调用开销、状态切换、带宽,各有症状与对照实验,先归因再开方。
- 调用开销先减量(实例化、批处理)后并行(6.2 节);状态切换靠队列排序与预排布变成排序问题。
- 带宽三板斧:mip 分级、块压缩、瓦片化目标,总纲是按需供给。
- 三纪律:度量先行、单变量迭代、复测结案——瓶颈会迁移,循环跑到达标。
归因发现瓶颈在 CPU 提交?下一节正是它的主治科室:多线程录制与显式同步。