6.2 多线程命令录制与同步
6.2 多线程命令录制与同步
本节摘要:D3D 12 把并行录制变成一等公民:分配器与命令列表按线程拆分,栅栏定义 CPU 与 GPU 的会合点,多队列按任务性质分工。本节拆解这套并行机器的每个齿轮,并给出安全更新资源的标准模式。
从排队升级到多窗口
想象 2.2 节那条单通道:所有命令排一队录、排一队提交,录制线程成了瓶颈——场景越复杂、物体越多,CPU 录命令的时间越长,GPU 却在干等。D3D 12 的解法是多窗口叫号:每个线程持有自己的命令分配器与列表,各自并行录制,最后统一交给队列执行。录制的并行化了,执行依然按提交顺序串行——并行的是准备,串行的是执行,这句口诀是理解本章全部内容的钥匙。
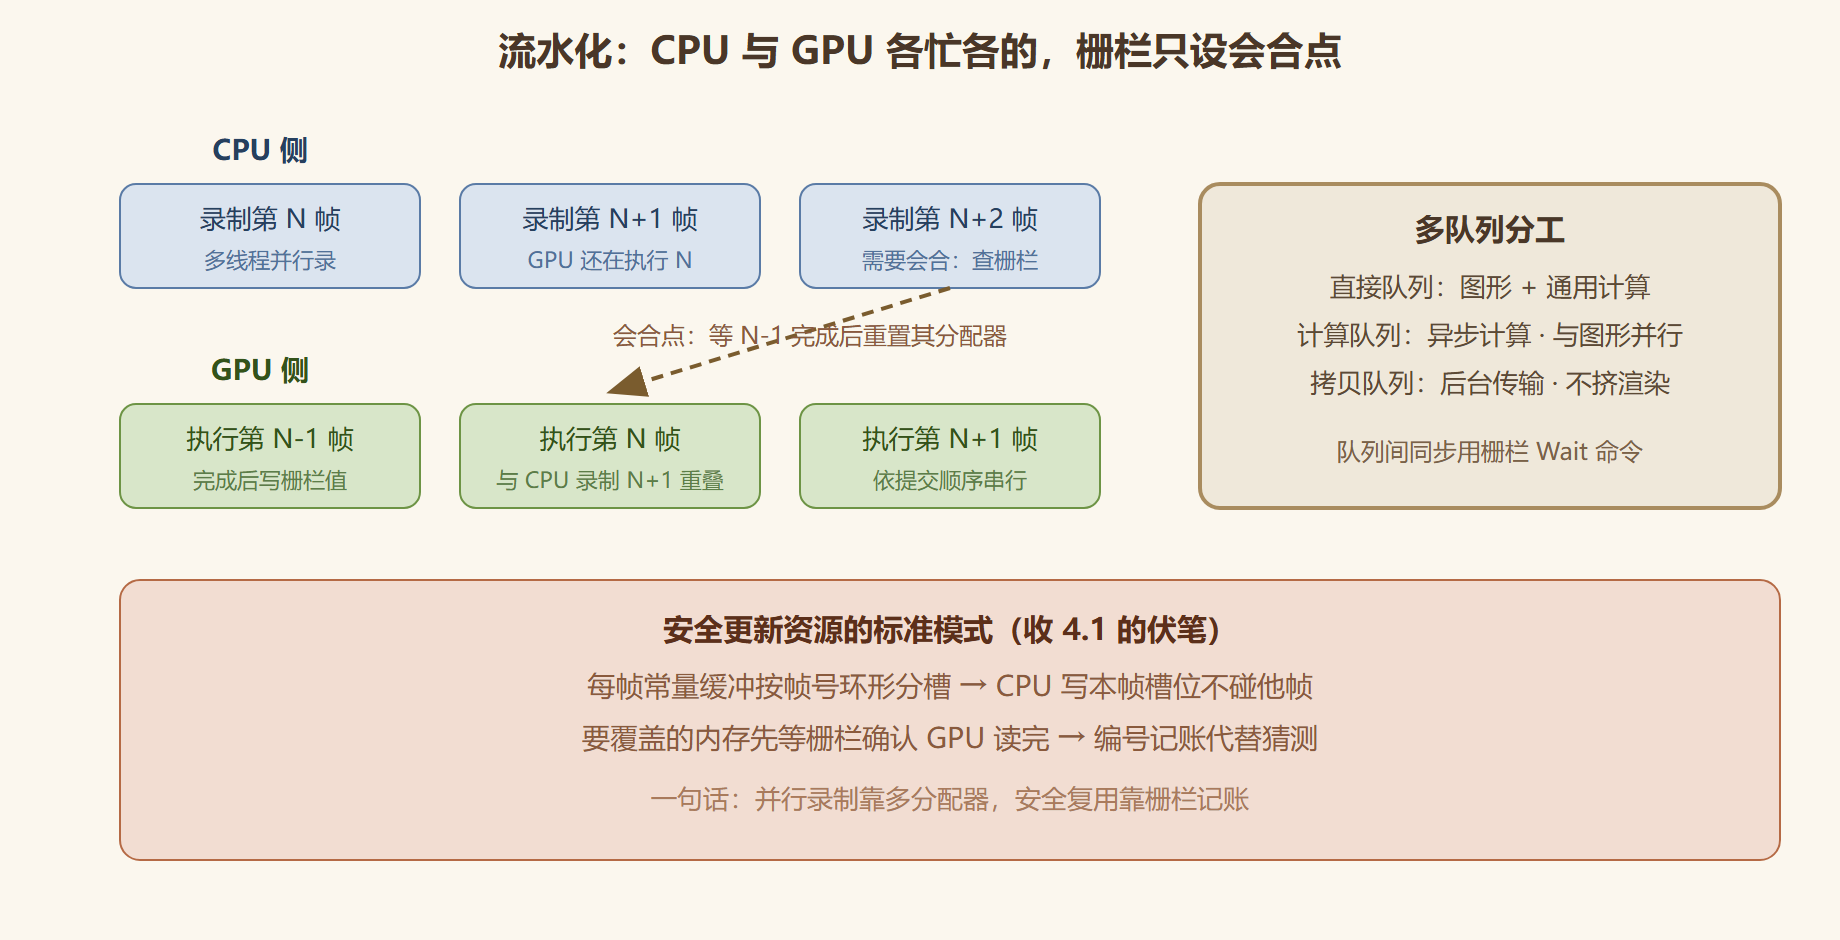
分配器的生命周期纪律是第一个工程要点:GPU 没执行完的分配器不能重置。于是"帧内多线程 + 帧间轮转"的标准布局出现——每帧为每个线程备一个分配器,按帧数轮转,栅栏保证轮到重置时上上帧早已执行完。这正是 4.1 节环形常量缓冲的同款思路,只是这次轮转的是命令内存。轮转资源的通用公式也在这里立牌:份数 = 在途帧数 + 1——每多一帧在途,环形资源就多备一份。这个公式贯穿常量缓冲、分配器与临时目标三类资源,本章之后还会反复见到。
栅栏:跨时钟域的会合点
CPU 与 GPU 是两个异步世界的时钟,栅栏(Fence)是它们之间唯一的正式会合机制。语义其实极简:队列执行到某处时把一个递增编号写进栅栏,CPU 侧可以查询或等待编号到达。三段式用法:
// 1) 录制完命令、提交时,把当前栅栏值递增地排队 UINT64 v = fence->GetCompletedValue(); queue->Signal(fence.Get(), v + 1); // 2) CPU 侧等 GPU 到达该编号(事件等待,不烧 CPU) fence->SetEventOnCompletion(v + 1, fenceEvent); WaitForSingleObject(fenceEvent, INFINITE); // 3) GPU 侧等待:命令流里插入 Wait 命令,队列间同步用 queue->Wait(fence.Get(), someValue);
两个高频错误模式要点名。忙等:循环轮询 GetCompletedValue 不释放 CPU——该用事件等待。全量等待:每帧等全部工作完成才继续——并行被自己杀掉。正确的节奏是流水化:CPU 录制第 N+1 帧的同时 GPU 执行第 N 帧,只在真正需要会合处(覆盖资源、换分配器)设栅栏。5.3 节排错实录里"环形槽位何时可覆盖"的悬案,标准答案就是这里:资源与内存的生命周期按栅栏值记账。调试栅栏问题还有个朴素工具:把"提交时的栅栏值"与"完成时的栅栏值"并排打进帧日志,两列数字一对,CPU 领先多少、卡在哪一帧一目了然——大多数"偶发卡顿"在栅栏日志面前会现出原形。
图1 流水化帧节奏与栅栏会合
帧节奏的标定:在途帧数
流水化深度由一个参数标定:在途帧数(frames in flight)——CPU 可以领先 GPU 几帧。领先一帧,CPU 与 GPU 的重叠就有一帧的缓冲;领先三帧是常见配置(每帧的分配器、常量缓冲槽位都按三份备)。在途帧数的账有两头:太多占内存——每多一帧,命令内存、环形缓冲槽位、临时资源都多备一份;太多还拉输入延迟——玩家这帧按的键,要等排在前面的在途帧全部呈现后才反映到屏幕,领先越多手感越"皮"。延迟敏感的竞技类会把在途数压到极限,用各种手段削会合点;普通项目三帧是工程甜点。理解这个参数,你就掌握了"帧节拍"的调音台:它决定 CPU 领先多少、内存多花多少、手感延迟多几分——三者的平衡点因项目而异,但机制是同一个。
提交粒度:不是录得越碎越好
多线程录制的另一个误区是"切得越细并行度越高"。命令列表本身有固定开销:创建、录制启动收尾、提交校验,列表切得碎,这些固定成本就吃掉收益。经验值是按独立的渲染阶段切——阴影一单、主视图一单、后处理一单,或按空间分块,每份录制量足以摊薄固定成本。提交端同理:一次 ExecuteCommandLists 提交多个列表优于逐个提交,驱动要为每次提交做校验与调度,次数本身是钱。极端对照很说明问题:几千个碎列表并行录制再逐个提交,可能比单线程录一个大列表还慢——并行化从来不承诺变快,它只提供可能性,粒度设计才是兑现环节。度量的办法很直接:录制耗时分线程打点、提交耗时单独计时,两张曲线对着看,粒度该切在哪一目了然。
多队列:并行不只在 CPU
CPU 侧并行化之后,GPU 侧还有一层并行空间:多队列。直接队列跑图形与通用计算;计算队列承接异步计算任务(4.3 节的粒子模拟、部分后处理),与图形工作交错执行;拷贝队列专门搬数据(流式加载的纹理上传),不与渲染抢执行资源。多队列的红利场景:阴影烘焙、剔除计算这类"结果滞后一帧也无妨"的任务移到计算队列,与主渲染并行——GPU 的不同引擎单元同时开动。要注意多队列的收益依赖硬件:目标机器有独立的计算与拷贝引擎才有真并行,否则多个队列最终在同一条引擎上排队,白付同步成本。启动时查一下队列支持情况(2.1 节适配器体检的延伸),按硬件实况决定异步计算要不要成为架构的一部分——"有条件的优化"是显式时代的常态:能力可查,路径才可分。
纪律同样明确:跨队列的数据依赖必须用栅栏声明。计算队列产出、图形队列消费的缓冲,要在消费方命令流里插 Wait。漏插的结果不是崩溃而是偶发的脏数据——比崩溃更难查,5.3 节的排错方法论在此再次适用:先假设、再工具验证。队列多了还有一条记账纪律:栅栏值按队列分账,一张总账记不住多条队列的进出。
案例复盘:录制并行化的落地
背景:某场景物体数破万,单线程录制耗时超过 GPU 执行时间,帧率被 CPU 锁死。操作:按空间分区把场景切成八块,八线程各持分配器并行录制静态部分,主线程录制动态部分并汇总提交;提交顺序固定以保证帧结果稳定。结果:录制耗时摊薄到原来的零头,CPU 恢复为瓶颈之外的因素,GPU 吃满。解读:切分策略决定并行收益——按空间切能让各线程访问的缓冲集基本不相交,减少伪共享;静态与动态分开录制则让缓存工作最小化。变式:物体数不大但材质复杂的场景,并行录制收益有限,瓶颈在 GPU 侧,切回 6.1 节的带宽与状态科室——诊断链思想再次胜过手段崇拜。落地节奏也给个参照:先把单线程版本的录制耗时测出来,超过帧预算三成再启动并行化改造——并行录制的复杂度不小,提前优化在这里同样是万恶之源;而一旦做,就把"录制与提交分离"的架构一次到位,半吊子的并行(两个线程抢一个分配器)比不并行更糟。
本节要点回顾
- 口诀:并行的是准备,串行的是执行——多线程录制 + 顺序提交。
- 栅栏三段式:Signal 排队递增、CPU 事件等待、GPU 队列 Wait;忙等与全量等待是两大反模式。
- 生命周期按栅栏值记账:分配器轮转与环形缓冲的"何时可复用"都有精确答案。
- 多队列分工:图形、异步计算、拷贝各走各队列,跨队列依赖用栅栏声明,漏声明出脏数据。
CPU 与 GPU 都跑顺了,下一节管粮仓:显存预算、堆放置与流式加载的呼吸节律。