2.2 内存管理与溢出落盘
2.2 内存管理与溢出落盘
本节摘要:DuckDB 的缓冲管理器统一管理内存块,内存不够时排序、哈希聚合、哈希连接等算子会把中间数据写到临时目录——这就是溢出落盘。本节讲清内存上限怎么算、哪些算子会溢出、溢出代价多大,以及怎么让它少发生甚至不发生。
内存装不下时发生了什么
承接上节:并行加满线程会加速内存消耗,那么数据比内存大时引擎怎么办?有两条路。一些轻量引擎选择直接报错,把问题踢回给用户;DuckDB 选择第二条路——把放不下的中间结果写到磁盘,腾出内存继续算。这个后手叫溢出落盘(out-of-core / spilling),它让你在笔记本上算出超过内存规模的结果,代价是磁盘读写的时间。
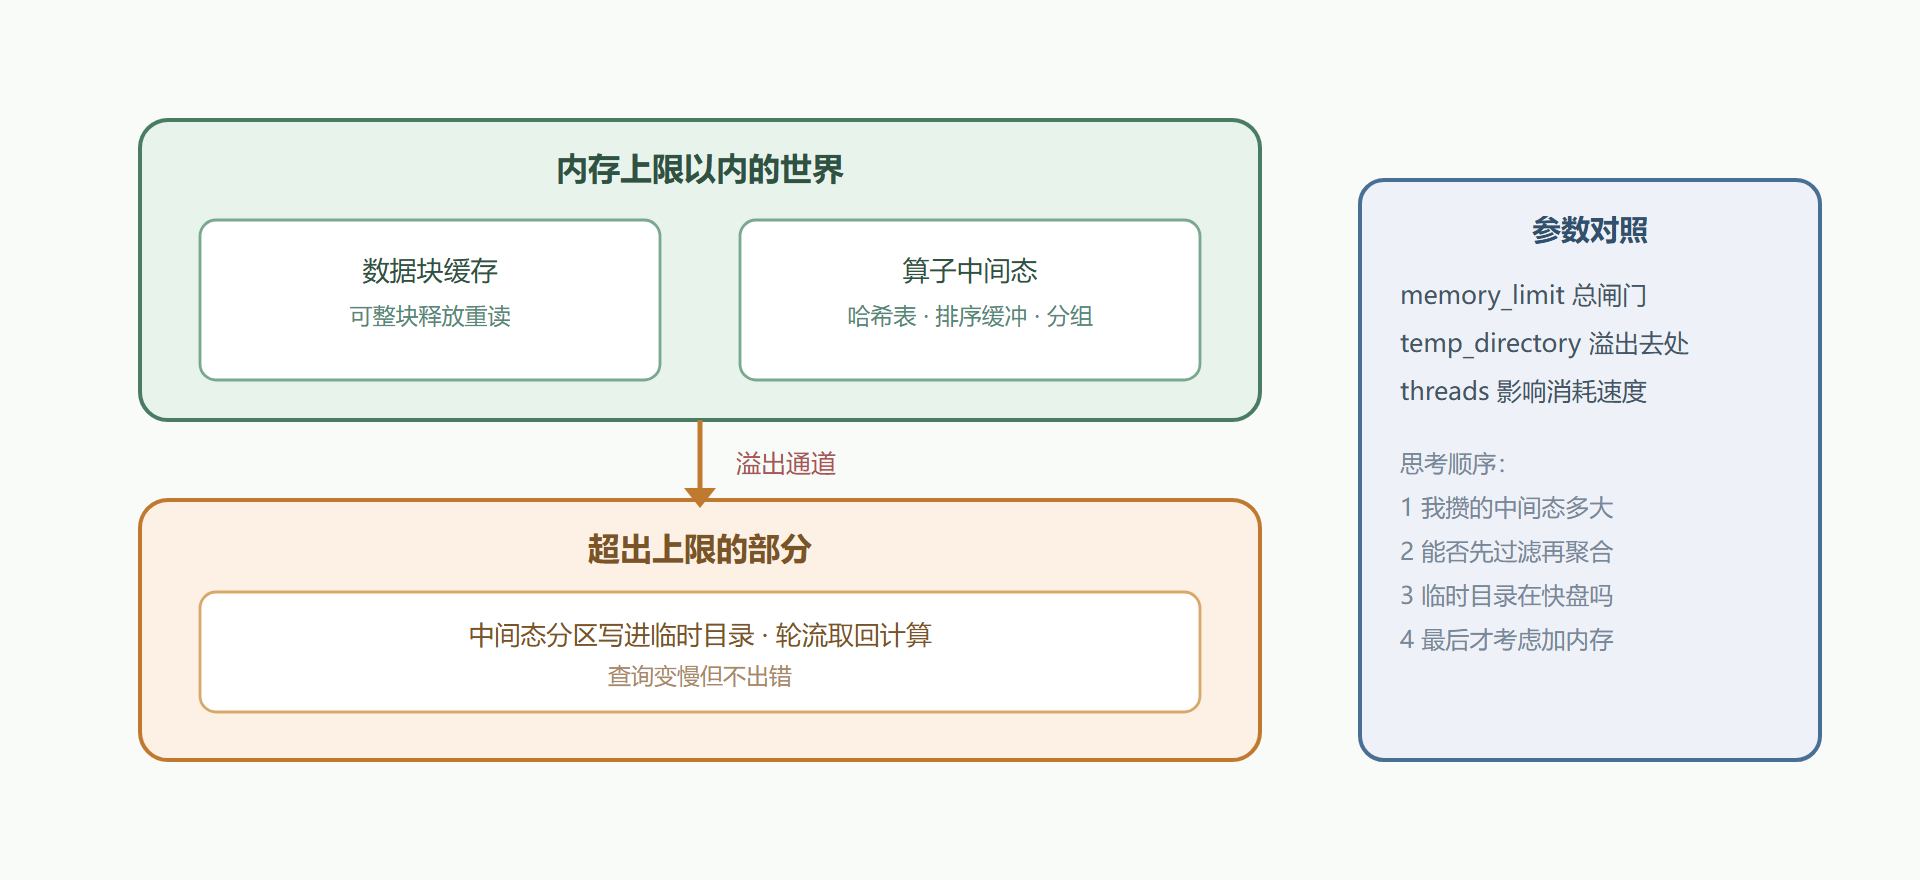
理解溢出的关键是分清两类内存。数据块缓存是引擎从磁盘读进来的表数据,受缓冲管理器统一调度,内存紧张时可以整块释放;算子中间态是查询进行中攒下的哈希表、排序缓冲、聚合分组,这些是"正在用"的内存,不能随意释放,所以才需要写到临时文件。两个类别受同一个总闸门控制,就是内存上限参数。这个分类还解释了一个现象:同一条查询,跑在"刚启动的会话"与"跑了半天的会话"里,内存余量的感觉不同——后者缓存里还驻着历史块,但那部分是可让渡的,真正的硬约束永远留给中间态。理解了两类内存的让渡优先级,你对"内存还剩多少才算够"这类问题就有了准星。
三个参数管住内存行为
-- 总闸门:查询可用的内存上限(默认约为主存的八成) SET memory_limit = '4GB'; SELECT current_setting('memory_limit') AS 当前上限; -- 溢出文件的去处:默认在库文件同目录,可以指到更快的盘 SET temp_directory = 'D:/duckdb_tmp'; -- 观察一次真实查询的峰值内存(配合执行计划使用,见第4章) EXPLAIN ANALYZE SELECT status, sum(amount) FROM trades GROUP BY status;
内存上限的默认值很有讲究:不是全部主存,而是留了余量——因为你的 Python 进程自己也要内存,宿主程序崩溃比查询失败严重得多。调大上限前先问一句:这台机器上还有谁在用内存?Jupyter 里挂着几个大 DataFrame 的时候,把引擎上限调到接近物理内存,等于请对方先崩。这个"留余量"的默认哲学值得赞赏之处在于它把默认值对齐了最坏情况:新手的典型用法就是开个大查询然后切去干别的,默认值保证这种用法最坏也只是查询变慢,而不是整机重启。
临时目录值得单独叮嘱:默认位置可能在小容量系统盘上。给溢出频繁的工作负载指定一块快盘(本地 SSD 而非网络盘),溢出代价能明显下降。反过来说,如果你的"盘"其实是网络文件系统,溢出会比报错还难受。临时目录还有个容易被忽略的邻居效应:它和库文件、CSV 原件抢同一块盘的吞吐——大查询溢出时磁盘队列里排着三种 IO,互相拖慢。给溢出单独划一块盘,等于给引擎留了一条应急车道。
哪些算子会溢出、代价几何
| 算子 | 什么时候溢出 | 溢出代价 |
|---|---|---|
| 排序 ORDER BY | 待排数据超过可用内存 | 分段排序后多路归并,多一轮写读 |
| 哈希聚合 GROUP BY | 分组数极多时 | 分区哈希表轮流进出 |
| 哈希连接 JOIN | 构建侧超内存 | 构建侧分区落盘,探测侧相应分区化 |
| 窗口函数 | 分区数据过大 | 类似排序的分段策略 |
| DISTINCT / 去重 | 去重集合巨大 | 同哈希聚合 |
表里的共同规律:溢出的对象是"中间结果"而不是原始表。扫描一个比内存大的表本身不溢出——列存可以流式读块、算完释放;真正撑爆内存的是聚合的分组数爆炸、连接的构建侧过大这类"结果比输入大"的形态。所以预防溢出的第一思考不是"加内存",而是"我在攒一个多大的中间态"。顺着这条规律还能推出一个实用的读查询习惯:拿到任何 GROUP BY 与 JOIN 组合的大查询,先在心里过一遍两个数——分组键的基数、构建侧的行数乘行宽,两个数都温顺,这条查询的内存气质就温顺;任何一个上了百万量级,就提前做好缓解预案。内存问题的最佳时机是写查询时,不是跑挂时。
图2-2 内存的两类占用与溢出通道
亲手触发一次溢出,看它的脸色
参数背得再熟,不如亲手让溢出发生一次。用主线案例的全年数据,故意把内存上限压到很小,跑一条按用户聚合的查询:
-- 故意设一个小上限,观察溢出行为(试探用,别在生产这么设) SET memory_limit = '512MB'; SET temp_directory = '/tmp/duckdb_spill'; -- 百万级用户的分组聚合:中间态远超 512MB SELECT user_id, count(*) AS 笔数, sum(amount) AS 金额 FROM trades GROUP BY user_id ORDER BY 金额 DESC LIMIT 20;
观察三件事。其一,它没有报错——查询正常返回,只是耗时从一秒涨到了十几秒;这是溢出最迷惑人的地方:不学本章的人会把这种"莫名变慢"当成数据量问题。其二,临时目录里多出了几百兆的临时块文件——查询结束它们被清掉,溢出是暂住不是定居。其三,把上限调回后重跑,耗时回到一秒级——同样的数据、同样的查询,唯一变量是中间态住得住住不进内存。这个三分钟实验把本节的核心规律演完了:溢出是性能曲线上的一个台阶,不是悬崖;你要做的是知道自己在台阶的哪一级。补一个观察细节:实验期间看一眼任务管理器,你会发现进程内存稳定在上限附近而不再上涨——溢出机制存在的意义就是把内存占用的峰值钉死在承诺线内,这也是它敢让你在笔记本上跑大数据的底气。
memory_limit 该设多大
被问得最多的参数问题,答案是一个决策顺序而不是一个数字。专用机器(这台机器就是干分析的):物理内存的七到八成,给操作系统留够页缓存——页缓存吃得好,第3章的文件读取反而更快。共享环境(笔记本上跑分析、容器里配额受限):先算清同进程宿主的占用(Python 里的 DataFrame、模型、缓存),再给引擎留出"自身峰值加两成余量"的份额,宁小勿大——引擎超限会溢出变慢,宿主被挤崩可是全灭。临时策略(偶尔跑一个已知巨大的任务):临时调高、跑完调回,配一条会话级的 SET 而不是改全局配置。三种场景的共同底色:这个参数的保护对象是你的整台机器,不是查询的体感——把它当资源宪法看,别当性能旋钮拧。
主线案例预演:文件翻倍之后
主线案例进入第二章时剧情升级:业务方追加了历史数据,CSV 从单月变成全年,行数翻了两个数量级。第1.1节那句按小时聚合的查询重新跑——竟然还能出结果,只是慢了一些。原因正是本节的第一规律:扫描是流式的,聚合的分组数只有二十四个小时,中间态小得很。真正的考验会出现在"按用户聚合"的分析上——用户数以百万计,分组中间态瞬间膨胀。这个伏笔在第2.4节引爆,那里会完整走一遍从报错到根治的排查。
本节要点回顾
- 两类内存分开看:块缓存可放可收,算子中间态才是溢出的主角。
- 参数三件套:内存上限是总闸门,临时目录决定溢出代价,线程数影响消耗速度。
- 溢出的是中间结果:大表扫描本身不炸内存,分组数爆炸和连接构建侧才是惯犯。
- 预防优于扩容:先过滤再聚合、缩小中间态,最后才轮到加内存。