- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
从CSV到结论:DuckDB实战教程导读
周五傍晚,业务同事在群里丢来一句话:"这个月的退款都集中在什么时候?给个结论,今天要。"附件是一份交易明细的CSV。你打开数据目录,文件拖进Excel半分钟没反应;用Pandas读,笔记本风扇开始狂转。这时候,真正顺手的工具应该是什么样的?——装一个不到几十兆的库,两行代码直接对CSV发SQL,几秒钟出结果,顺手还能把结论落成图表。这个工具就是DuckDB,而"从一个原始文件走到一个可信结论"这条路径,就是本教程的主线。
这本教程讲什么
DuckDB是一个嵌入式的分析型数据库:它像SQLite一样长在你的进程里、不挑操作系统、不需要单独部署服务;又像列式数仓一样按列存数据、向量化执行、对聚合和扫描类查询有数量级的速度优势。它读得了CSV和Parquet,连得上S3上的远端文件,也塞得进Jupyter笔记本、R脚本、桌面BI工具甚至浏览器。一句话:它把"数据仓库级别"的分析能力,搬到了每个人的单机上。
但本教程不打算写成功能清单。全书围绕一个贯穿案例展开:一份交易明细CSV,从读入、清洗、建模、优化到出结论,每一步遇到什么问题,就深入对应的机制去解释。你看到的每一段原理,都能在案例里找到落点;案例里踩到的每个坑,都能回头在机制里找到原因。原理与实操互相咬合,而不是两张皮。
全书结构一览
全书七章,外加这份导读。每章开头用几个真实问题起笔,读完一章,这些问题就变成你能动手解决的日常。
- 第1章 认识DuckDB:它到底是什么、从哪来、和SQLite、ClickHouse、Polars比怎么选、什么时候别用它。读完能做选型决策。
- 第2章 架构内功:进程内嵌、多核并行、内存管理、事务与ACID。含一次内存溢出的完整排错实录。
- 第3章 存储引擎:列式存储、行组与压缩编码、WAL与检查点、直查CSV和Parquet。读完明白"为什么快"和"文件怎么摆"。
- 第4章 查询引擎:一条SQL从文本到结果的完整旅程、执行计划怎么读、向量化为什么快、索引怎么用,以及把一条慢查询从几秒压到几十毫秒的会诊过程。
- 第5章 接口与生态:Python与命令行用法、SQL方言差异、与Pandas、Arrow及BI工具的集成,加一整天的Jupyter工作流实录。
- 第6章 扩展与安全:扩展机制、常用扩展、自己动手写扩展的入门路径,以及读取不可信文件时的安全边界。
- 第7章 调优建模与收官:性能调优、表设计、常见陷阱与报错解码,最后回到主线案例做一次完整复盘。
全册学习路径
知识地图:章与章的依赖关系
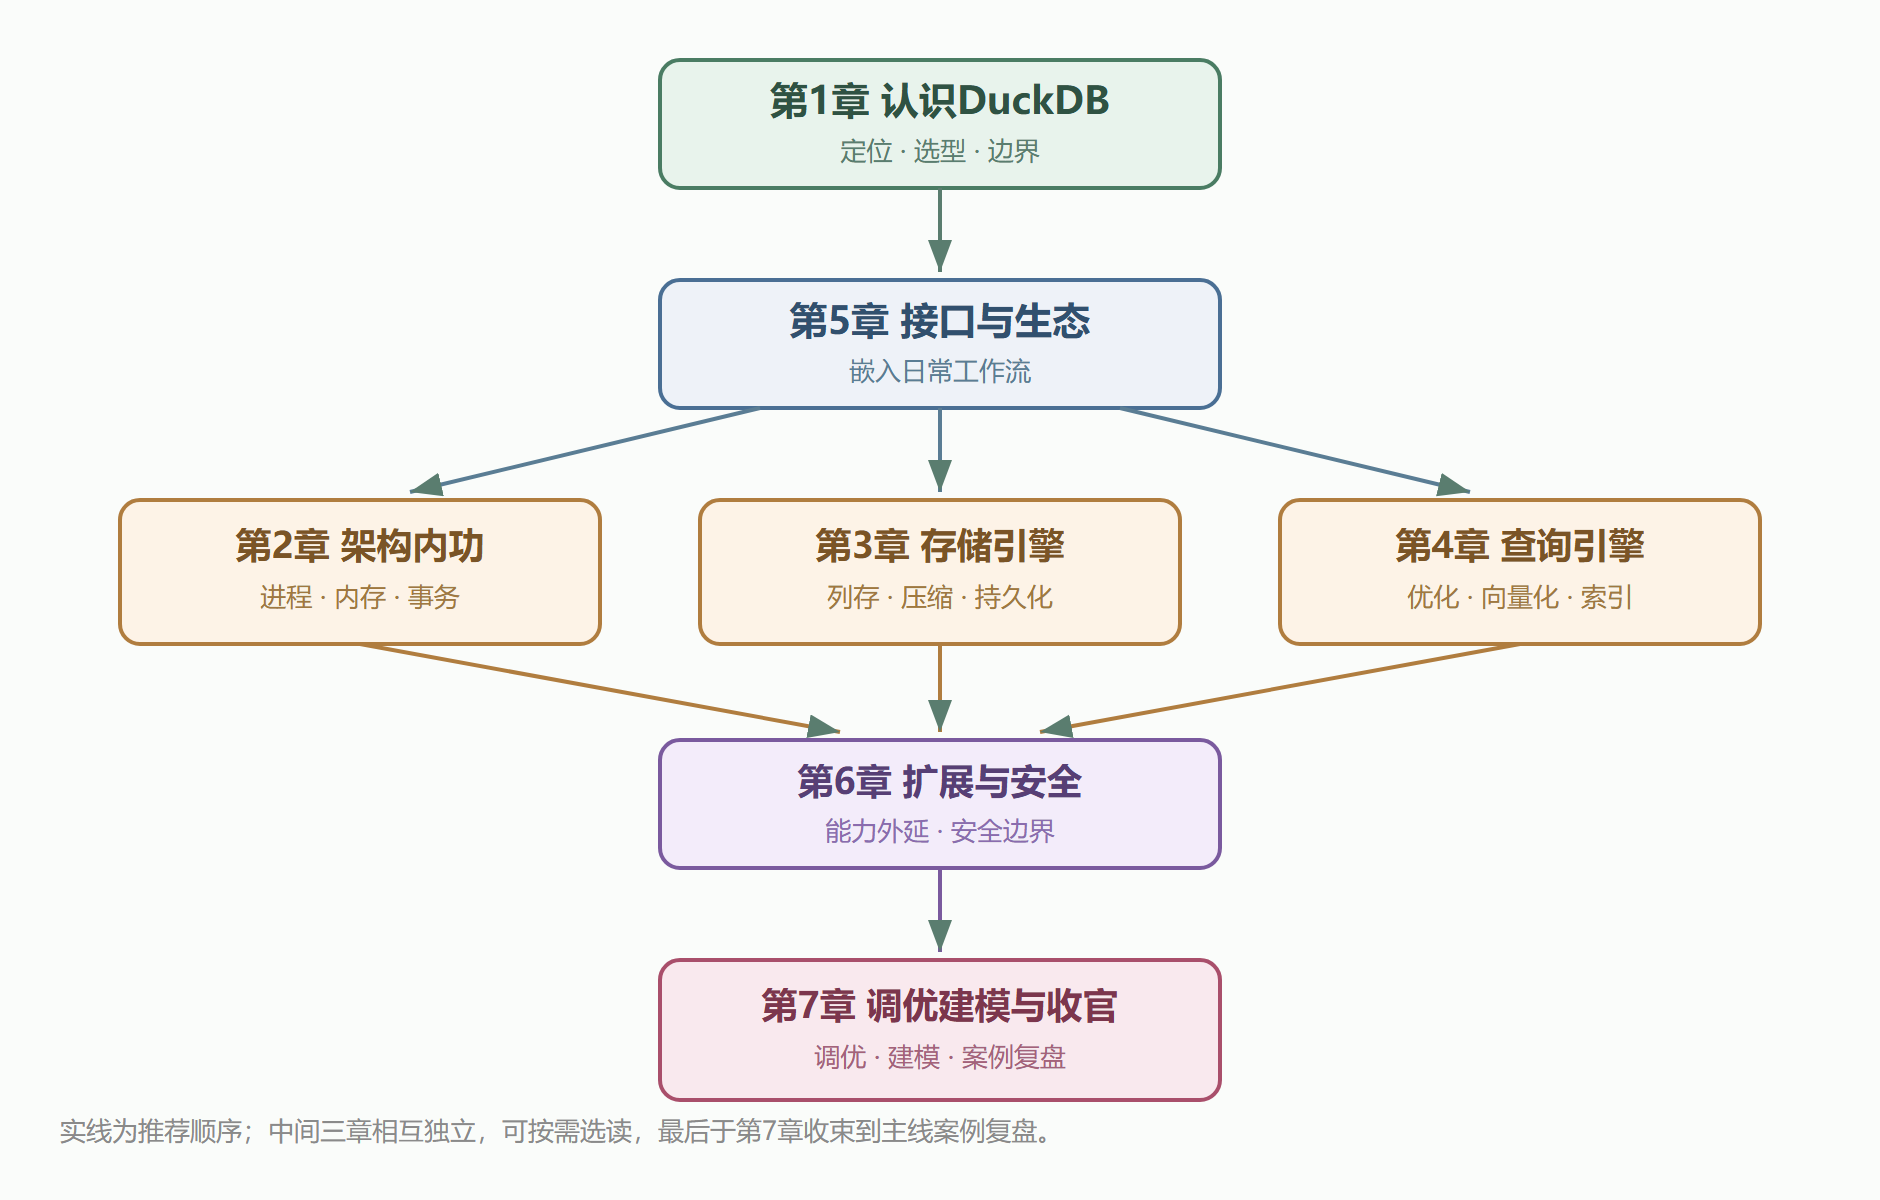
下图是全册的知识地图。第1章是所有人的起点;第5章让工具真正嵌入你的日常;中间三章分别通向内核、存储、执行三个纵深方向,互相独立、可按需选读;第6章建立能力外延与安全意识;第7章收束全书并完成主线复盘。箭头方向即推荐阅读顺序,虚线表示"可跳过但不影响主线"。
图0-1 全册知识地图与章节依赖
适合谁读
做数据分析但常被数据量卡住的分析师;想在应用里内置分析能力、又不想运维一套数据库的后端工程师;想把Pandas工作流提速、又不想引入分布式系统的数据工程师;以及在裸机、边缘设备上做本地化处理的开发者。前置要求只有一条:会基本的SQL。不需要分布式经验,不需要数据库内核背景——需要的那部分,正文会按需讲。
怎么用这本教程
赶时间的读者,走"导读、第1章、第5章、第7章收官"这条短路径,半天就能把主线案例从头跑到尾;想深挖的读者,再按兴趣进入第2至第4章对应的纵深。每章的节首都会点明它承接哪里、通往哪里,你不会迷路。书中的SQL示例都在命令行或Python接口里可直接验证,建议边读边跑:分析这件事,看会了不算会,跑通了才算。
还有一个建议:把主线案例当成自己的案例。找一份你手头真实的数据文件,跟着每一章的操作走一遍——清洗时想想第3章的文件格式取舍,变慢时翻第4章的会诊方法,溢出时对照第2章的排错实录。课程结束的标志,不是读完全部章节,而是你能对一份陌生数据独立地给出结论,并说清这个结论为什么可信。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...