3.4 直查CSV、Parquet与远端文件
3.4 直查CSV、Parquet与远端文件
本节摘要:DuckDB 可以不导入直接查询 CSV、Parquet,乃至对象存储上的远端文件。本节过一遍三类文件读取的关键参数,给出三种格式的取舍矩阵,并替主线案例做出"数据栖身之所"的最终决策。
不导入也能查,但要分清代价
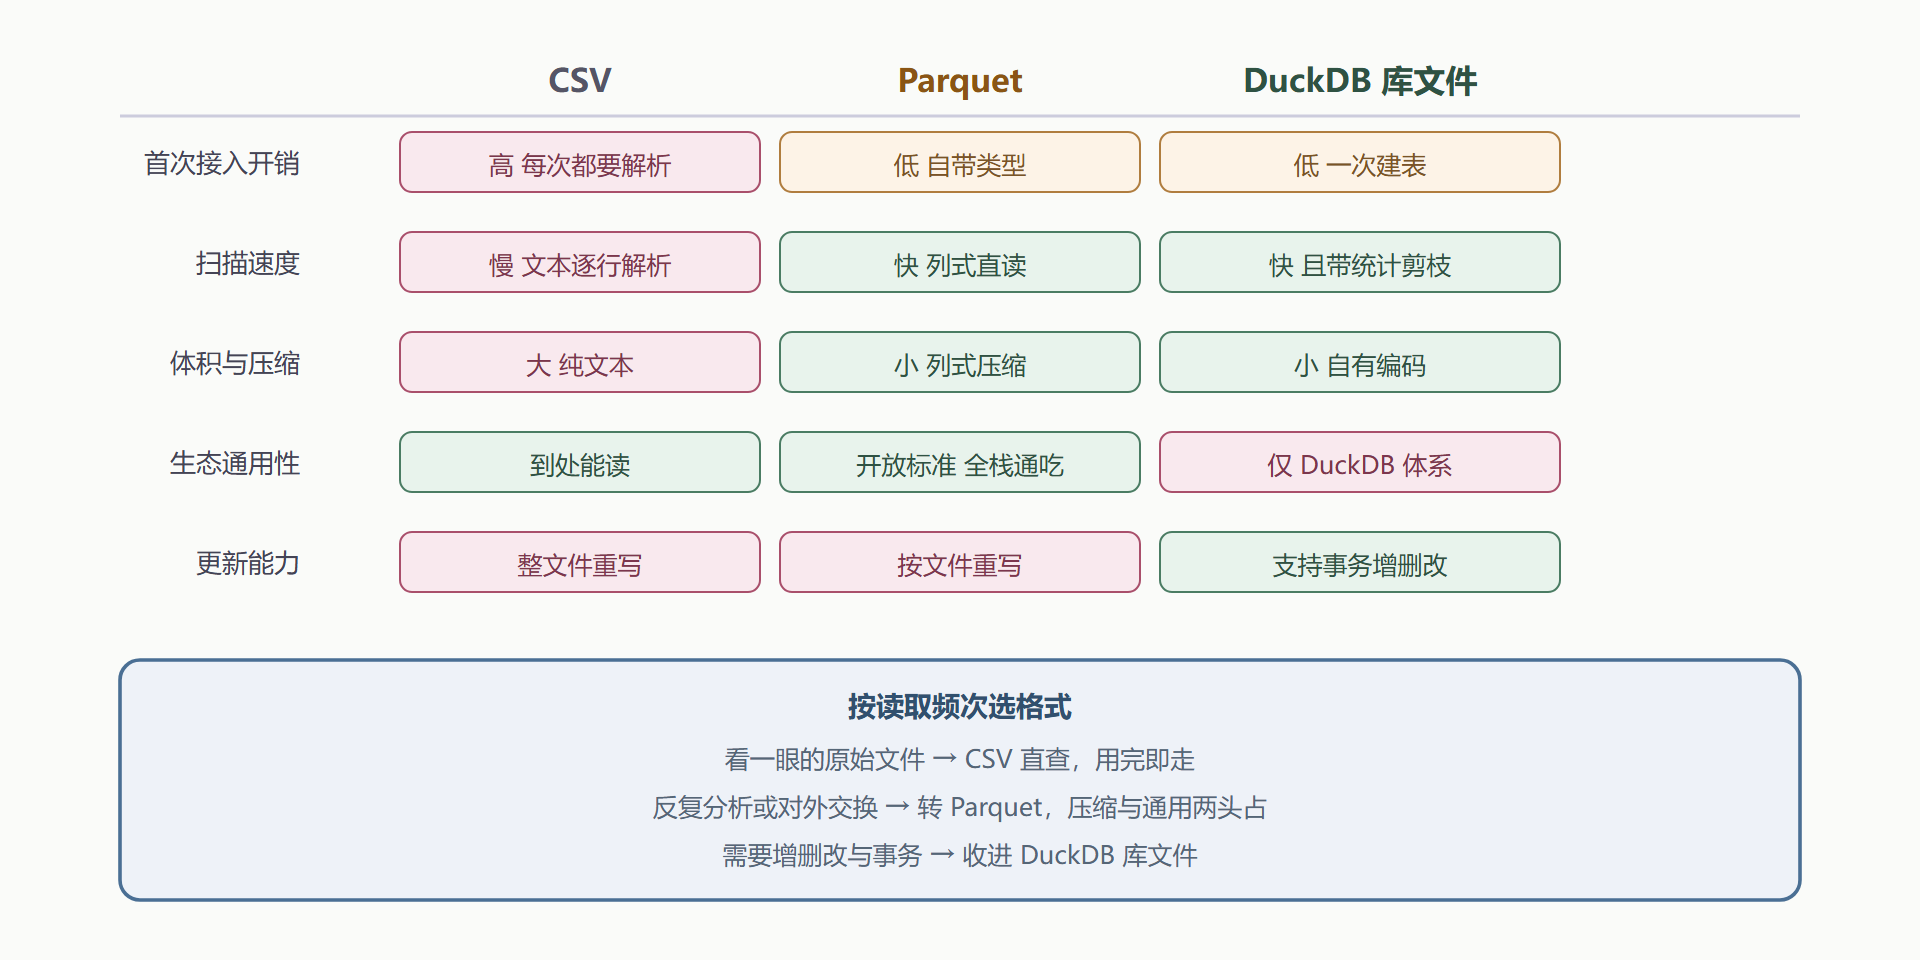
"直接查文件"是 DuckDB 最出圈的特性,但它不是魔法:查 CSV 时,引擎要现场嗅探分隔符、推断每列类型、解析文本——这些开销每次查询都要付。查 Parquet 时则轻快得多:文件自带列式布局、类型和压缩,扫描直接走列式路径。同一个查询,CSV 版慢上几倍是常态。所以正确的姿势不是"永远直查",而是按读取频次选格式:看一眼的文件直查,天天查的文件转格式。
CSV 直查的参数功夫
自动嗅探能应付大多数规整文件,但生产数据总有意外:类型猜错、编码混杂、脏行混入。这时显式声明是唯一可靠的姿势:
-- 嗅探失灵时,显式声明列与类型 SELECT * FROM read_csv('trades_full.csv', header = true, columns = { 'user_id': 'BIGINT', 'amount': 'DECIMAL(12,2)', 'status': 'VARCHAR', 'trade_time': 'TIMESTAMP' }); -- 全列按文本读入,类型问题留到 SQL 里处理 SELECT * FROM read_csv('trades_full.csv', all_varchar = true); -- 脏行不整体报错,跳过并留下记录 SELECT * FROM read_csv('trades_full.csv', ignore_errors = true, store_rejects = true);
三个技巧各有适用场景:显式列声明用在类型敏感的入库环节,杜绝"金额变文本"这类事故;全文本读入用在探索阶段,先看数据再定类型;跳过脏行用在已知文件有瑕疵、要尽快拿到主体的场合——但事后一定要回查被跳过了什么,别让静默跳过变成数据黑洞。
Parquet:中间格式的默认答案
Parquet 是列式的开放标准:自带类型、压缩与统计信息,几乎所有数据工具都能读写。对 DuckDB 而言它是最合身的输入——扫描器可以直接利用文件内的列布局和统计做裁剪。支持通配符批量读取和目录分区,让"按年月分目录存 Parquet"成为单机数仓的经典布局:
-- 通配符一次读整个目录 SELECT count(*) FROM read_parquet('archive/trades/*.parquet'); -- 目录名即分区列(hive 布局),查询时自动可用 SELECT 年, count(*) FROM read_parquet('archive/trades/year=*/month=*/*.parquet', hive_partitioning = true) GROUP BY 年;
分区布局的收益与列存一脉相承:查询只要近三个月,扫描器按目录路径直接跳过其余年份的文件——文件级的剪枝,比行组级更粗但更便宜。两级剪枝叠加时还有个组合技巧:目录按大粒度切(年、月),行组排序按细粒度排(时间、设备),查询先跳目录再跳行组,两级都命中时扫描量可以压到全量的千分位。设计分区粒度时反过来用它:如果最常见的查询总是落在固定时间窗,就把目录粒度对齐那个窗口——分区切得准,胜过任何扫描侧的优化。
远端文件:对象存储上的直查
装上 httpfs 扩展后,Parquet 可以放在对象存储或任意可寻址的服务端上直查。引擎把"读哪些字节段"的请求发过去,只取相关列段——配合 Parquet 的列式布局,远端传输量可以压缩到很小。这是"单机分析 + 云端存储"的组合:数据不必下载到本地,分析仍在你自己的机器上完成:
INSTALL httpfs; LOAD httpfs; -- 远端 Parquet 同样支持通配符与分区 SELECT count(*) FROM read_parquet('s3://my-bucket/trades/2024/*.parquet');
用这套打法要留意两笔隐含成本:远端请求有延迟,小文件太多会碎在请求开销上(按上百MB量级组织文件更合算);公网带宽按量计费,反复全表扫描远端文件的账单会教育你"把常用的先落到本地"。
图3-3 三种格式的取舍矩阵
主线案例的栖身决策
三种格式在主线案例里各就各位:上游原始文件保持 CSV,作为不可变的原料留档;清洗后的工作表收进 DuckDB 库文件,享受事务与统计;季度归档导出 Parquet,既给其他团队的工具直接用,也为"换台机器继续分析"准备好行囊。三种格式不是三选一,而是数据生命周期三个阶段的三个容器。这套组合还有一个隐性收益值得点名:留档的原料永不污染。无论清洗逻辑怎么改版,原始 CSV 原样躺在门外——第5.4节对账、第7.4节复盘都能回到同一份起点。数据工作里最贵的不是存储,是"原始数据被覆盖后再也回不去"的那种悔恨,三个容器的分工恰好把这种悔恨从结构上排除了。
嗅探器什么时候会猜错
自动嗅探的判定规则值得认识几条,猜错的场景就都解释得通了。它按采样推断类型与分隔符,于是三类数据最容易翻车:值域跨界的列——前一万行金额都规整,第一万零一行出现"1,234.50",嗅探降级成文本;字段内含分隔符的列——备注里混着逗号,方言没有引号包裹时整行错位;真假难辨的数字串——手机号、邮政编码被认成整数,前导零凭空消失。防线就是上一节的显式声明,而侦察手段是先用全文本模式看一眼再定:
-- 侦察三连:类型、脏行、空值规模 DESCRIBE SELECT * FROM read_csv_auto('new_batch.csv'); SELECT count(*) FROM read_csv('new_batch.csv', store_rejects = true); SELECT count(*) - count(amount) AS 金额空值数 FROM read_csv_auto('new_batch.csv');
把这三条跑成接新文件的标准动作,嗅探翻车就从"交付事故"降级为"十分钟的技术处理"。第5.2节方言体检、第7.3节静默陷阱清单里反复出现的那条原则——类型问题宁可报错不要静默——在本节的完整形态就是:嗅探结果必须过目,不能默认正确。
为什么不干脆全转库文件
一个自然的疑问:既然库文件最快,为什么不全转进去、留 CSV 在门外?因为三种容器的维护成本不同。库文件里的表要跟着上游变更走——上游加列、改口径,你这边要重建、要对账、要刷下游视图,这些同步工作在"天天查"的场景里值回票价,在"一年看两次"的场景里是纯负担。直查则天然免疫上游结构漂移:文件换了,下次查询自动读新版。所以栖身决策的完整版还要加上上游稳定性这个维度:结构稳定的高频数据收进库,结构漂移的低频数据留门外直查,中间地带转 Parquet——它对结构变更的容忍度介于两者之间(换掉单个分区文件即可)。生命周期加变更频率,两个维度合起来,才是这张取舍矩阵的完整用法。
本节要点回顾
- 直查有代价:CSV 每次付解析税,Parquet 自带布局直读;频次决定格式。
- CSV 参数三招:显式列保类型、全文本先探索、跳脏行后回查。
- Parquet 是中间格式默认解:分区目录加通配符,构成单机数仓的经典布局。
- 远端直查省下载不省带宽:按上百MB组织文件,常用数据落本地。