6.1 扩展系统与常用扩展
6.1 扩展系统与常用扩展
本节摘要:扩展是 DuckDB 的能力货架:内核精瘦,远端文件、地理、全文检索等能力按需装载。本节讲清装载模型——安装与加载两步、静态与动态之分、离线环境的处理——并给出常用扩展速查与选型注意。
承接第5章的缺口
第3.4节直查远端 Parquet 时,命令悄悄用到过一个前提:httpfs 扩展已在场。当时一笔带过,本节把这个机制摊开。要理解扩展的定位,先看一个对比:传统数据库的功能边界在安装时定死,装一个插件常常要动服务端配置甚至重启实例;DuckDB 长在你的进程里,不可能"重启服务",所以它的扩展模型必须是会话级、秒级、零重启的——这正是嵌入式哲学在能力维度的延伸。
装载模型:两步走
扩展的装载分两步。INSTALL 把扩展产物下载到本地的扩展目录,这一步只需做一次;LOAD 把它加载进当前会话,每次开新会话要重新执行,毫秒级完成。安装来源默认是官方扩展仓库,产物带签名,加载时引擎会校验,防的是产物被篡改:
-- 安装一次:下载到本地扩展目录(默认按版本分目录存放) INSTALL httpfs; -- 每个会话加载一次:毫秒级,无需重启任何东西 LOAD httpfs; -- 之后远端对象存储的文件与本地文件待遇相同 SELECT count(*) FROM 's3://lake-bucket/trades/2024q3/*.parquet';
两个省心细节。其一,部分扩展走自动加载:查询碰到 Parquet、JSON 这类格式时,引擎发现内置支持不在场会自动装载对应扩展,你甚至感知不到过程——直查 CSV、Parquet 之所以"开箱即用",背后是这套机制。其二,显式 INSTALL 也可以不带网络:从本地文件安装(INSTALL 后跟本地路径形式产物)在隔离环境里是标准做法,公司内网常把官方产物放进制品库统一分发。
版本匹配值得一句警告:扩展产物与内核版本绑定,升级内核后旧扩展目录里的产物要跟着重装。遇到"LOAD 报版本不兼容",第一反应就是删掉扩展目录重装,而不是反复重试。
静态与动态:能力从哪来
按来源,能力分两类。静态内置:SQL 解析、列式存储、Parquet 与 CSV 读写、JSON 函数这些高频能力直接编译进内核,随主包分发,不求人。动态扩展:低频或带重依赖的能力做成独立产物。这样切分的逻辑是频率与体积——把"人人都要"的留下,把"一部分人要"的搬出去,内核二进制才能维持在几十兆的量级(第1.1节设计哲学的又一处落点)。
图6-1 能力货架:内核与扩展的分界
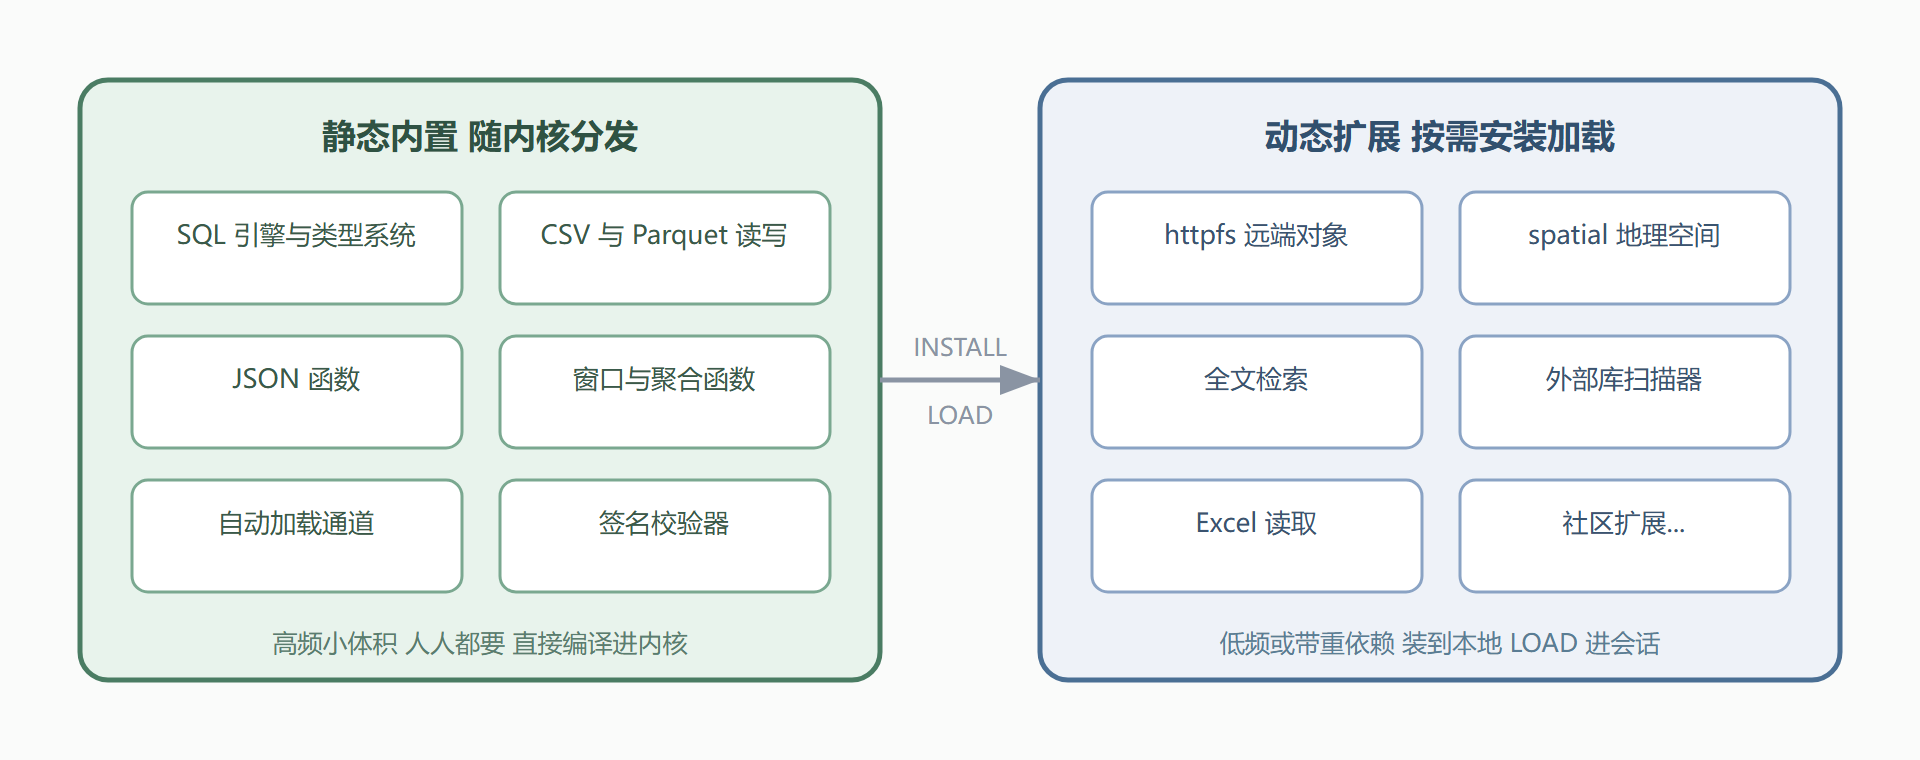
左边一格是出厂自带,右边一格是货架。分界不是永久的:某个扩展用的人多了、做小了,下个版本可能被收编进内核;反之内核也会主动瘦身。判断"某个能力要不要 LOAD"最可靠的办法不是背清单,而是遇到 Catalog Error 时先想"这可能是个没加载的扩展"。
常用扩展速查与选型
下面这张速查表按需求场景组织,覆盖日常九成场合。 名称后面附一句"什么时候想起它":
| 需求场景 | 扩展 | 一句话记忆点 |
|---|---|---|
| 直查 HTTP 或对象存储上的文件 | httpfs | 远端文件当本地文件查,配凭证后查 S3 |
| 直连业务库抽数 | postgres_scanner、mysql_scanner | ATTACH 外部库,跨源 JOIN 不落盘中转 |
| 读 SQLite 或 Excel 老文件 | sqlite_scanner、excel | 历史数据迁移的第一站 |
| 地理边界、距离、空间 JOIN | spatial | 地理列类型与空间函数全家桶 |
| 按关键词搜文本列 | full_text_search | 建倒排索引,中文场景配合分词思路使用 |
| 排序规则与时区 | icu | 多语言排序与时区转换的底座 |
选型时三个注意。优先官方维护:官方仓库里的扩展随版本测试,社区扩展质量参差,进生产前自己过一遍测试。看清依赖方向:外部库扫描器在你进程里直连业务库,连接池与网络延迟都发生在分析进程一侧——抽数走它,别让它顶在线查询。远端查询先算账:httpfs 让远端查询变得太容易,容易到忘了网络带宽才是瓶颈;大表先按分区裁剪(第3.1节的行组思想对远端 Parquet 同样生效),只把需要的行组拉过网。还有一条不成文的习惯:装完顺手验一次——LOAD 之后跑一条最小的试探查询,确认能力真的在场,别把验证留给正式任务的第一条大查询。
主线案例的扩展痕迹
回头看,主线案例其实用到了两个扩展:httpfs 负责把上一季度存档在对象存储的 Parquet 拉回来对账,excel 扩展在业务方坚持发旧格式报表时救过一次场。两次都是"装一次、用一天"的轻量介入——这正是扩展模型的日常形态:它不改变你的工作流,只在需要的一瞬间补上缺口。如果你在复盘主线时想验证这一点,打开分析库查一眼已加载的扩展列表即可——会发现全程没有第三个扩展出场。扩展用得少不是遗憾,是健康:大多数分析工作就该由静态内置的能力包圆,扩展只在射程之外的现实需求出现时才值得动用。
离线与内网环境怎么过
企业环境里最常见的拦路虎是"安装要联网"。三条路按推荐顺序排。制品库中转:在有网的机器上 INSTALL 一次,把本地扩展目录里的产物目录整个拷进内网制品库,再在目标机器上指回本地路径安装——产物是带签名的完整文件,搬家不影响校验。镜像源:把官方扩展仓库整站镜像到内网,所有开发者的 INSTALL 自动走内网地址,适合团队规模稍大的场合。预装分发:把常用扩展产物直接打进基础镜像或环境包,新环境开箱即有。三条路共同的忌讳是"临时找个人用浏览器下载产物文件再传进来"——来源不明的产物绕过了签名校验的信任链,安全上省的每一分钟都是欠账。
扩展目录的位置与会话级配置有关,需要统一管理时把它指向一个共享路径,团队就能共用同一份产物缓存,版本升级也只动一处。
FAQ:两个高频疑问
装了扩展会不会拖慢日常查询?
不会。LOAD 只是把函数与类型注册进目录,不参与无关查询的执行路径;没加载的扩展更是零开销。真正要留意的反而是"忘了加载"——换台机器、换层代理脚本,LOAD 没跟上,查询报函数不存在。所以脚本化的分析流程里,把 LOAD 语句写在流程开头,当成依赖声明的一部分。
怎么知道一个能力该找哪个扩展?
从报错倒推最快:Catalog Error 提到的函数名,多半就是扩展提供的函数名,拿它对照第6.1节的速查表或文档目录基本一击即中。反过来从需求出发也行:先想清楚数据在哪(远端、外部库、旧格式文件)、要做什么(空间计算、文本检索),再按"数据形态加操作类型"两个关键词去找,比按功能列表漫翻高效得多。
下一节往货架深处走:如果货架上没有你要的能力,6.2节给出从一行 Python 装饰器到完整 C++ 扩展的三级阶梯。
本节要点回顾
- 两步装载:INSTALL 落本地一次即可,LOAD 进会话每次执行,毫秒级零重启。
- 静态与动态的分界看频率与体积,自动加载让高频格式无感知。
- 版本绑定:升级内核后扩展目录要重装,LOAD 报不兼容先想到这一层。
- 速查表按场景记忆:远端 httpfs、抽数扫描器、地理 spatial、检索全文。
- 远端查询先裁剪:行组剪枝对远端 Parquet 生效,别把带宽当免费。