6.3 安全与权限
6.3 安全与权限
本节摘要:嵌入式数据库没有账号体系,信任边界就是进程边界——谁能跑你的 Python,谁就能读你的库。本节给出画边界的三个开关(外部访问、配置锁定、只读),讲清读不可信文件的约束清单,也把"数据不出本地"这个嵌入式架构的安全红利讲足。
先换脑子:边界不在数据库,在进程
用惯服务端数据库的人,会下意识地在 DuckDB 里找用户、角色、授权语句——找不到,因为它根本没有那一层。这不是缺失,是架构的必然结果:数据库长在你的应用进程里(第2.1节),它做的每一次文件读取,权限上等同于你的应用自己在读。于是安全模型的重心整体位移:管好谁能启动这个进程、这个进程被允许做什么,比在数据库内部设防更对症。
这个位移有失也有得。失的是精细授权——同一份库文件没法对 A 开放三张表、对 B 开放一张;得的是攻击面同步缩小:没有网络端口就没有远程爆破,没有 SQL 网关就没有注入直达数据库的路径,凭证体系简化成"文件系统权限 + 进程准入"两件事。
画边界的三样工具
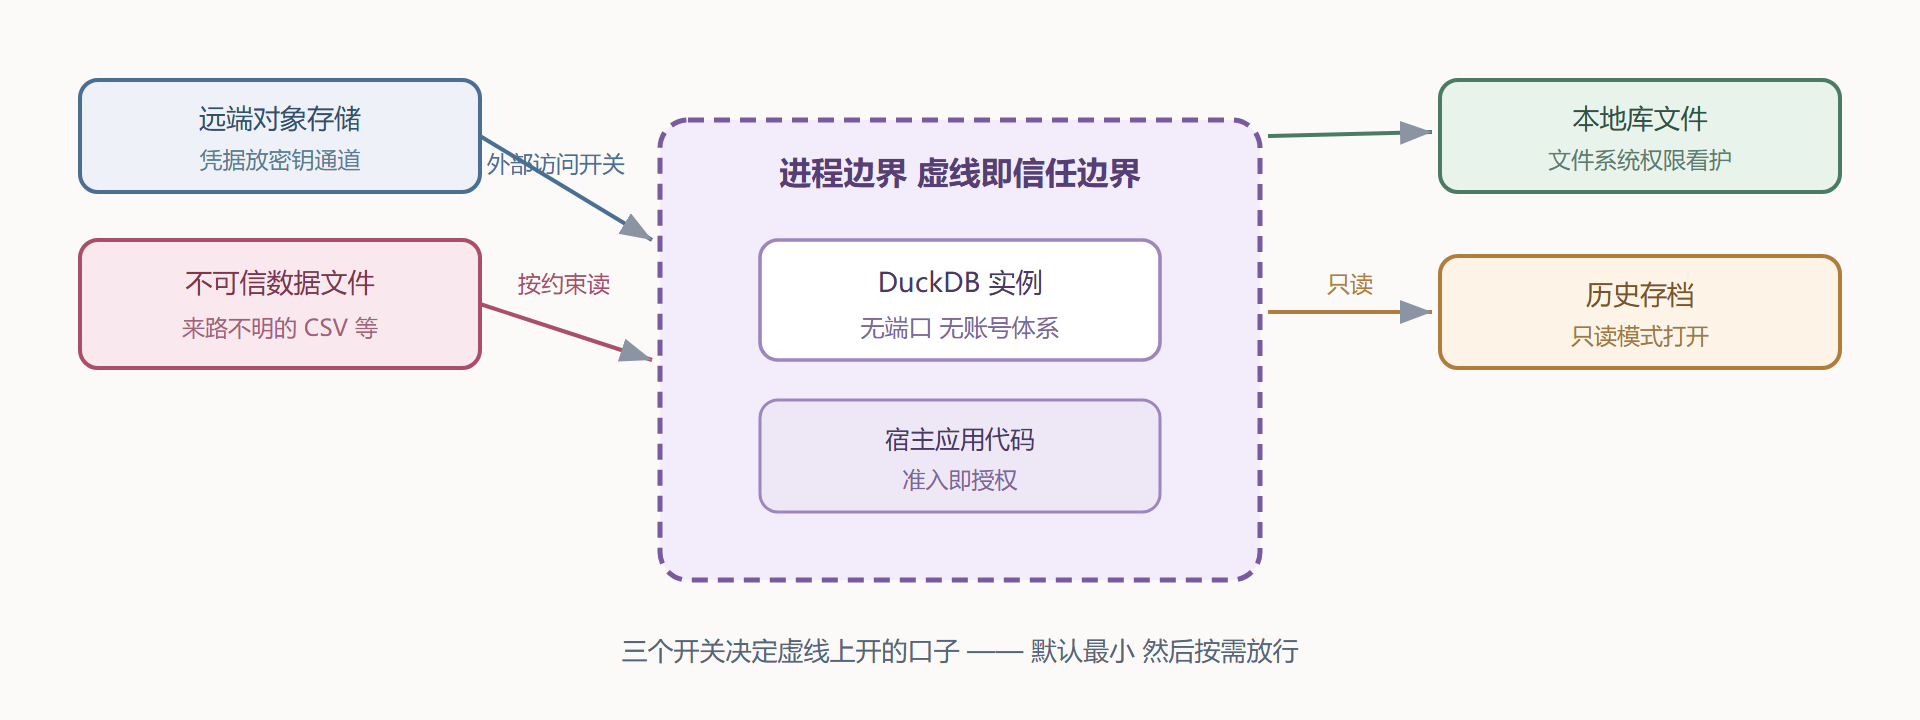
DuckDB 把边界控制做成了三个开关,粒度不同、叠加使用。外部访问开关管进程能伸手到多远——关掉之后,文件系统访问、HTTP 请求、扩展加载全部拒绝,只留内存库和已attach的库内数据;适合"这段代码不可信,但我要用它跑分析"的场景。配置锁定管会话内还能不能改主意——锁定后任何 SET/PRAGMA 都失效,防止"分析代码里顺手开个外部访问"这类口子。只读打开管误写——碰历史存档时用只读模式,物理层面杜绝误删误改:
-- 场景一:跑来路不明的分析脚本,先断它的手脚 SET enable_external_access = false; -- 场景二:锁死配置,会话内不可再改 SET lock_configuration = true; -- 场景三:只读打开历史库,误操作伤不到它 -- Python 侧: duckdb.connect("archive.duckdb", read_only=True)
三个开关的适用阶段不同:外部访问与锁定要在会话早期设,晚了等于没设;只读是打开时的属性,写进连接参数。把这三样组合进代码模板——不可信代码用"关外部加锁",审核工作用"只读"——多数嵌入式场景的边界需求就覆盖了。
图6-3 信任边界的三个开关与数据流向
读不可信文件的约束清单
CSV、Parquet、JSON 的解析器都是复杂软件,历史上各家的解析器都修过溢出与越界类漏洞,DuckDB 也不例外。把"读不可信文件"从警告落成约束,操作上就四条。其一,版本跟紧:解析器漏洞的修复随版本发布,嵌入式引擎升级只是换个包,没有理由停在旧版。其二,先侦察后解析:拿到来路不明的文件,先看文件头与大小、用行数限制的查询试探列结构,别一上来全量读。其三,不可信代码配最小开关:外部访问关掉、配置锁死,文件从白名单目录读。其四,重要环境做隔离:生产分析进程与日常办公环境分开,容器或独立账号跑不可信数据的处理,出了事有边界可守。
还有一类"软风险"比漏洞更常见:嗅探器的静默误判。第7.2节陷阱清单里会展开——类型嗅探把脏列读成 VARCHAR 不报错但结果错。安全清单里把它归入"数据完整性"条目:不可信文件的可信度问题,不只发生在"读崩了",更发生在"读歪了"。
红利这一面:数据不出本地
把安全讲完,别忘了嵌入式架构最大的安全红利:敏感数据根本不用离开它的机器。医疗影像在科室工作站上直接聚合,财务明细在财务笔记本里出报表,日志在网关设备上本地预聚合——数据不动、计算过去的模式,天然规避了传输泄露与集中存储两个风险源。对受合规约束的行业,这一条常常就是选型的决定性理由。换一个角度说,传统架构里"把数据搬到计算所在的地方",搬运路径上的每一跳都是暴露面;嵌入式把这趟搬运整个取消了。配套的凭证管理也简单:远端对象存储的密钥走会话内的密钥对象注入,不落查询文本、不进日志:
-- 凭证进密钥对象,不写进查询、不留在代码里 CREATE SECRET s3_cred ( TYPE s3, KEY_ID '访问键标识', SECRET '访问密钥' );
敏感数据的落地清单
"数据不出本地"的红利要配上纪律才成立,四条清单把红利坐实。库文件当敏感资产对待:它包含全部数据的明文列存,文件系统权限、磁盘加密、备份加密都按最高敏等级走——很多人对数据库文件的态度比对导出的 Excel 松弛,恰恰反了。临时文件别忘了:溢出目录、导出文件、笔记本里的中间 DataFrame,都是数据的"影子副本",清理策略要覆盖它们。密钥与数据分离:远端访问的凭证放在密钥通道(上节的密钥对象),代码仓库里永远不出现真实键值。共享靠产物不靠源:给同事交付分析结果时,交聚合后的产物表或图,不交原始库文件——既控制了数据扩散面,也让口径有唯一出处。
团队形态下还有一问:多人共读怎么办。答案延续第2.3节的单写者模型——一份库文件一个写进程,其余人只读打开;读多写少的团队可以把库文件按天快照分发,人人读自己的只读副本,写者次日合并。这套"读副本、单写者"的土办法,撑起几十人规模的分析协作绰绰有余,而且不需要任何额外组件。
三个开关的组合拳示例
把三样工具放进一个真实处境里跑一遍,比单看语法更清楚。处境:分析脚本来自外包团队,要处理一份带个人信息的明细,跑在本机的独立账号下。配置顺序四步。第一步,独立账号与目录——进程准入先行,操作系统层面把这段分析与日常环境隔开。第二步,会话开头读入白名单目录的文件、ATTACH 目标库,然后再设外部访问为假——注意顺序:外部访问一关,连白名单也读不了,所以正确姿势是先读入、后关闭。第三步,锁死配置,防止脚本运行中途自己打开口子。第四步,产物只出聚合层——外包团队看到的永远是聚合后的结果,明细留在隔间里。四步里没有一步用到"高深"的安全技术,全是顺序与纪律——嵌入式安全的实践形态本来就更接近操作规程,而不是密码学。
何时该考虑换掉嵌入式形态
诚实的安全评估也包括承认边界。三种信号出现时,嵌入式形态可能不再是正确答案:合规方明确要求集中审计每一条数据访问(嵌入式没有审计日志层,得靠进程外手段拼凑);多人高频并发写同一份数据(单写者约束变成业务瓶颈);数据量大到单机内存加 SSD 都捉襟见肘(溢出频繁到抵消列存红利)。三种信号都不是"危险",只是"形态错配"——这时候把分析下沉到服务端数仓、终端保留 DuckDB 做最后一级交互,是常见的混合架构。形态选择本来就是第1章的话题,本节只是把安全维度的判据补齐。
至此"what 与 why"全部讲完。第7章收官:调优清单、表设计取舍、报错解码,最后主线案例完整复盘。
本节要点回顾
- 边界即进程:没有账号体系不是缺陷,安全重心移到进程准入与开关控制。
- 三样工具分阶段:外部访问与锁定设在会话早期,只读是打开时属性。
- 不可信文件四条约束:版本跟紧、先侦察后解析、最小开关、环境隔离。
- 最贵的错是读歪不是读崩:嗅探静默误判归入完整性风险。
- 数据不出本地是红利:合规敏感场景的选型决定性理由,凭证走密钥对象。