7.1 性能调优策略
7.1 性能调优策略
本节摘要:调优不是调参数,是按"配置、写法、布局"三层依次排除的过程:先确认资源给够,再确认查询写对,最后才是物理布局手术。本节给每层配备观测手段、典型动作与止损判据,并用主线案例之外的一个对照实验演示完整闭环。
反直觉的起点:先别急着优化
第7章支柱页说本章把手段组织成顺序,本节先立规矩:没有观测就没有优化。多数"调优"时间浪费在改了三样东西、不知道哪样起效上,最后连退路都找不回。所以动手前先固定两件事——基线与计时。同一条查询跑三遍取中位数(第一遍含冷缓存,不代表常态),记下耗时;之后再动任何东西。DuckDB 侧的观测主力是第4.2节教过的 EXPLAIN ANALYZE,加上会话计时:
-- 基线:连跑三遍取中位数,冷缓存那遍不算数 TIMER ON; SELECT date_trunc('day', trade_time), sum(amount) FROM trades_clean WHERE status = 'refunded' GROUP BY 1; -- 观测:计划里找耗时占比最大的算子,而不是猜 EXPLAIN ANALYZE SELECT date_trunc('day', trade_time), sum(amount) FROM trades_clean WHERE status = 'refunded' GROUP BY 1;
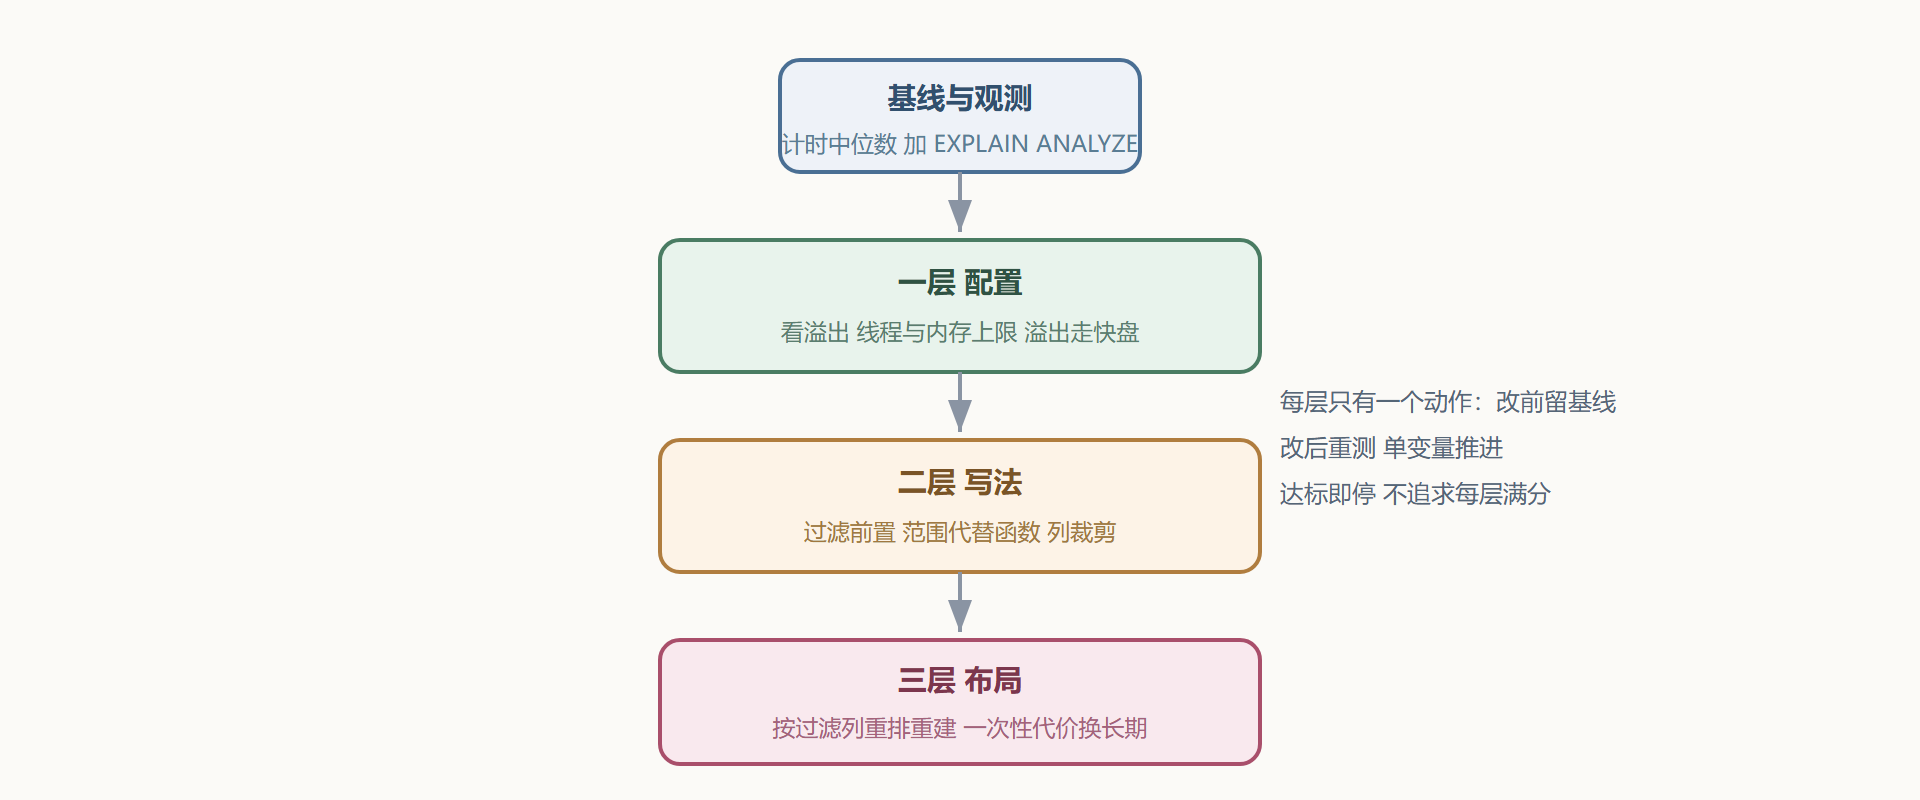
拿到基线后,按下面三层从便宜到贵依次排查。顺序不能倒:布局手术最贵,配置改动最便宜,但多数人凭直觉反着来——先重建表,最后才想起线程数。
第一层:配置——资源给够了吗
配置层回答一个问题:引擎手里的资源与工作负载匹配吗。三个参数承担九成工作。threads 默认取全部核心,通常不用动;但笔记本上与报表进程抢核时,主动降到物理核数反而更稳。memory_limit 默认取物理内存的大头,第2.2节讲过引擎会溢出落盘而不是崩——所以这个参数配小了的表现不是报错,是悄悄变慢:溢写与回读都走磁盘。temp_directory 决定溢出到哪:默认设在库文件旁边,若那块盘是机械盘,溢出代价翻倍,指向 SSD 是一行配置的事:
SET threads = 4; -- 与其他负载共处时主动让路 SET memory_limit = '6GB'; -- 容器或共享环境里显式划界 SET temp_directory = 'D:/ssd_tmp/'; -- 溢出去快盘
配置层的止损判据:如果计划里出现大量溢出读写字样,先动这一层;如果计划干净、耗时仍长,往上一层走。配置改动即时生效、随会话结束失效,试错成本几乎为零——这是它排在第一位的原因。
第二层:写法——查询本身有没有绕路
写法层检查的是第4章讲过的那些"逻辑等价、成本悬殊"的模式。高频的几个:过滤条件写在连接之后,让千万行白流一趟(第4.5节会诊的第一刀);对列套函数再过滤,让剪枝失效——WHERE year(trade_time) = 2024 改成范围条件,扫描端能跳过整段行组;SELECT 星号拖走用不上的宽列,列存的列裁剪红利全丢。每个模式单独看都是常识,难的是在慢查询里认出它们——所以这一层的固定动作是拿着计划逐算子问:这行的输入行数,能不能在更早一步变小:
-- 反模式:对列套函数,行组剪枝失效 SELECT count(*) FROM trades_clean WHERE year(trade_time) = 2024; -- 等价改写:范围条件,扫描端直接跳过 2024 之外的行组 SELECT count(*) FROM trades_clean WHERE trade_time >= TIMESTAMP '2024-01-01' AND trade_time < TIMESTAMP '2025-01-01';
第三层:布局——数据摆放对不对
前两层都干净还慢,才轮到布局手术:按过滤列重排数据重建表,让 Zone Maps 剪枝真正咬合(原理在第4.4节,实战在第4.5节第三刀)。这一层是"一次性代价换长期收益",动之前确认两件事:查询是反复执行的吗(跑一次的查询不值得);过滤列选对了吗(按最常用的过滤列排,多过滤场景取区分度最高的那列先排)。
图7-1 三层排查的决策路线
一个完整的对照实验
把闭环走一遍。场景不是主线案例,而是一份千万行的传感器读数表:按设备号查最近一小时数据的点查,实测一点八秒。第一层配置:计划无溢出,线程充足,跳过。第二层写法:时间条件已是范围写法,但计划显示扫描端读了全部行组——意识到数据是按采集顺序乱序入库的,时间列在每个行组里跨度极大,剪枝判据失效。这本该是布局手术,但先做个便宜的实验验证假设:取十万行按时间排序后写入临时表,同一查询只跑八十毫秒。假设成立,回到正式表执行重排重建,全表后稳定在两百毫秒内,查询高发时段的资源占用降了一半。整个过程动了两层、四个动作,每步都有前后数字——这份"每步留痕"的纪律,比任何一个单点技巧都值钱。
什么时候别调优
三层路线讲完,补一个反方向的原则:有些"慢"不该由调优解决。一次性任务:只跑一遍的迁移、验证脚本,慢一分钟无人在意,花半小时调优是净亏损。数据量将变:表下个月要翻十倍,今天在当前量级上调出来的参数与布局全是白费——先按目标量级建模(第7.2节),再谈调优。感知问题:业务方嫌"慢",问清楚基准与预期,有时答案是交互设计(加个进度提示)而不是查询耗时。调优的投入应当与查询的复用次数、等待的人力成本成正比——这条定价原则本节不展开,但每次动手前值得默念一遍。
并行度的一个对照实验
配置层的参数值得亲手测一次,建立体感。同样是主线案例的周度聚合,在八核笔记本上从单线程起逐档调 threads,实测大致是这样一条曲线:一到四线程接近线性加速,四到六线程收益骤减,六以上再无变化甚至略有抖动。原因在第2.1节:引擎的并行是数据分片驱动的,千万行的扫描能切出足够的并行度,但聚合与归并阶段的可并行部分先耗尽了——线程加到某个点后,调度开销与内存带宽争用开始抵消收益。这个实验两分钟能做完,价值在于让你对自己机器的拐点有数:之后共线环境里设 threads,你调的不是默认值,是测过的值。把拐点数字写进团队的环境备忘——"这台报表机四线程封顶"——比十个泛泛的参数建议都实用。
顺带把"配置层何时动手"的判据再压实一点:计划里出现溢出读写字样、或会话内存峰值逼近上限,先动 memory_limit 与 temp_directory;多负载抢核(CPU 占用常年满格但查询不多),先动 threads。两种信号都没有,配置层直接跳过,不碰参数是正确答案。
达标即停之外,把"停止"也变成资产:每次调优收工时留三行记录——基线数字、动了哪层、最终数字。三行记录积累起来就是团队的性能台账,下一个遇到同类问题的人直接从你的终点起步。本节要点回顾
- 先基线后动手:三遍取中位数,单变量推进,每步留痕。
- 配置最便宜先动:看溢出信号,threads、memory_limit、temp_directory 三件套。
- 写法层认模式:过滤前置、范围条件替代函数包裹、放弃 SELECT 星号。
- 布局是最后手段:确认查询反复执行、过滤列选对,再付重排的代价。
- 达标即停:调优目标是满足交付,不是压榨到极限。