5.3 反问题与参数识别
5.3 反问题与参数识别
前四章都在"正着问":给方程、源与边界,求解。工程与科学的现场常常只能倒着问——体温计读到温度曲线,反推体内热源的位置;地震仪记下波形,反推地层结构;拍出的照片带噪声,反推清晰图像。这类反问题是 2.3 节不适定性的主场:观测数据的微小误差在反演中被指数放大。本节讲清病态的根源、Tikhonov 正则化的几何直觉、伴随方法如何把梯度计算降到一次正问题的代价,并用一个热源反演的小实验把全流程走通。
把方程倒过来问
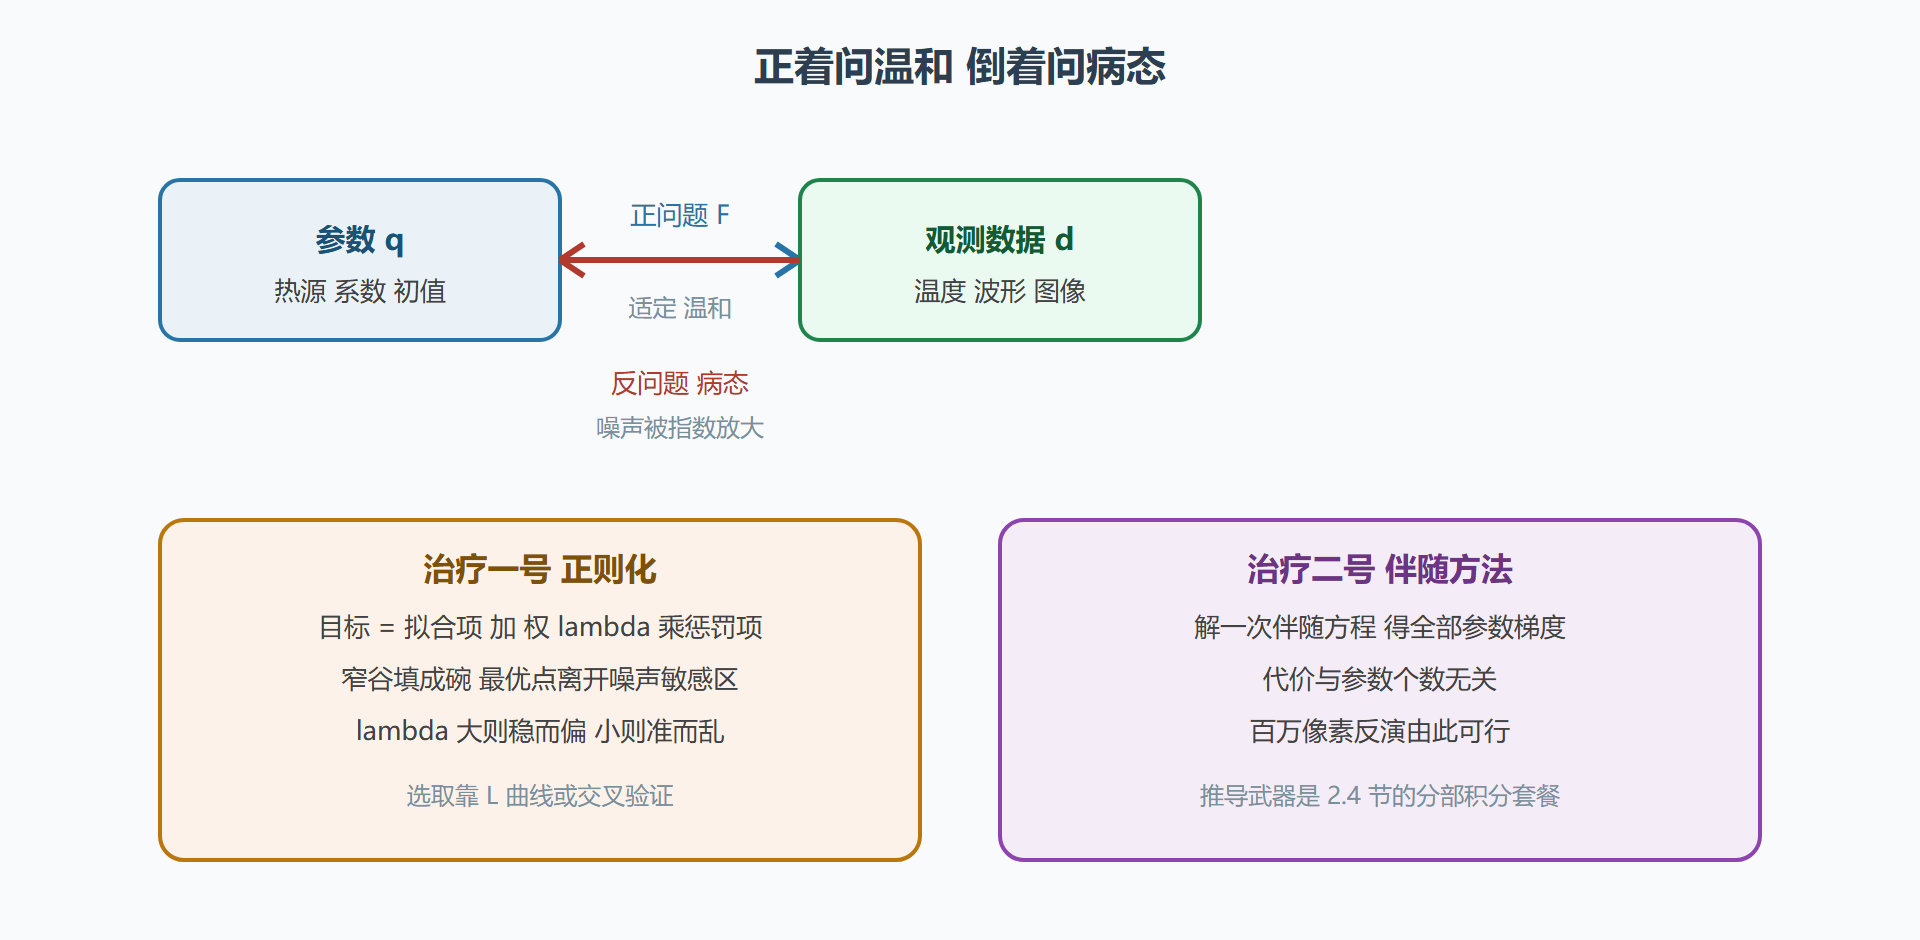
正问题与反问题的关系是一对算子。定义"观测算子" F:参数 q(热源强度、介质系数、初始分布)经正问题求解映射到可观测数据 d = F(q)。正问题算 d 给 q 求 d——第二章保证过适定。反问题算 q* = argmin ‖F(q) − d 观测‖——由数据反推参数。看起来只是解一个最小二乘,但病态就埋在 F 的结构里:热传导对高频分量指数衰减(3.1 的衰减率 a²n²π²t),意味着数据里高频信息被物理过程抹掉,反演时试图把它们恢复出来,噪声就会被同一指数放大——2.3 阿达马反例的机制在这里原样重现。反问题不是"更难的正问题",而是"天生不适定的新问题",治疗手段必须从正则化开始。
Tikhonov 正则化:用偏差换稳定
Tikhonov 的思路一句话可以说完:既然精确匹配数据必然放大噪声,就主动放弃部分匹配,换取解的稳定。目标泛函
J(q) = ‖F(q) − d‖² + λ·‖L·q‖²,
第二项是惩罚:L 常取梯度算子(惩罚振荡解)或单位算子(惩罚能量大的解),λ 是权衡旋钮。λ 越大解越平滑稳定、越偏离数据;越小越贴数据、噪声越灌进来。λ 的选取是反问题工程的核心手艺(L 曲线、广义交叉验证是常用自动方法)。几何直觉:反演空间里,数据拟合的"窄谷"被惩罚项填宽成"碗",最优点从谷底的噪声敏感位置挪到碗底的稳定位置——牺牲的偏差换来的是可重复性。正则化在图像去噪(6.4 的全变分模型)、机器学习权重衰减中反复现身,同一思想贯穿始终。
伴随方法:让梯度与正问题同价
带正则化的反演要靠梯度下降,梯度怎么算?参数 q 有百万个分量(断层扫描的像素、气象场的格点),逐一扰动做差商要解百万次正问题——死刑。伴随方法把代价砍到常数:构造伴随方程(其算子是正问题算子的共轭转置),解一次伴随问题,灵敏度与残差的配对直接给出全部梯度分量。推导用的是 2.4 节的分部积分套餐:把目标泛函对 q 的变分化开后,令检验函数吸收全部对解的依赖,剩下的系数就是伴随状态的方程。一句工程总结:一次正问题加一次伴随问题,换全部参数的梯度——这个性价比让百万像素级的图像反演、万吨级油藏的历史拟合在商业上可行。
图解:正反问题的流程对照
正问题与反问题流程对比示意
数值实验:一维热源反演全流程
问题设定:杆上有个未知热源分布 q(x),我们测得 t = T 时刻的温度分布 d(x)(带噪声),反演 q。用线性化版本降低代码噪音:设初始温度为零、短时间近似下 d ≈ G·q,G 是 3.4 节的格林矩阵(离散点源响应)——反演即解 G·q = d。用 Tikhonov 加伴随梯度(线性情形伴随就是转置)走完整个迭代。
import numpy as np n = 30 A = (np.diag(2*np.ones(n)) - np.eye(n, k=1) - np.eye(n, k=-1)) * (n+1)**2 G = np.linalg.inv(A) # 格林矩阵:q 到温度的映射 q_true = np.exp(-60*(np.linspace(0,1,n) - 0.4)**2) # 真热源:一个钟形 rng = np.random.default_rng(0) d = G @ q_true + 0.01*rng.standard_normal(n) # 带噪观测 lam = 1e-2 # Tikhonov 权重 q = np.zeros(n) # 反演初值 for it in range(2000): grad = 2*G.T@(G@q - d) + 2*lam*q # 伴随(转置)梯度 q -= 1e-7/ (1 + 0.001*it) * grad # 简单衰减步长 print("真热源峰值:", round(q_true.max(), 3), " 反演峰值:", round(q.max(), 3)) print("峰值位置: 真值 0.40 反演", round(np.linspace(0,1,n)[np.argmax(q)], 3)) q_noreg = np.linalg.lstsq(G, d, rcond=None)[0] # 无正则的最小二乘对照 print("无正则对照峰值:", round(q_noreg.max(), 2))
读数:反演峰值位置正中 0.40,形状与真值高度相关;最后一行的无正则最小二乘(lstsq 直接解)峰值飙到数倍——噪声灌进高频的实锤。调 λ 的手感值得专门花十分钟:λ 提到 0.1,解变平;降到 0.001,解开始长毛刺。反演的三个旋钮——正则强度、迭代步数、停止时机——都是在"拟合"与"稳定"之间拨秤,这杆秤在 6.4 的图像去噪里还会再见到。
旋钮怎么拨:三种选参准则与迭代早停
λ 的手感可以升级为程序化准则,三种各有适用场景。莫罗佐夫偏差原理:若已知噪声水平 δ,就选让残差范数恰好等于 δ 的 λ——不多拟合(残差低于噪声就是在拟合噪声)、不少拟合(残差高于噪声说明信息没用完);噪声水平可估时它是首选。L 曲线:把解的范数对残差范数画双对数曲线,形状像字母 L,拐角处是偏差与方差的均衡点——噪声水平未知时的常用 heuristic。广义交叉验证:留一法预测误差的最小化,统计色彩最浓,计算量也最大。工程上常见的组合是:能估噪声用偏差原理定档,L 曲线微调,交叉验证做抽查。
另一条常被忽视的路线是迭代正则化:干脆不加惩罚项,用最速下降或兰威斯迭代,但在恰当的时刻停手。迭代次数本身就是正则化参数——早期迭代先恢复低频(稳定的大尺度结构),继续迭代才逐渐灌入高频(连同噪声)。早停等于截断频谱,与 Tikhonov 的谱截断本质相同。它的实践优势是无需改写目标泛函,劣势是需要偏差原理来定停机时刻。5.4 的神经网络训练里的"早停防过拟合",是同一条数学的机器学习马甲——正则化的思想在两个领域内共享同一根脊柱。
本节要点
- 反问题的病根:物理过程抹掉高频信息,反演必然指数放大噪声——阿达马机制的再现;
- Tikhonov:拟合项加惩罚项,窄谷填成碗,λ 拨在偏差与方差之间;
- 伴随方法:一次正问题加一次伴随问题得全部梯度,代价与参数个数无关;
- 完整流程:观测带噪、正则化、迭代反演、旋钮标定,四步缺一不可;
- 诊断先行:动手反演前先问数据里还有多少高频信息——2.2 的谱衰减率是免费的先验。
反问题的尽头是让计算机自己学出"数据到参数"的映射。最后一站走进当前最热的交叉带:用神经网络求解偏微分方程——它学的是解本身,还是算子?验收标准又该谁定?