5.4 AI 求解偏微分方程
5.4 AI 求解偏微分方程
前沿一章的最后一站是数据进场。2019 年前后,两条机器学习路线先后撞进偏微分方程领域:物理信息网络把方程残差写进损失函数,让网络在"满足数据"与"满足方程"之间找平衡;神经算子不再学单个解,而是学"从输入函数到解函数"的映射本身。五年过去,两条路线的能力边界已经清晰:它们在特定场景高效,在多数正问题上还追不上传统求解器。本节讲清两条路线的原理,并坚持本册的立场——用第四章的数值标尺给网络验收。
让网络把残差当作业
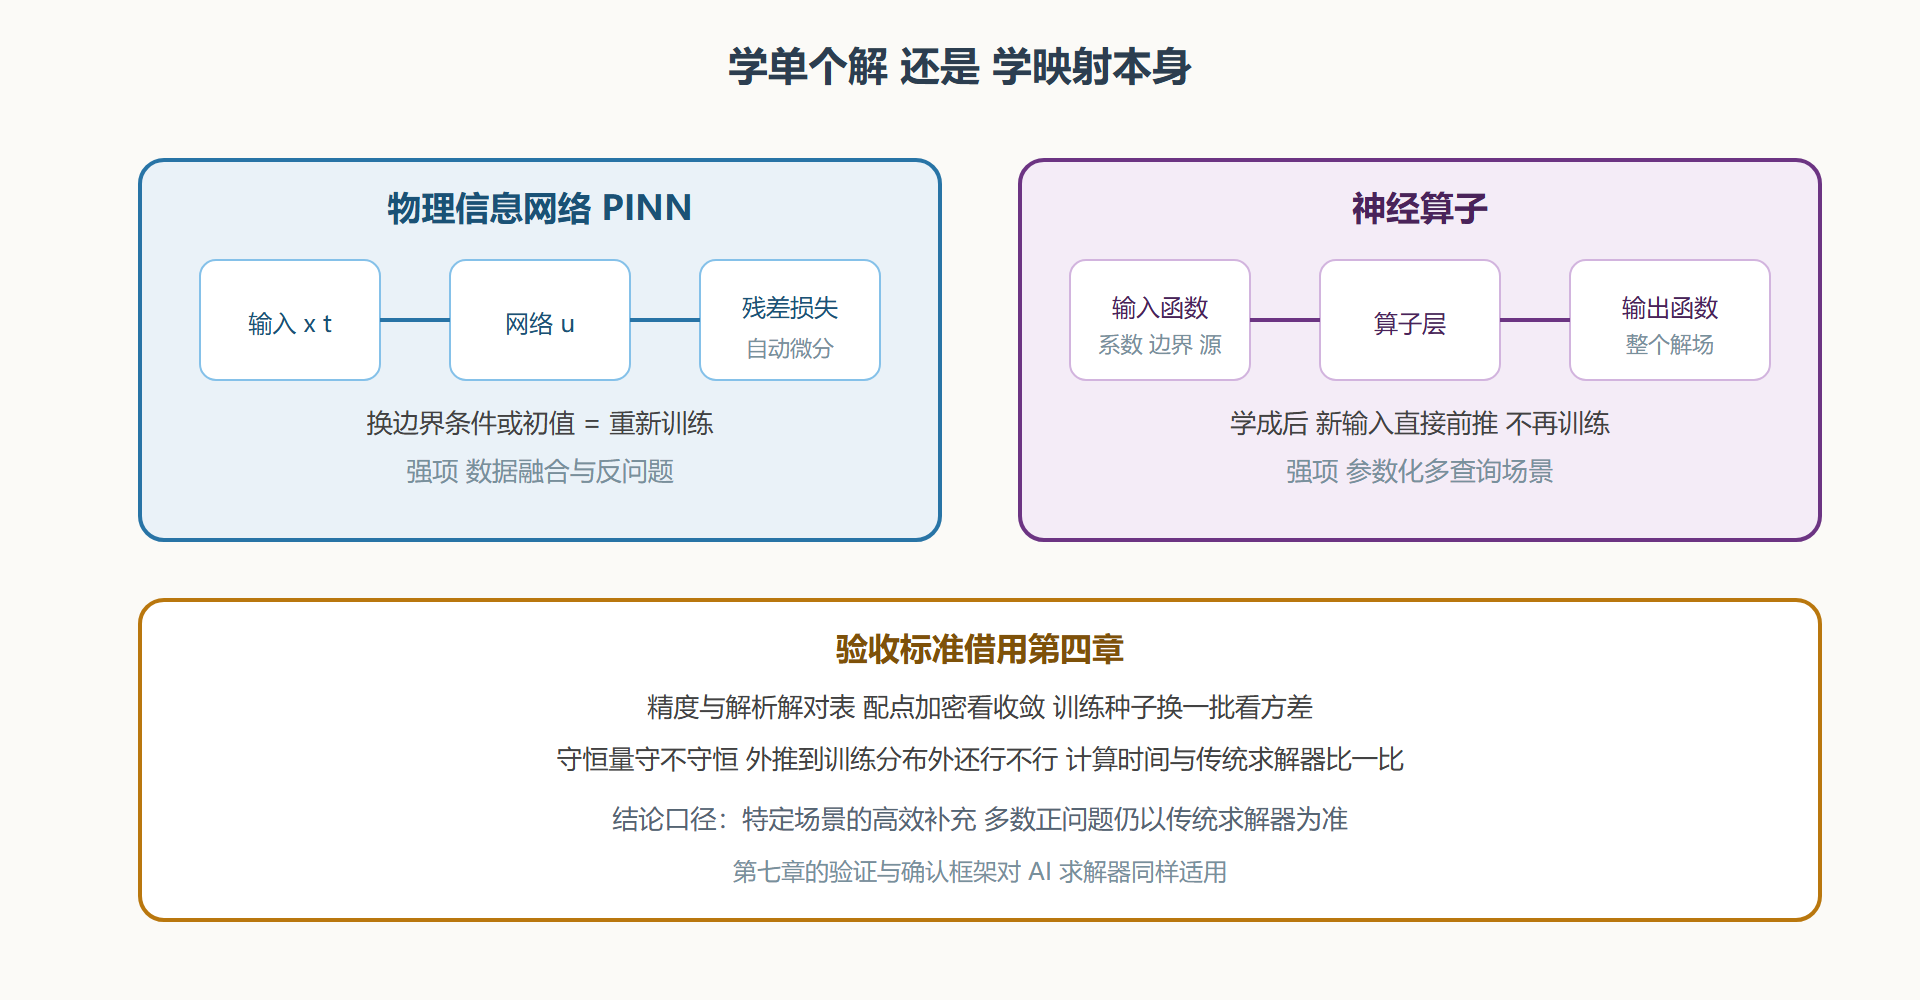
物理信息网络(PINN)的构造出人意料地简朴。用一个标准神经网络表示解:u_θ(x, t),θ 是可训练参数。网络的"物理课"通过损失函数上家教:
L(θ) = ‖u_θ 在初始与边界上的误差‖² + w·‖u_θ 的时间导数 − a²·u_θ 的空间二阶导‖²。
第二项是方程残差,在配点上采样。关键机关是自动微分:残差里的导数不是差商近似,而是对网络计算图的精确求导——链条上每一步都是初等函数,导数精确可得。这与 4.1 的离散化哲学形成有趣对照:传统方法先离散算子再解代数方程,PINN 保留连续算子、把"解方程"变成"高维无约束优化"。训练收敛时,网络是残差在采样意义下接近零的函数——按 2.4 的语义,它是一个数值弱解。
PINN 的真实强项在反问题与数据融合:参数(扩散系数、源项)可以与网络参数一起进损失函数,5.3 的反演流程被一个损失函数天然吸收;观测数据稀疏或带噪时,方程项充当正则化。弱项同样明确:高刚性问题的损失地形崎岖,训练不稳定;精度上限通常在百分之一量级,且没有系统性的收敛阶可报告——训练误差下降不保证解误差同步下降。
图解:两条 AI 路线的原理对照
PINN 与神经算子结构示意
学映射而非解:神经算子
PINN 学的是"这一个"解;换初始条件、换系数就得重训。神经算子换目标:学映射 G——从输入函数(系数场、边界数据、源项)到解函数的算子。傅里叶神经算子是代表性实现:在网络层里做傅里叶变换、在频域做线性变换、截断高波数——本质上是用神经网络的参数化去逼近 3.4 节格林函数的那类积分算子。训练数据是一批"输入函数、解函数"样本对(通常由传统求解器生成——这一点值得念两遍),学成之后,新输入一次前推即得解,速度比传统求解器快几个数量级。
适用判据由此清楚:多查询场景(同一方程族要解成千上万次:设计优化的迭代循环、不确定性量化的参数扫描、实时数字孪生)值得付一次训练成本换万次推理加速;单次求解(就解一次的工程问题)直接用传统求解器更准更稳。训练分布的边界是另一条红线:算子在见过的参数范围内插值表现良好,外推没有保证——像所有机器学习一样。
数值实验:给一个迷你 PINN 验收
用一个极小的一维问题(稳态热传导 −u'' = 2,零边值,真解 u = x(1−x))走一遍 PINN 的骨架代码与验收流程。工程实现依赖自动微分库,这里用 PyTorch 风格的最小示例:
import torch, torch.nn as nn torch.manual_seed(0) net = nn.Sequential(nn.Linear(1, 32), nn.Tanh(), nn.Linear(32, 32), nn.Tanh(), nn.Linear(32, 1)) opt = torch.optim.Adam(net.parameters(), lr=1e-3) def residual(x): x = x.requires_grad_(True) u = net(x) ux = torch.autograd.grad(u.sum(), x, create_graph=True)[0] uxx = torch.autograd.grad(ux.sum(), x, create_graph=True)[0] return -uxx - 2.0 # 方程残差 bc = torch.linspace(0, 1, 2).reshape(-1, 1) # 边界配点 for step in range(4000): x = torch.rand(64, 1) # 内部随机配点 loss = (residual(x)**2).mean() + (net(bc)**2).mean() * 10.0 # 残差 + 边界 opt.zero_grad(); loss.backward(); opt.step() xt = torch.linspace(0, 1, 101).reshape(-1, 1) err = (net(xt).detach().numpy().ravel() - xt.detach().numpy().ravel()*(1-xt.detach().numpy().ravel())) print("最大点误差:", round(abs(err).max(), 5)) print("残差均方根:", round(float((residual(xt)**2).mean())**0.5, 5))
典型的验收读法:四千步训练后最大点误差在千分之几到百分之几之间(随种子波动)——对照第四章同样的二次真解,二阶差分三十个格点就能做到十万分之一精度。这张账单如实呈现了现状:正问题上网络精度与效率都无优势;但若把问题改成"反演未知源项强度"或"一千组系数的多查询",平衡就开始向 PINN 与算子倾斜。换五个随机种子重训、观察误差方差,是比单次结果更诚实的报告——无收敛阶的方法必须用统计口径补偿。
⚠️ 常见坑:把"损失降下去了"当"解对了"。残差在配点上为零不等于残差处处为零,配点稀疏时网络会在配点之间"藏污"。加密度检查(随机换一批配点评估残差)是 PINN 版的网格收敛研究。
本节要点
- PINN:网络表示解、残差进损失、自动微分供导数——把解方程变成高维优化;
- 强项弱项:数据融合与反问题见长,刚性、精度上限与无收敛阶是短板;
- 神经算子:学输入函数到解函数的映射,多查询场景一次训练万次推理;
- 训练数据悖论:算子的老师通常是传统求解器,两条路线是接力不是替代;
- 验收纪律:对表解析解、配点加密、多种子统计、外推测试——第四章标尺照用不误。
前沿四章走完,工具箱已经装满。第六章带着它们走进应用现场:工程传热、量子力学、金融定价、图像去噪——每个现场都会点一把前面磨好的刀。