7.2 建模工作流程
7.2 建模工作流程
兵器选定后,决定成败的是流程。仿真项目的失败很少败在算法,多半败在次序——先铺了千万网格才想起问"二维够不够",跑完三天才检查边界条件。本节把前六章散落的手艺整理成一条标准动作序列:无量纲化、简化决策、粗网格探路、边界敏感性、网格无关性研究、文档归档。走完这条流水线的项目,返工次数与举证成本都会显著下降。
把隐性经验写成清单
资深工程师与新手做同一个题目,差异往往不在知识量而在动作次序——哪些检查在前、哪些节约在后。把次序写下来就是工作流。本册的版本分六步,每一步都有明确的产出物与回退条件:
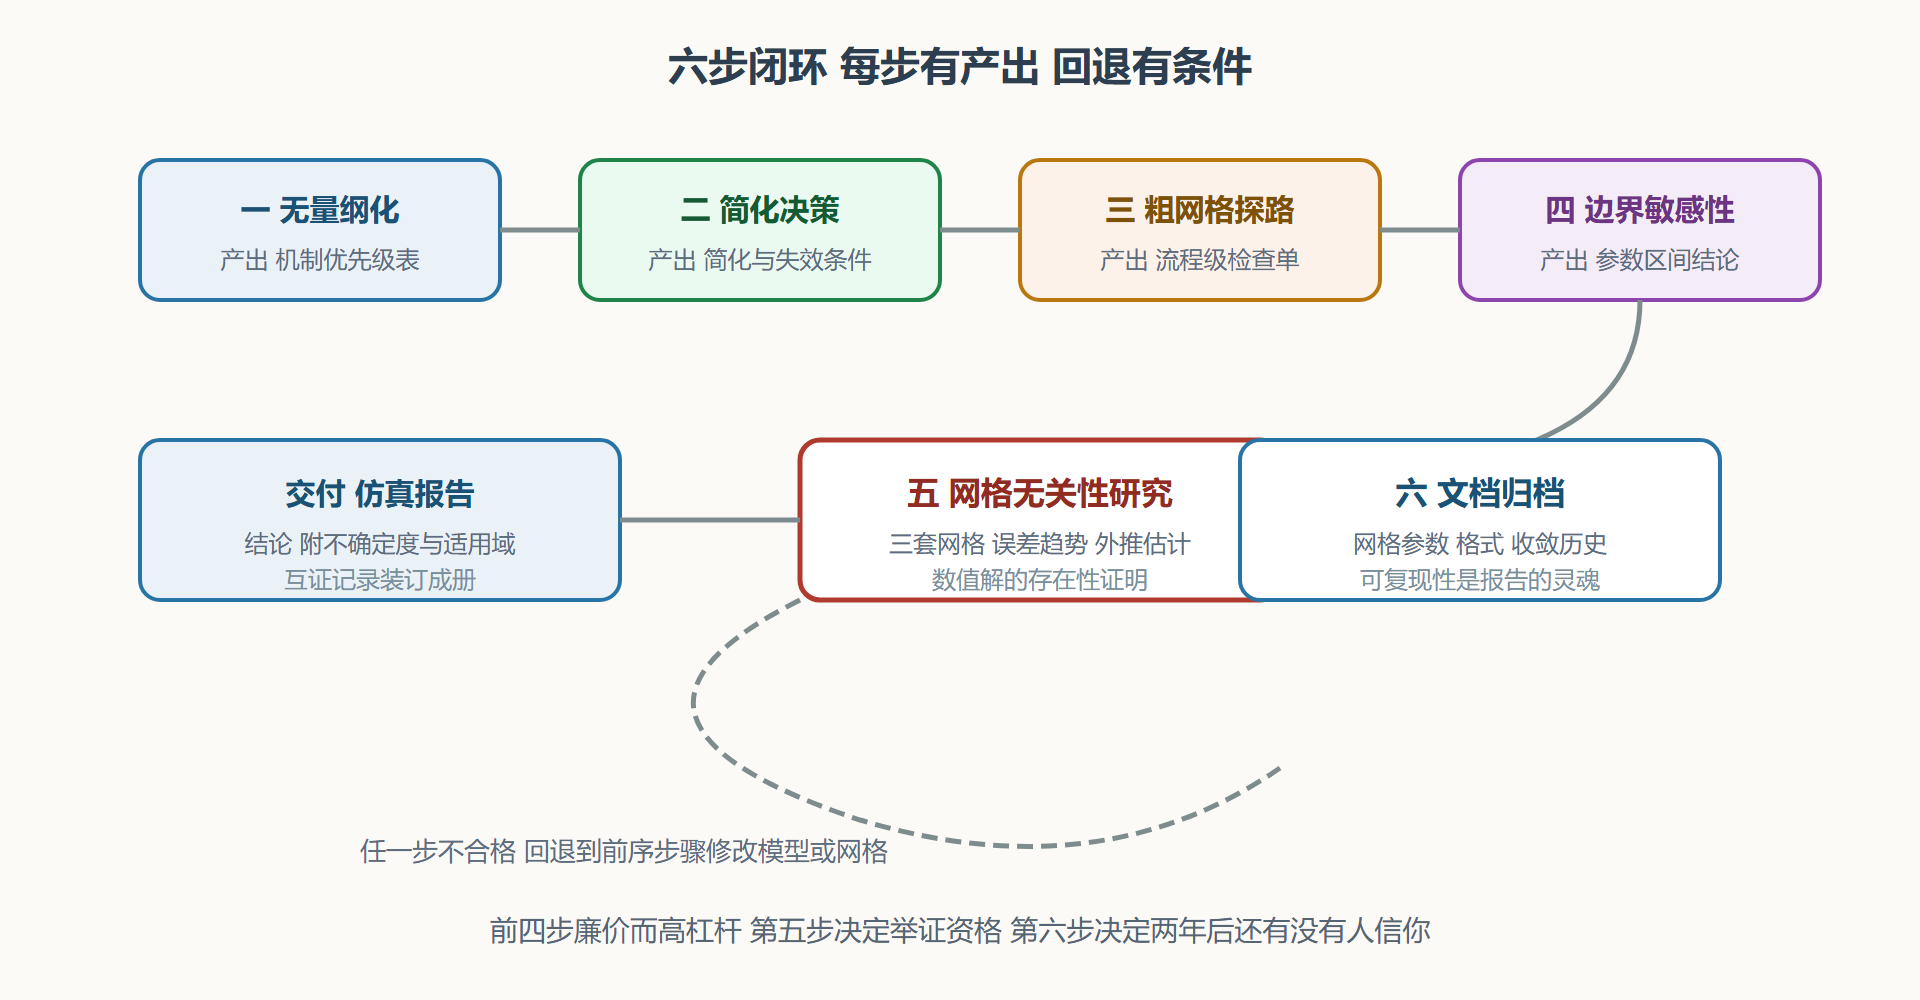
第一步无量纲化。把方程与条件写成无量纲形式,列出全部无量纲数(雷诺数、佩克莱特数、比奥数……),据此判断主次机制。产出物是"机制优先级表":哪些项主导、哪些项可忽略。省略这一步的典型代价是把对流主导问题用中心差分跑出振荡(4.4 的教训)。
第二步简化决策。对称性降维(轴对称问题用二维代替三维)、时间尺度分离(快速过程先冻结)、几何简化。每项简化都要写下"何时失效"的条件——简化不是免费的,它是一张带有效期的支票。
第三步粗网格探路。用几十秒能跑完的网格把全流程走一遍,检查守恒量平衡、量纲合理性、定性趋势。目的不是精度,是暴露流程级错误——大网格上的错误在大网格上一样错,还便宜得多。
第四步边界敏感性。对最不确定的边界条件(换热系数、远场条件)做区间扫描,确认结论在区间内稳定。第六章散热工单的"h 偏差一倍"教训,制度化后就是这一步。
第五步网格无关性研究。至少三套逐级加密的网格、误差随网格的下降趋势、外推到零网格尺寸的估计——详见下面的实验。这是数值解的"存在性证明":没有它,你无法区分"解"与"这个网格上碰巧算出的数"。
第六步文档归档。网格参数、格式版本、收敛历史、全部检查结果打包入库。仿真报告的灵魂不是结论而是可复现性——一年后有人想核查,一切都在。
图解:工作流的闭环与回退
建模工作流六步闭环示意
数值实验:网格无关性研究与理查森外推
第五步值得专门展开,因为它是举证的分水岭。标准做法:三套逐级加密网格(粗、中、细,比例至少一倍)、记录关注量(最大温度、阻力系数、峰值位置)、检查收敛趋势、用理查森外推估计零网格尺寸的极限值。以第六章的肋片问题为例,关注量取肋端温度:
import numpy as np from numpy import cosh L, h_, k, P, A = 0.05, 50.0, 200.0, 0.02, 1e-4 m = np.sqrt(h_*P/(k*A)); th0 = 60.0 def solve(n): x = np.linspace(0, L, n+1); dx = x[1]-x[0] K = (2*np.eye(n-1) - np.eye(n-1,1) - np.eye(n-1,-1))/dx**2 + m**2*np.eye(n-1) b = np.zeros(n-1); b[0] += th0/dx**2 th = np.r_[th0, np.linalg.solve(K, b)] return th[-1] # 肋端温度 u1, u2, u3 = solve(20), solve(40), solve(80) # 粗 中 细 p = np.log((u1-u2)/(u2-u3))/np.log(2) # 实测收敛阶 u_ext = u3 + (u3-u2)/(2**p - 1) # 理查森外推 print(f"粗 {u1:.6f} 中 {u2:.6f} 细 {u3:.6f}") print(f"实测收敛阶 {p:.2f}(理论二阶) 外推值 {u_ext:.6f}") print(f"细网格与外推的剩余差 {abs(u_ext-u3):.2e} 已小于工程需求的百分位")
三行读数就是一份网格无关性报告的骨架:粗细网格的差快速缩小、实测阶数逼近理论值(二阶)、外推给出"数值零误差"估计。报告里写"网格无关"不如写这张表——数字替你举证。若实测阶数偏离理论值(常见于边界处理降阶),这本身就是必须记录的发现,而不是可以掩盖的瑕疵。
⚠️ 常见坑:只加密不检查趋势。"细网格算过了"不等于网格无关——要看相邻网格的差是否按理论阶数缩小,单调下降的差值序列才是收敛的证据;上下跳动的差值说明结果根本没进渐近区,加密再多也是浪费。
无量纲化实战:从一堆单位到一个数
第一步"无量纲化"最容易被跳过,值得用一个完整例子演示它的杠杆率。场景:冷空气横掠一根发热圆柱。原始清单——来流速度 2 米每秒、圆柱直径 0.02 米、空气导热系数与黏度若干、发热功率若干——单位五花八门,主次全无。取直径与来流速度为尺度做无量纲化,方程收拢出一个数:雷诺数 v·D/ν 约等于两千七。这一个数立刻说出三件事:流动处于层流向湍流过渡的下沿;边界层厚度约为直径的十几分之一(按层流标度律估算);换热系数的量级可以直接套努塞尔特关联式估出,误差三五成以内。也就是说,在打开任何求解器之前,答案的量级、关键机制、甚至网格需要多细(边界层内至少十个格点)都已经有了。大型仿真在这里的角色只剩"精化",而不是"发现"。
无量纲化的另一个红利是模型缩放的合法性:风洞缩比模型与真机"相似"的严格条件,就是各无量纲数对应相等。为什么飞机设计师能在小风洞里测大飞机?因为雷诺数与马赫数对上了,方程就是同一条。第六章肋片工单里的比奥数判断、本章的这个雷诺数演算,是同一门手艺的两次出手。
简化决策的两个守则与评审门禁
简化是流程里最容易埋雷的一步,两条守则可以把雷排掉大半。守则一:简化必须带上"失效条件"。轴对称假设的失效条件是"出现非对称扰动或安装偏差";稳态假设的失效条件是"时间尺度比值超过某阈值"(过程特征时间远小于系统热时间常数时稳态才成立);降维假设的失效条件通常是"端部效应可测"。把失效条件写成模型文档的一行,两年后复用这份模型的人才知道边界在哪。守则二:每项简化都要标价——它省了多少算力、换来多大偏差。粗估的方法正是第四步的敏感性扫描:把被简化的效应开与关各跑一次粗网格,差值就是简化标价。标价超过结论容差,简化就必须收回。
六步走完之后、签字放行之前,建议设一道"评审门禁":由没参与建模的同事对着检查单过一遍——定解问题写全了吗(1.4 的自由度清点)、无量纲数列全了吗、每项简化有失效条件吗、边界敏感性扫描过吗、网格收敛阶对上理论了吗、不确定度区间给了吗。六问全过才进 7.4 的正式举证。流程的价值不在每一步多高深,而在六步一个都不许漏。
本节要点
- 次序即专业:无量纲化、简化、粗探路、敏感性、无关性、归档——六步次序不可颠倒;
- 简化带有效期:每项简化写明失效条件,轴对称与冻结假设都要有回退开关;
- 粗网格探路:流程级错误在便宜网格上暴露,精度追求放在流程正确之后;
- 网格无关性:三套网格加理查森外推,是数值解举证资格的门槛;
- 文档即生命:可复现性决定仿真结论的半衰期。
流程理顺了,规模上去了。千万网格单机跑不动怎么办?下一节进入高性能计算——域分解、负载均衡与并行效率的核算。