7.3 高性能计算
7.3 高性能计算
流程走对了,规模顶上来:三维非定常问题的工业网格动辄十亿自由度,单机内存放不下、单核算不完。高性能计算不是"买更多机器"那么简单——并行有收益递减、通信有物理极限、负载不均会吃掉一半算力。本节讲清并行化的基本账本:问题怎么切、边界怎么通信、效率怎么核算,最后用一次可复算的实验亲眼看"加核加速比"何时开始衰减。
从连续到离散再到并行的三层账
并行化的对象是第四章的离散结果,而离散的结构决定并行策略。第一步看稀疏结构:显式格式(4.2 的热传导显式)每个格点的新值只依赖邻居旧值——天然并行,时间步进即 embarrassingly parallel;隐式格式每步解一个大型稀疏线性系统,并行化的主战场在这里。第二步看算法:雅可比迭代并行度满分(每个点独立更新)但收敛慢;共轭梯度每步有内积(全局归约,需要通信)与矩阵向量乘(邻域通信);多重网格(逐层粗化修正的加速技术)并行效率最高但实现复杂。第三步看硬件:现代处理器是"内存墙"上的建筑——浮点算得比内存搬得快两个数量级,缓存友好的数据布局(格点按行连续存放)常常比并行核数更影响速度。三层账合起来给出工程排序:先改数据布局,再选并行算法,最后加机器。
域分解:把网格切开分给机器
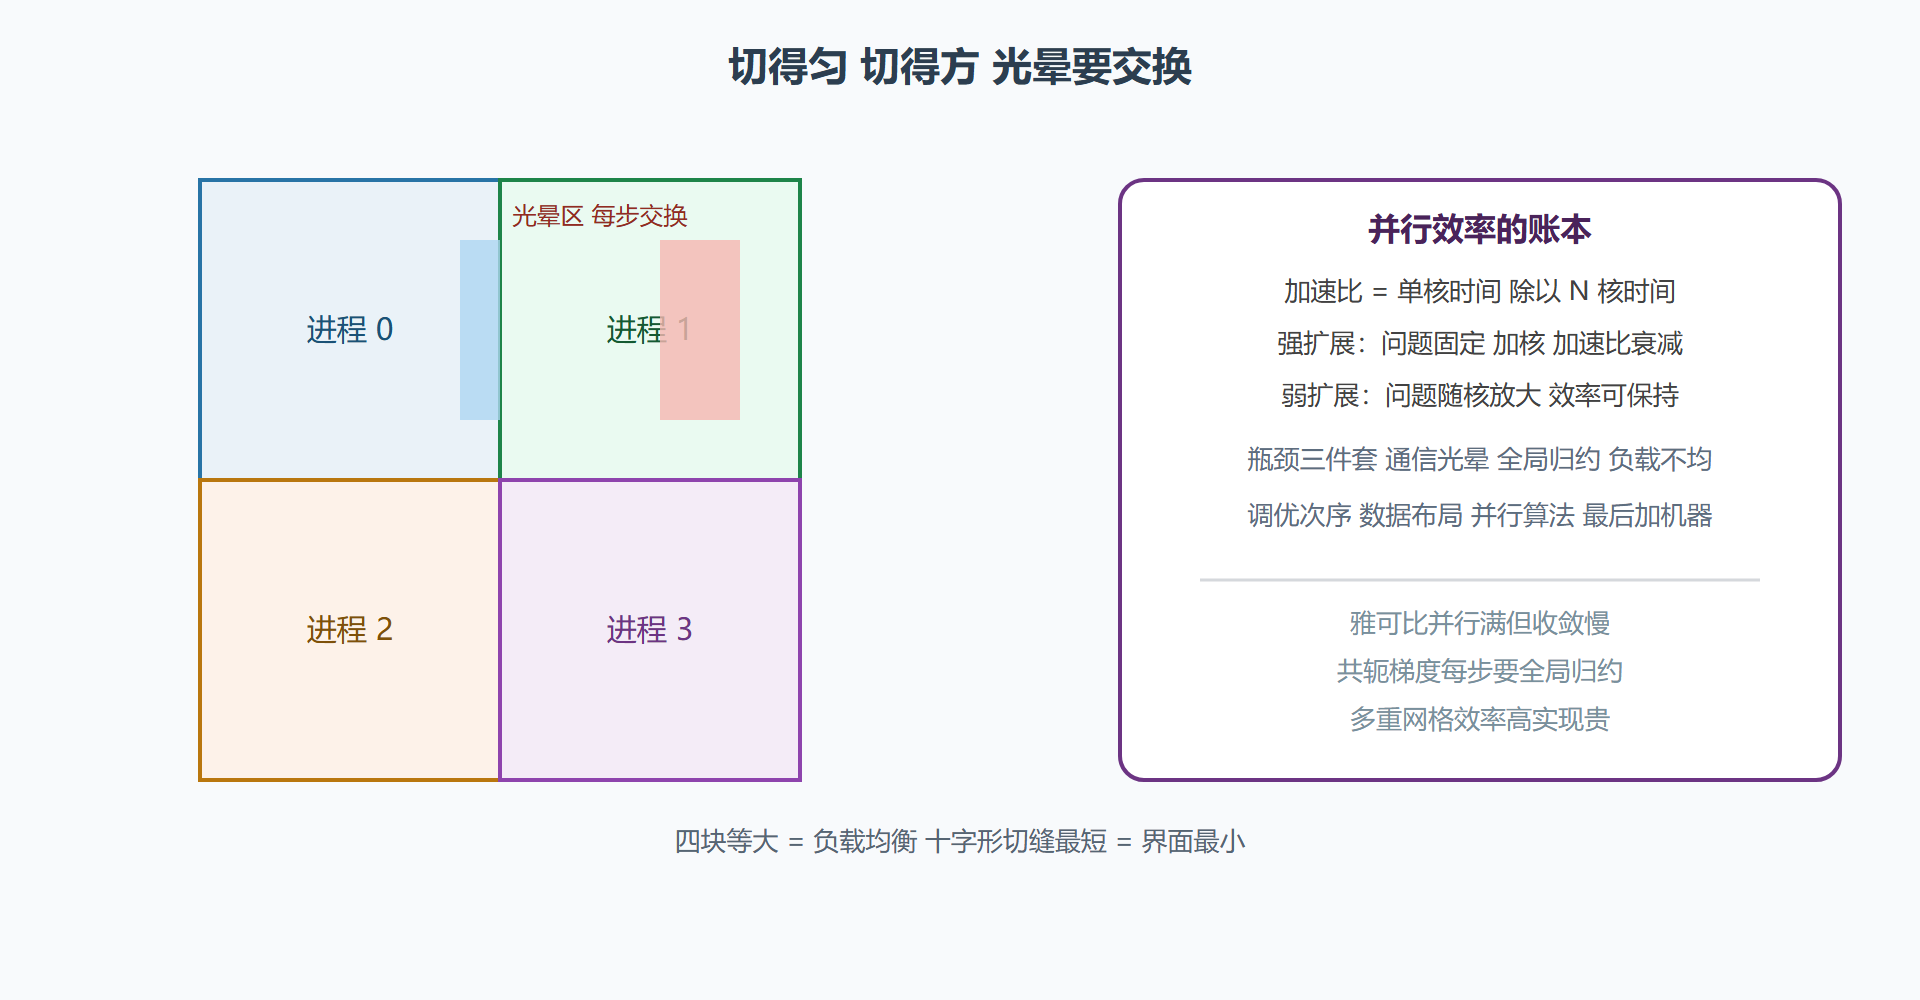
大规模并行的事实标准是域分解:把计算区域切成若干子域,每个进程认领一块。切法的两条纪律决定了效率上限。负载均衡:每个子域的格点数应相等(计算量正比于格点数),自适应加密网格需要图划分工具(按连接关系切分使子域间界面最小)——负载不均的并行,最慢的进程决定全局步调,一半算力在等。界面最小化:子域边界上的格点需要邻居的数据(光晕区或称鬼区),每步迭代前后要交换;切得碎,通信占比高;切得方,界面短。一句话概括:切得匀、切得方。
通信与计算的竞争用罗森格律概括:并行效率随问题规模与进程数之比变化——固定问题加进程,计算量每核下降、通信占比上升,效率必然衰减。这就是"强扩展"与"弱扩展"的区别:前者固定总问题量看加速比(上限受通信制约),后者按核数等比放大问题量(可维持效率到更大规模)。工业上真正有意义的是弱扩展,因为算力增长向来用于加大问题而非加速同一问题。
图解:域分解与通信光晕
域分解与光晕交换示意
数值实验:亲手测一次加速比衰减
并行不必等集群:多核笔记本就能演示罗森格律。用 Python 的多进程跑二维热传导的雅可比迭代,固定问题规模,核数从 1 到 8,记录实际加速比并拆出通信(进程间交换边界行的开销):
import numpy as np from multiprocessing import Pool import time n = 1600; iters = 20 def jacobi_chunk(args): k, nchunks = args rng = np.random.default_rng(42 + k) m = n // nchunks + 2 # 每块带上下光晕各一行 u = rng.random((m, n)) t0 = time.perf_counter() for _ in range(iters): u[1:-1] = 0.25*(u[:-2] + u[2:] + u[:, :-2] + u[:, 2:]) return time.perf_counter() - t0 base = None for P in [1, 2, 4, 8]: t0 = time.perf_counter() with Pool(P) as pool: pool.map(jacobi_chunk, [(k, P) for k in range(P)]) wall = time.perf_counter() - t0 if base is None: base = wall print(f"进程数 {P} 墙钟 {wall:.3f} 秒 加速比 {base/wall:.2f}")
实验的真实收获在曲线形状:核数从 1 到 2 接近线性加速,到 8 时加速比明显偏离 8(进程创建与内存带宽竞争的联合作用);若把计算时间与墙钟时间相减,可以把衰减拆分为通信部分与调度部分。这份手测经验的价值在于校准直觉——看到机器报告的核数不等于可用算力,效率曲线才是真家底。生产环境把这里的进程池换成消息传递接口,把雅可比换成多重网格预条件的共轭梯度,就是前面说的"操作系统级"并行求解器的日常。
⚠️ 常见坑:按核数线性折算预算。并行效率通常随规模递减,报价与排期要按实测的弱扩展曲线折算——跳过这一步的项目,成本超支是宿命而非意外。
线性求解器才是真正的战场
瞬态显式问题并行得毫不费力,但工业仿真的主力是隐式格式(4.2 的克兰克–尼科尔森、第七章的结构静力),每步都要解一个千万阶稀疏线性系统——并行效率的大头耗在这。两条路线各有账本。直接法(稀疏 LU 分解)稳健但并行扩展差:填充与通信随规模超线性增长,通常只在子域内部小规模使用。迭代法是大规模的正解:共轭梯度或广义最小残差法配上预条件子。预条件子是迭代法的心脏——它把病态系统"整形"成收敛快的等价系统;并行环境下好用的预条件不多:代数多重网格(跨尺度消误差,扩展性最好)、区域分解类(把子域内问题解好、界面问题单独处理)、不完全分解(简单但通信多)。调求解器的日常,八成时间在调预条件。
一个问题规模的粗账可以说明算力等级:两维问题百万网格,未知量百万级,三对角块结构单机秒解;三维问题十亿网格,未知量十亿级,每步迭代的通信与内存墙都是并行系统的极限测试——这也是为什么大仿真的排期按"每步迭代时间"而非"每步格式时间"来谈。先估计线性求解的行为,再谈格式与精度,是大规模项目的正确次序。
GPU 与混合并行的半页账
现代算力版图还有第三层:图形处理器把"同一个运算灌进海量数据通道"的架构发挥到极致,恰好匹配显式格式与矩阵向量乘这类规则访存密集的内核——机器学习与显式波动模拟在 GPU 上如鱼得水就是明证。但它的短板同样明确:分支密集的逻辑、强串行的递推、以及隐式求解中的全局归约,效率会大打折扣。工程上的主流形态是混合并行:节点之间用消息传递(域分解),节点之内用共享内存或加速卡(线程与核内矢量化),三层各自消化各自粒度的并行度。代价是复杂度叠加——同一个 bug 可能藏在任何一层。务实的建议与前两节一脉相承:先把单核性能与算法选对(这一步常有两到十倍的空间),再谈并行,最后谈加速卡;次序颠倒的项目常见"八百个核跑出一个核的一半效率"的场面。
本节要点
- 三层账:稀疏结构定并行难度、算法定通信模式、数据布局常比核数更决定速度;
- 域分解纪律:切得匀(负载均衡)、切得方(界面最短),光晕交换每步发生;
- 两种扩展:强扩展看加速比上限、弱扩展看效率保持,工业预算按弱扩展折算;
- 算法谱系:雅可比并行满收敛慢、共轭梯度需归约、多重网格高效但实现贵;
- 实测文化:效率曲线是家底,报价与排期必须按实测折算。
算出来了、也算快了,剩下最后一问:凭什么是可信的?终节走进验证与确认——仿真界的举证制度,也是全册互证纪律的成年礼。