6.1 性能与效率
6.1 性能与效率
本节摘要:元编程的性能账要分三段记——构建期展开、加载期织入、运行期查询,三段的量级、成因与减负手段各不相同。本节给出三段开销模型与实测量级参照,拆解模板膨胀与反射开销两大顽疾的成因,并汇总可直接落地的减负清单。
开销的三段模型
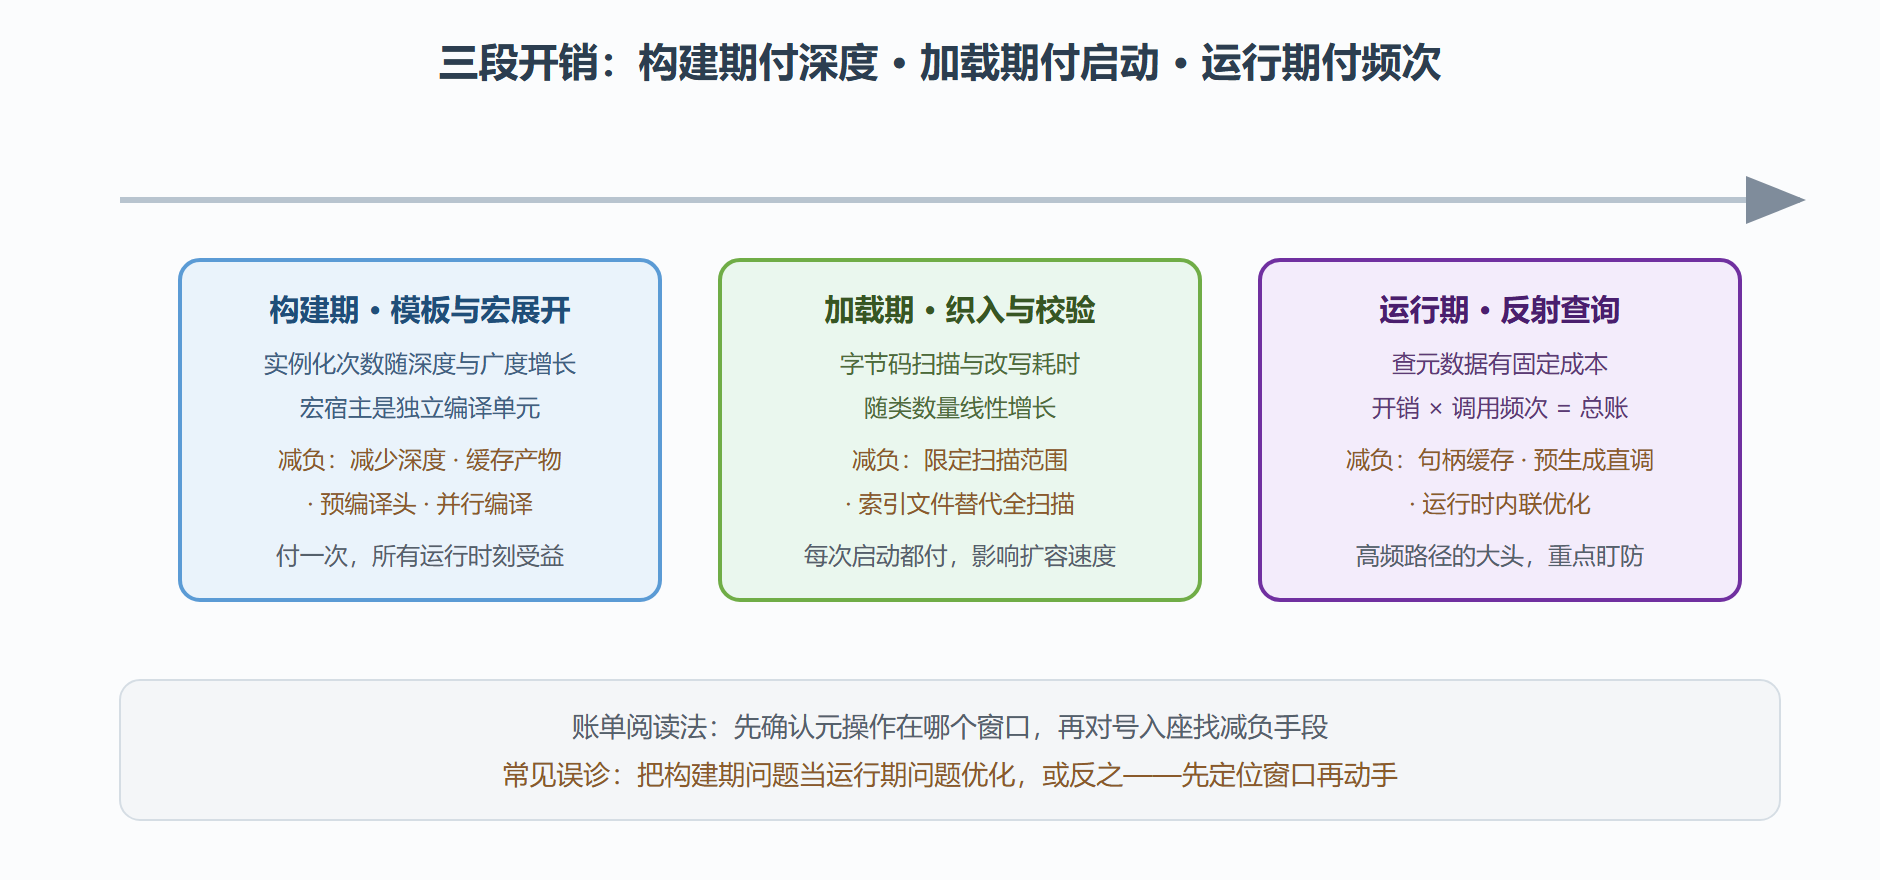
"元编程慢不慢"是个没有单一答案的问题,因为开销发生在三个完全不同的时段,谁付、付多少,取决于你把元操作放在 2.1 时间轴的哪个窗口。三段模型的口诀:构建期付深度、加载期付启动、运行期付频次。
图:三段开销的位置与量级
一、构建期:深度的代价
模板重度项目的编译时间膨胀有两个来源。深度:3.5 手推过,递归实例化的每一帧都是真实工作量,编译期计算、表达式模板都会把实例化链拉长;广度:同一模板被多种类型实例化就产出多份代码,容器模板被几十个元素类型使用时,每个编译单元都要重复处理这些实例。
减负按性价比排序:其一,外置模板——把模板定义与显式实例化放进少数编译单元,其余单元只看声明,重复实例化工作从"每个单元一次"降到"整个工程一次";其二,预计算缓存——把稳定的编译期计算结果固化成生成表(4.5 的预生成思路),N 次递归换成一次查表;其三,约束收紧——Concepts 约束让不适配的调用在实例化前就被拒绝,避免"先展开千行再报错"的浪费。过程宏的构建开销同源:宏宿主是独立编译单元,宏数量增长直接推高构建图,控制宏粒度、合并同源宏是主要对策。
二、运行期:频次的代价
反射单次查询的固定成本来自三件事:名字解析(字符串到元数据的匹配)、访问检查(权限与可访问性校验)、参数装箱(值与对象的互转)。单看一次是微秒级,但性能账按"开销 × 频次"结算——放进每秒数万次的热点循环,微秒就是灾难。
一组可复现的对照实测(量级参照,具体数值因运行时而异):
直调方法 ≈ 2 纳秒 缓存 Method 句柄后反射 ≈ 5~8 纳秒 每次现场 getMethod ≈ 微秒级(百倍于直调)
操作→结果:缓存把反射与直调的差距从量级差压到常数差,现场查找则保持三个数量级的劣势。解读:结论不是"反射慢",是**"现场反射慢、缓存反射可接受"**。再往上还有一层:现代运行时的即时编译器能对热点反射调用做内联与去虚化,缓存句柄恰好为这种优化创造了条件——两股力量叠加后,稳态反射的实际成本常被高估。
变式:把"运行期查询"彻底替换为"启动期生成直调代码"——首次访问时生成专门的调用器并缓存,之后与直调无异。这正是多数序列化框架的稳态形态:首调慢(侦察加生成),后续全速。
三、产物膨胀:被忽视的第三本账
前两段是时间账,还有一本空间账:模板膨胀。同一容器模板对大量类型实例化,产物里会出现几十份结构雷同的机器码,指令缓存命中率随之下降——程序变慢的方式不是单条指令慢,而是缓存装不下。对策是"类型收敛":用类型擦除把多种实例收敛到少量实现(标准库里 shared_ptr<void> 式的技巧、function 的内部擦除都是此道),或显式限定实例化白名单。加载期织入也有一本空间账——织入后的类更大、方法更多,元空间占用上升,容量规划要把织入增量算进去。
⚠️ 常见坑:性能优化先动元机制。真实案例里,"反射太慢"的结案往往发现热点在数据库或网络,反射只贡献了零头。口诀:先按 5.4 的方法量测归因,再决定动不动元机制。
一份性能体检的操作顺序
给一个元编程重度项目做性能体检,顺序比手段重要。第一站:分层计时——构建时长拆出"宏展开、模板实例化、普通编译"各占多少(多数构建系统支持计时输出或时间追踪开关),运行剖析拆出"反射查询、动态代理转发、织入代码本体"各占多少。没有分层数据之前的一切优化都是猜。第二站:对号入座——把占比最大的一层放回三段模型,找对应的减负清单:构建期看实例化深度与宏粒度,加载期看扫描范围,运行期看查询缓存。第三站:设预算线——把优化后的数值写成持续集成里的阈值(构建时长上限、关键接口延迟上限),防止下一个"顺手加个宏"悄悄把账单吃回去。
一次真实体检的数字可以作为参照:某服务构建十分钟里宏展开占了一半,运行剖析显示反射贡献不到百分之一的延迟。优化动线因此完全确定——砍构建期的宏(合并同源宏、外置实例化),运行期一行不动。体检的价值就在于此:让优化从"感觉哪里慢改哪里"变成"数据说哪里贵砍哪里"。
体检的收尾动作同样重要:把三段模型的结论写成一页"元机制性能档案",随项目文档维护——构建期展开占比多少、加载期织入的类数量、运行期缓存的反射句柄数量。这份档案有两个用途:新人做性能相关改动前先看预算余量;下次构建时间暴涨时,对比档案立刻知道是哪一段越了线。性能维护的本质不是一次次救火,而是让每一笔开销都有账可查、有档可对。
顺带澄清一个高频疑问:要不要因为性能而全面回避元机制?答案是否定的,而且是双重的否定。其一,本节所有开销都有成熟缓解手段,回避是放弃收益而不是消除成本;其二,真正的性能敏感层往往只占代码面积的很小一部分——把"热点路径禁用现场反射、禁用未缓存查询"写成一两条硬规则即可,其余位置的元机制放开用。性能纪律的单位是规则,不是禁忌;把"反射慢"变成一条可执行、可检查的规则,团队就不必活在模糊的恐惧里。规则的检查也应自动化:静态扫描"循环体内反射查找"这类模式,让纪律长在流水线里,而不是长在评审人的记性里。
本节要点回顾
- 三段模型:构建期付深度,加载期付启动,运行期付频次——先定位窗口再谈优化。
- 构建减负:外置模板显式实例化、预计算缓存、约束收紧、宏粒度控制。
- 反射账:现场查找百倍于直调,句柄缓存压到常数差,即时编译还能再收一笔。
- 空间账:模板膨胀拉低指令缓存命中率,类型收敛与白名单实例化是对策。
- 归因纪律:性能问题先量测归因,别让元机制背黑锅,也别放过真元因。
时间账与空间账记完,下一本更难缠:当代码不再"所见即所得",调试与维护的规则要重写一遍。