5.2 构建:DNA 合成、组装与整合
5.2 构建:DNA 合成、组装与整合
本节摘要:构建相把设计清单变成实体 DNA:外购合成、体外组装、基因组整合三条路线各有成本与边界。本节给出按任务选路线的决策逻辑,拆解并行化组装的提速原理与常见翻车点,并说明"构建纪律"——阴性对照、双验证、留存制度——如何让每一轮产物都可用于归因。
三条路线的账本
设计清单上的十几个构建任务,不是每一条都值得自己动手。路线选择是构建相的第一个决策,三条路线的账本各不相同。
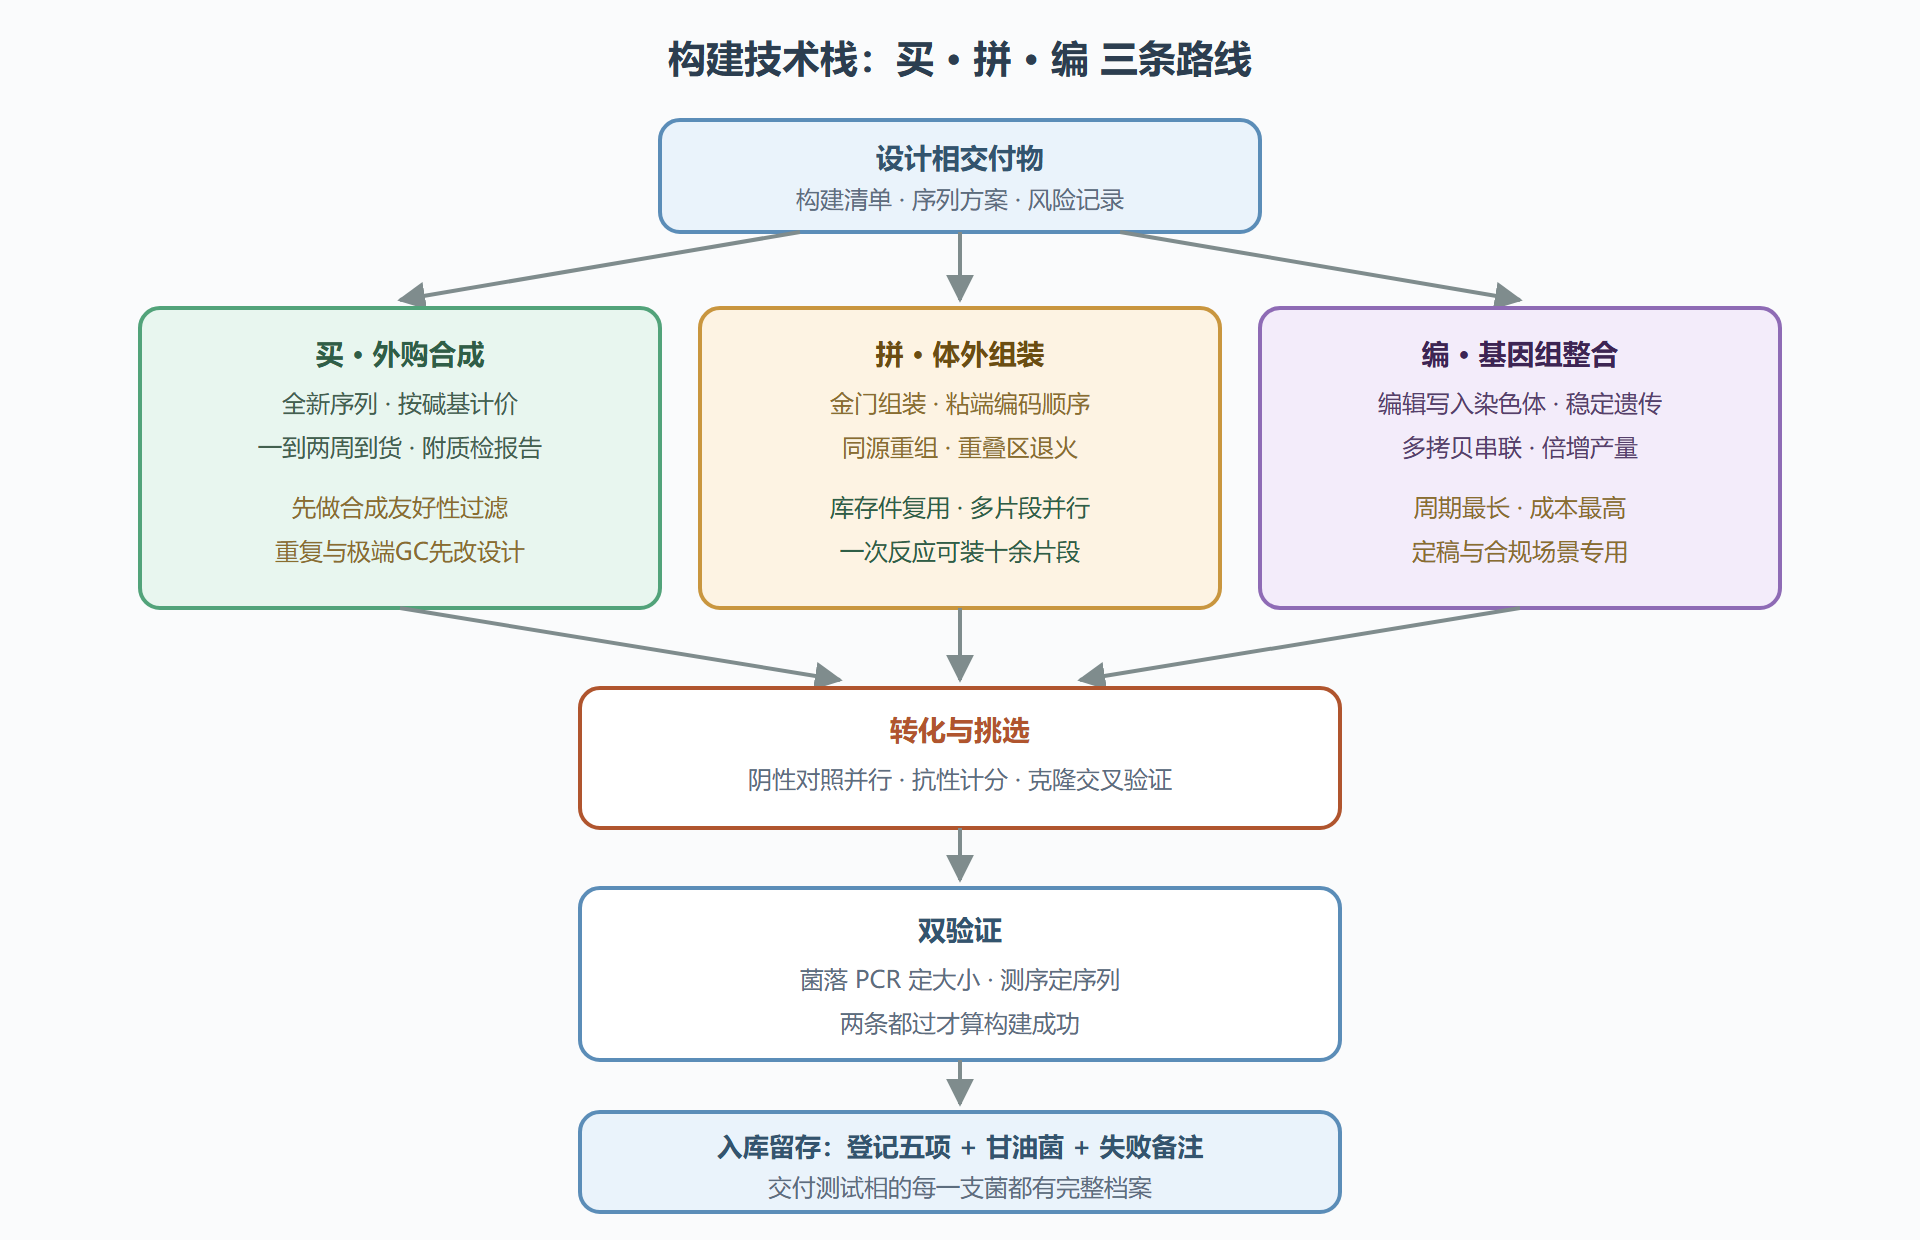
买(外购合成):把序列设计发给合成公司,等质粒到货。单价按碱基对计,周期以天到两周计。适合全新序列、长短适中、无库存的元件;不划算的场景是超长序列、重复结构多的序列,以及预算敏感但有人手的小批量任务。
拼(体外组装):以库存片段或 PCR 产物为原料,在实验室里完成拼接。金门组装与同源重组法是当前两大主力——前者用 II 型酶的短粘端编码顺序,一次反应并行装多片段(2.2 节);后者靠片段末端的重叠同源区在体外或体内完成退火拼装。适合库存件复用、多片段途径装配、以及"明天就要"的急件。
编(基因组整合):用编辑技术把模块写进染色体。适合终版定稿(质粒要丢、染色体不丢)、多拷贝重复整合(产量倍增)、以及合规要求去抗性标记的场合。成本最高、周期最长,但产物最稳定。
三条路线不是互斥的,一个项目里的常态是混用:原型期全靠买与拼,定稿期用编收口。决策口诀:库存优先拼,全新直接买,定稿必须编。
图 12 构建技术栈:从设计清单到验收入库的三条路线
二、并行化组装:提速的原理与翻车点
传统酶切连接一次装一个片段,十片段途径要装十轮。并行组装把这件事压成一到两轮,原理在 2.2 节已经铺过:II 型酶在识别位点之外切开、产生设计好的四个碱基粘端,把"谁接谁"的信息编码进粘端序列,几十个片段就能在一管里按序环化。同源重组法用同一思想,把编码信息放在末端重叠区里。
提速的另一面是翻车点更集中。粘端错配:四个碱基的编码空间有限,片段一多,粘端设计不慎出现交叉互补,产物就接错序——设计阶段要用工具校验粘端两两正交。片段浓度失衡:并行反应对配平敏感,某一片段过少会成为"短板反应",产物以缺失该片段的副产物为主——定量与预混纪律不能省。重复序列重排:多拷贝串联结构在体内不稳定,接好的质粒传几代就缺胳膊少腿——这类结构要选低拷贝骨架、缩短体外操作时间,或在体内用重组缺陷型宿主接住。
一个实用的分组策略:把十片段任务拆成两个三级中间载体加一个终装——每级反应复杂度可控,出错后归因范围也小。并行不是无脑一把梭,而是把"一把梭"的风险切成分段可控的批次。
三、构建纪律:让产物可用于归因
构建相最隐蔽的浪费,是做出来的东西"没法用"——表型不对时,你不知道是设计错了、组装错了还是菌认错了。三条纪律堵住这个漏洞。
阴性对照并行:每次组装都带一管不加插入片段的骨架对照。它量化背景转化率,是判断"平板上的克隆可不可信"的标尺——对照管长出一片时,你该怀疑的是连接体系而不是去挑克隆。
双验证:菌落 PCR 判大小、测序判序列,两条都过才算构建成功。只跑 PCR 不测序的构建,等于把未知序列埋进下游实验——几轮之后数据异常,追根溯源时没人说得清哪批质粒是干净的。
留存制度:每轮产物的甘油菌入库、失败轮次写备注(2.3 节的教训),登记五项齐备。测试相发现表型漂移时,回溯档案能在一天内定位到"哪一轮的哪一支菌"——没有档案的团队只能全部重做。
这三条在手工实验室里常被嫌繁琐,在铸造厂里却是流水线的默认配置。5.4 节会看到,自动化平台本质上就是把这些纪律做成了机器强制执行的流程。
四、构建的产能账
给团队算一笔产能账,有助于理解自动化之前的极限在哪。一个熟手做金门组装,一天最多两轮、每轮四个构建,扣除验证周期,一周稳定产出约二十个经双验证的质粒。而一个设计任务常见的规模是:五个启动子档位乘三个 RBS 档位再乘两个骨架,六十个构建。手工产能与设计空间之间的这道鸿沟,正是工程化需要回答的问题——答案分两步:先用实验设计方法砍掉组合里的大多数(正交表、分式因子设计,用二十个构建近似扫描六十维空间),再把剩下的交给 5.4 节的自动化平台。
补充:组装方法速查与一次重排事故
三种主流组装法的适用速查:经典酶切连接——两个片段的快速活,成本最低,接口受限;金门组装——二到十几个片段的并行装配,无疤痕,粘端设计是唯一的智力活;同源重组法——对片段长度与数量最宽容,适合超长途径,代价是接缝处留同源臂。没有全能冠军,与底盘选型同款逻辑:按任务形状选。
事故档案值得记录一例:某团队组装一条八基因真菌途径,菌落 PCR 正确、测序正确、首轮表型正常——三周后表型消失。回溯发现两个基因间存在约三百碱基的同向重复序列,宿主的重组系统在传代中把重复区间的片段"裁"掉了。处置:改用重组缺陷型宿主传代、终版菌株删除重复并改用合成绝缘序列。教训写进团队规程——多拷贝与重复结构是时间炸弹,验证必须加"传代稳定性"一关,构建当天的正确不算数。
问题:组装成功的最低验证标准是什么?
两件套:跨接缝的菌落 PCR 定大小、覆盖全部插入段的测序定序列。升级版再加两件:全质粒的酶切图谱核对(防骨架区意外)、五到十代的传代后复检(防重排与缺失)。低于两件套的"成功",本质是把未知埋进下游;含重复结构的构建跳过传代复检,等于接受一枚随时起爆的定时炸弹。
问题:片段太多一次装不完怎么办?
分级组装是标准答案:先把片段按功能分组成三到五个中间载体,再终装一次成型。分组的诀窍是让每个中间载体的验证独立可判读——哪一级出问题,哪一级返工,互不牵连。这与软件工程"模块化编译后链接"的思想同源:把一次大爆炸式的不确定性,切成几次小规模、可归因的验证。
本节要点回顾
- 路线口诀:库存优先拼、全新直接买、定稿必须编;三线混用是常态。
- 并行组装把顺序信息编码进粘端或重叠区,翻车点集中在粘端正交、片段配平、重复重排。
- 分组建装(中间载体分级)让复杂任务风险可控、归因范围小。
- 三条纪律:阴性对照、双验证、留存制度,缺一条都会在归因时加倍偿还。
- 手工产能与设计空间的鸿沟,用实验设计砍组合、用自动化平台补产能。
质粒到冰箱了。下一相开测——以及比测试更重要的:让数据回到设计里去。