9.1 技术融合趋势:AI、自动化与工艺创新
9.1 技术融合趋势:AI、自动化与工艺创新
本节摘要:三条河正在合流:人工智能把设计从"经验驱动"推向"按需设计",自动化与铸造厂把执行推向工业节拍,工艺与材料创新把生产推向新底物与新形态。本节讲每条河改写了哪些环节、合流点上出现了什么新形态,以及哪些环节依然是人的主场——前沿评估的关键不是新奇度,而是它搬动了哪块石头。
三条正在合流的河
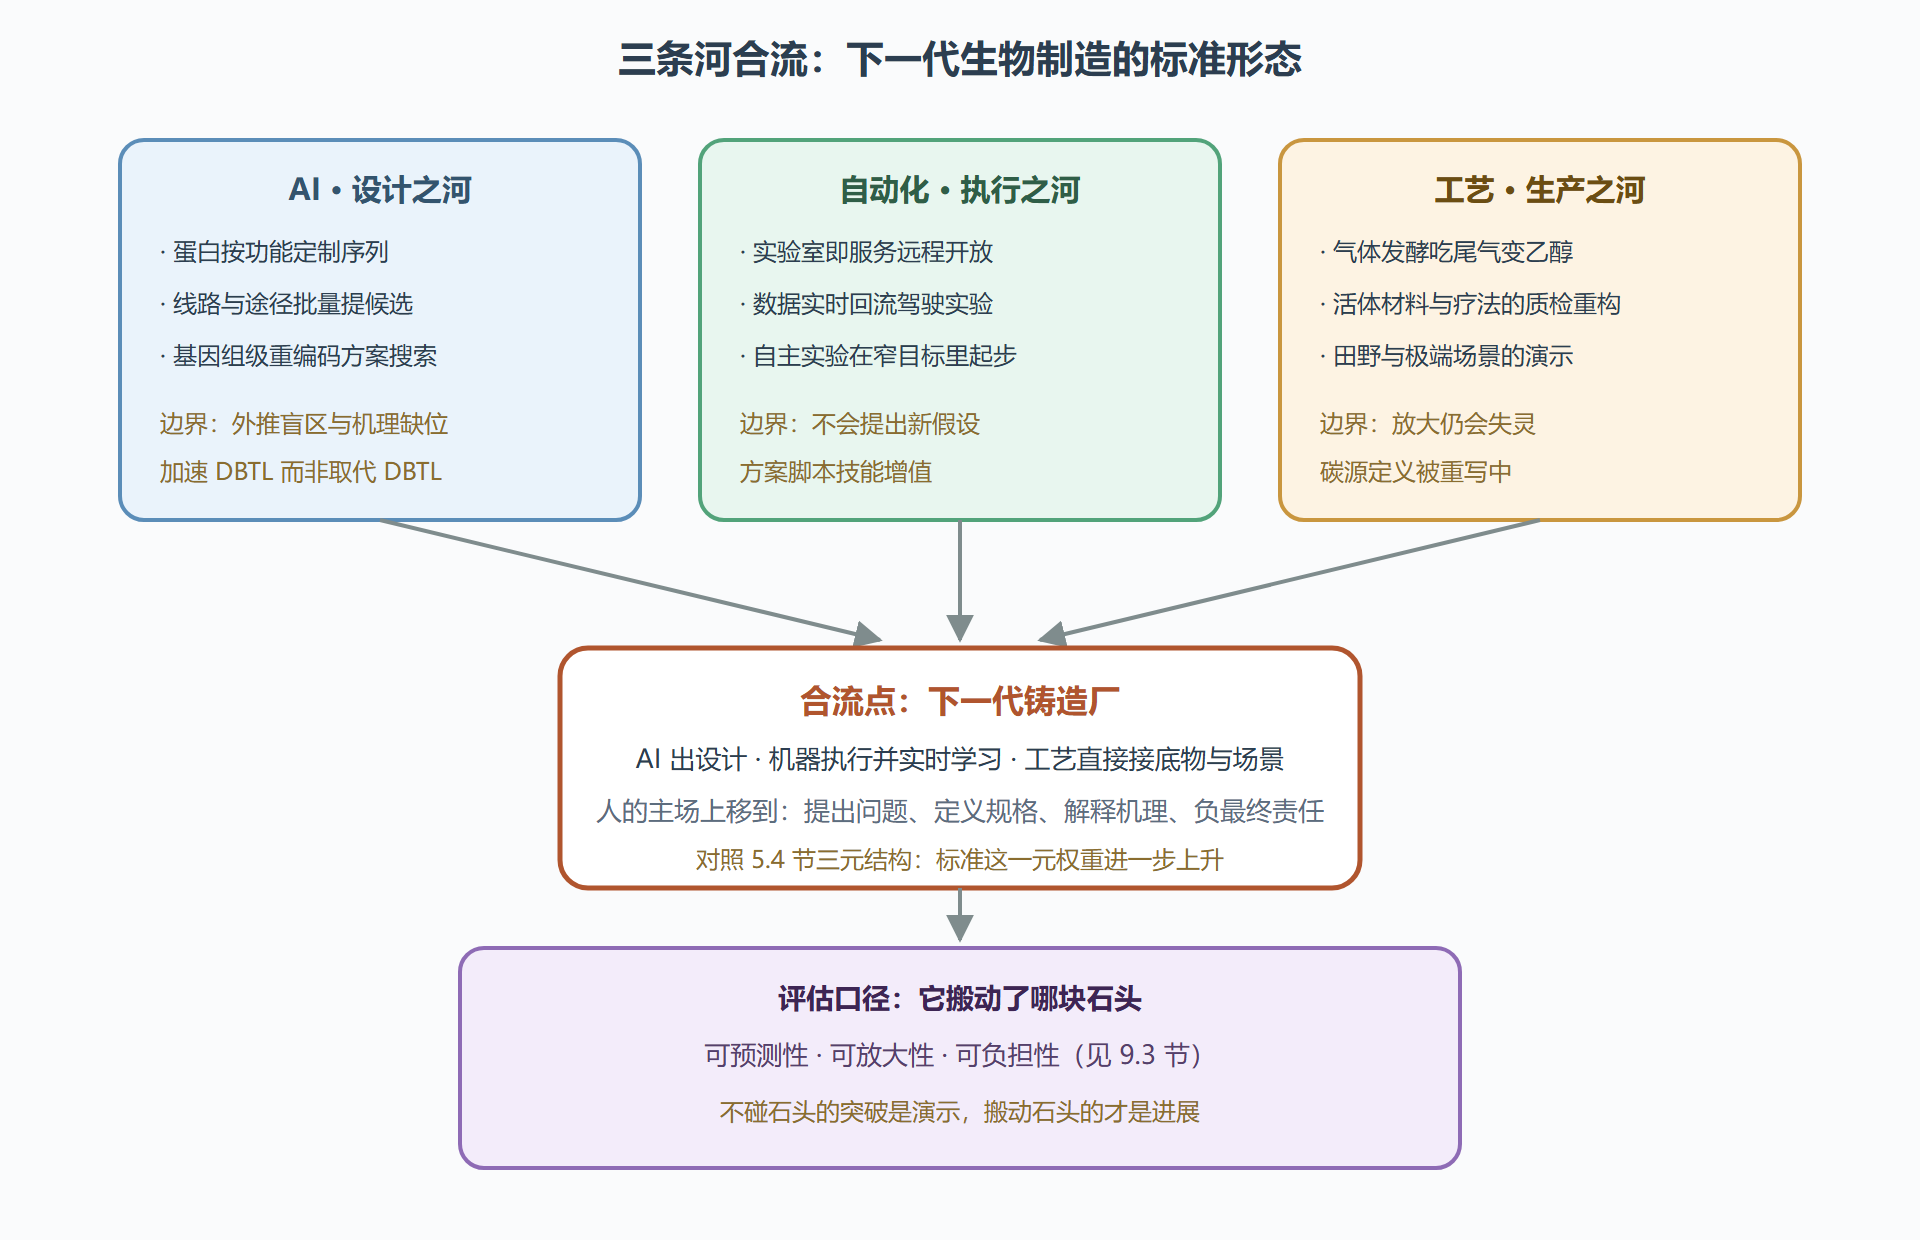
评估前沿趋势,本节采用一个贯穿全册的判据:看它搬动了 9.3 节三块石头中的哪一块。按这个判据,当前真正值得写进工程师知识结构的是三条河:AI 改写设计环节的成本曲线,自动化改写执行环节的通量曲线,工艺创新改写生产环节的原料与形态边界。三条河各自奔流,但在"生物铸造厂的下一代"这个合流点上交汇——那里的形态,大概率就是十年后这门学科的标准作业方式。
一、AI 进设计环节:从检索元件到设计元件
5.1 节说过 AI 在学习相的角色是预筛器,这里补全它在整个设计环节的版图。蛋白层面的按需设计是当前最具产业冲击力的一条:深度学习模型从"给定序列预测结构"进化到"给定功能设计序列",新酶、结合蛋白、药物分子支架开始按规格定制。它对元件库的意义是范式级的——过去元件库的上限是"自然界里找到的",现在上限变成"可以设计的"。5.2 节那本账因此要重算:买合成与从头设计的成本结构正在交叠。
线路与途径层面的生成式设计稍晚但方向明确:从历史表征数据学"元件组合到行为"的映射,为多目标需求(产量高、负担低、泄漏小)批量提候选。基因组层面的设计最激进:全基因组的密码子重编码方案(9.2 节)、最小基因组的精简设计,本质都是在巨大的组合空间里搜索,正是机器学习的主场。
必须同时记录 AI 的边界:训练数据没覆盖的参数区是模型的外推盲区,湿实验仍是最终裁决;模型不理解它预测的东西,机理学习仍是人的职责(5.3 节的分工没有反转)。行业当前的务实形态是"模型提候选、实验定真伪、数据回流再训练"——AI 加速 DBTL,而不是取代 DBTL。
二、自动化进执行环节:从工位到云实验室
5.4 节讲过铸造厂的三元结构,趋势层面有两件事正在改变它的形态。一是远程化:方案脚本上传、云端执行、数据回传的"实验室即服务"形态把铸造厂的产能开放给没有硬件的团队——7.1 节的"借厂"从阶段性动作变成常态化接口。二是闭环化:执行层的数据不再等人工分析,而是实时喂给设计层的模型,由模型决定下一个实验条件——DBTL 循环里"学习到设计"的那段回程开始由机器驾驶。这被称为"自主实验"的雏形:给定目标函数(产物滴度最大化),系统自行规划实验序列。它的第一波成功案例在培养基优化与酶定向进化这类目标明确的空间里,离"提出新假设"还有本质距离。
对从业者的含义很直接:写方案脚本的技能在增值,移液技能在折旧。5.4 节的三合一判断(懂生物、会建模、能写脚本)在这里得到趋势数据的背书。
三、工艺与材料创新:换底物、换形态、换场景
第三条河最不起眼却最接近产业本质。换底物:气体发酵让工程菌吃一氧化碳与二氧化碳(钢铁尾气直接变乙醇的装置已商业运行),农林废弃物的纤维素水解路线持续降本——6.3 节的"绿色成色三要素"里,碳源这一项正在被重新定义。换形态:活体材料与活体疗法把产品从"瓶装的分子"扩展到"活的系统"(6.3 与 6.1 节),伴随全新的质量控制问题——你怎么给"一批发酵出的活体材料"做批次放行?换场景:无细胞系统把合成生物学从车间带向田野与家庭(4.3 节的纸基诊断),太空与深海环境中的生物制造也开始有任务级演示。
图 17 三条河的合流:从今天的分工到十年后的形态
四、趋势之外:三个被高估与三个被低估
被高估的:完全自主的"AI 科学家"——假设生成与机理洞察仍是人的主场,且这个分工不因算力增长而消失;单项演示的"世界首个"——从演示到产品隔着放大与成本两座山(青蒿素的教训);通用底盘——底盘的场景特异性是常态,"一种细胞统治所有应用"的叙事反复被证伪。被低估的:测量标准化——不性感,但决定了全行业数据的复用率(4.2 节);数据治理——谁拥有表征数据、如何定价共享,将决定行业生态的形状(第 7 章);一线从业者的复合技能——行业叙事总在讲技术,实际瓶颈常常是"既懂生物又能写方案脚本"的人不够。
补充:蛋白设计的一条完整流水线
把"按功能定制蛋白"摊开成步骤,看 AI 卡在哪一环。第一步骨架生成:模型生成候选的三维折叠形状,约束是稳定可溶。第二步功能位点设计:在骨架上设计出与目标分子结合或催化的残基网络——这一步的候选通过率仍是瓶颈,湿实验验证的失败率以大百分比计。第三步序列回收:把设计好的结构反推成多条候选序列。第四步湿实验淘选:合成候选库、表达、测活——正文说的"模型提候选、实验定真伪"落在这步。第五步数据回流:测活数据回填训练集,下一轮命中率提高。整条线的加速是真实的:过去定向进化要筛数千变体的任务,现在几百个设计候选常能命中;但"设计一个全新催化反应"这类任务,仍要靠领域专家先把化学问题翻译成模型能理解的目标函数——这一步没有替代品。
问题:AI 设计的蛋白安全性怎么评估?
评估框架正在建设中,现行的务实做法是三层:序列层筛查(与毒素、致病因子文库比对,命中即人工复核);结构层评估(预测其与人体蛋白的相互作用谱);用途层审议(8.2 节的双重用途审查)。正文提到的安保盲区在这里具体化:全新设计的蛋白不匹配任何已知名单,筛查必须从"名单比对"升级为"异常性评分"。这也解释了为什么头部平台开始对新设计的序列做发布前评估——设计自由度越大,发布纪律越重要。
本节要点回顾
- 评估趋势的判据:看它搬动可预测性、可放大性、可负担性三块石头中的哪一块。
- AI 改写设计成本曲线,从检索元件到按需设计蛋白与基因组方案,边界在外推与机理。
- 自动化从工位走向云端与闭环,方案脚本技能增值、移液技能折旧。
- 工艺创新换底物、换形态、换场景,碳源的定义正在被重写。
- 三个高估(自主 AI 科学家、单项演示、通用底盘)与三个低估(测量标准、数据治理、复合人才)。
河流讲完了。下一节走得更远:当人类不再满足于改造现有生命,开始另起炉灶。