4.1 网关与转换技术
4.1 网关与转换技术
本节摘要:网关是两种协议世界观之间的翻译官——对下用主站身份轮询 Modbus 设备,对上用服务器身份发布 UA 变量。本节拆解轮询引擎、数据缓存、发布层的三段结构,讲透透传与聚合两种模式的选择逻辑。
先看一台网关的内部
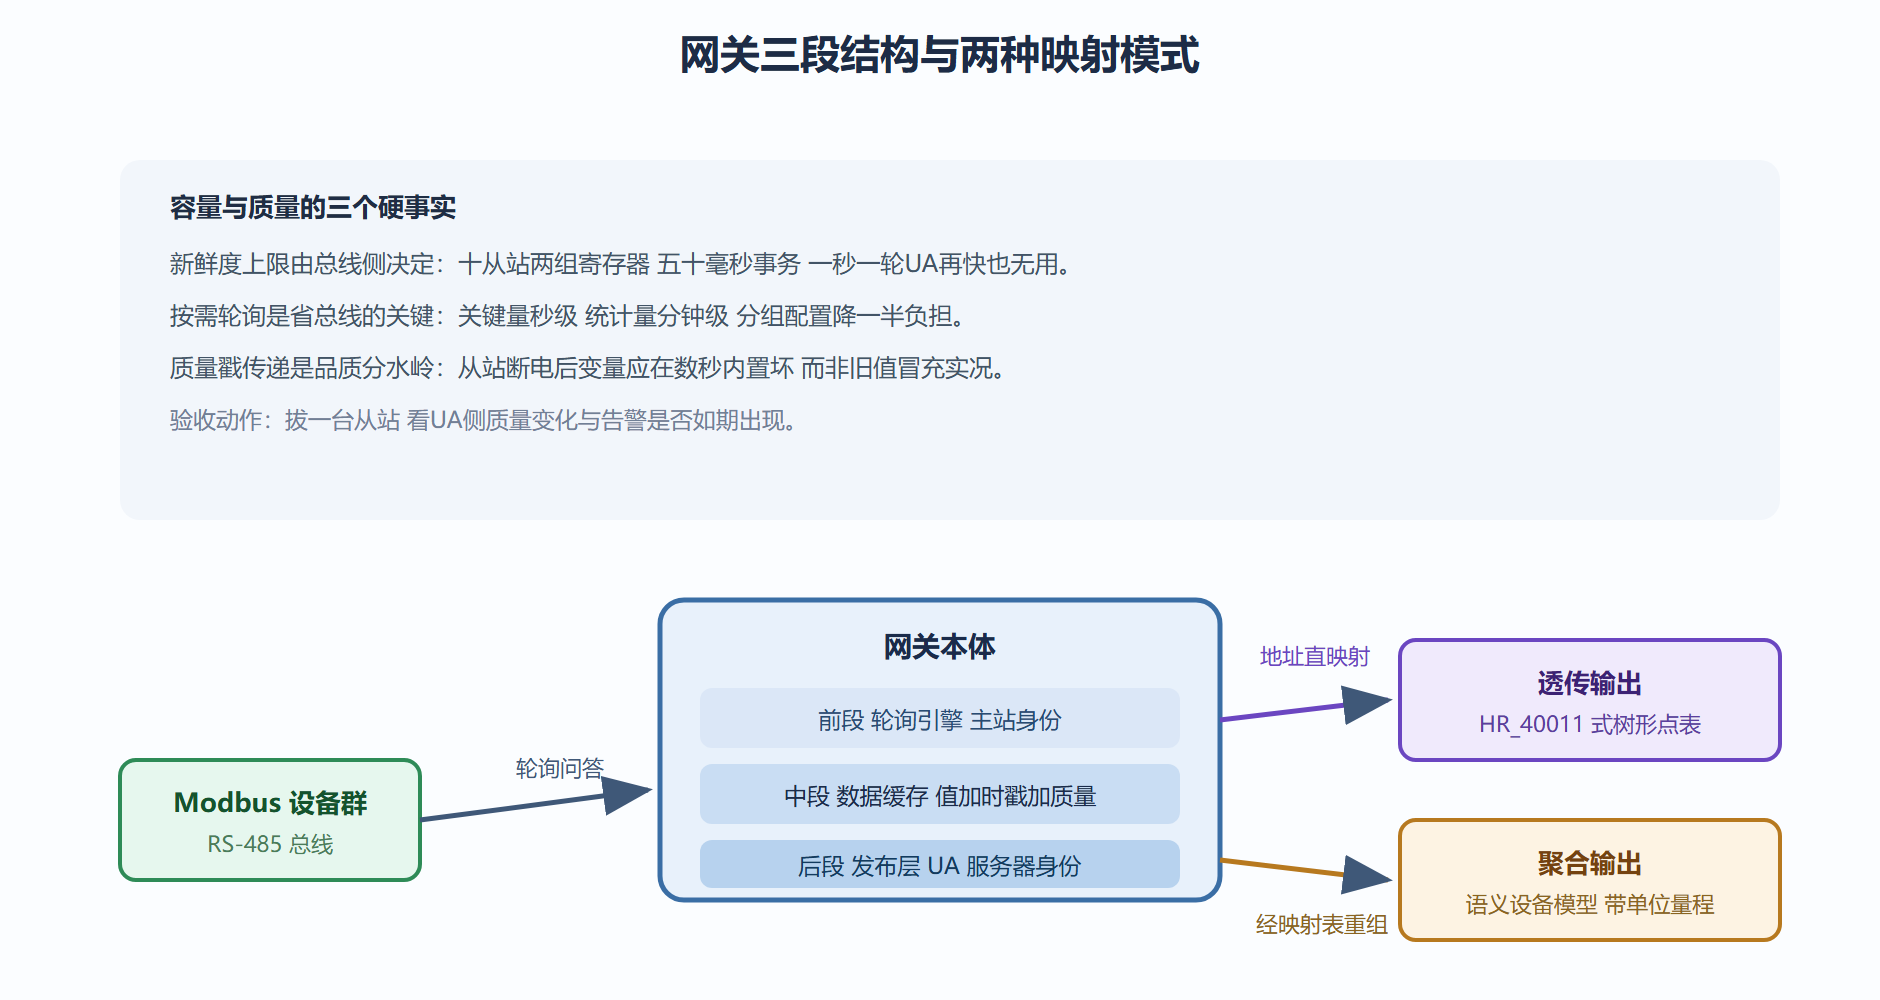
把一台正在工作的协议网关沿数据流剖开,会看到三段结构。前段是轮询引擎:它扮演 Modbus 主站,按配置的周期向总线上每台从站发起读写,与第 2 章学的主站行为别无二致——超时、重试、异常码处理,一样都不少。中段是数据缓存:一张实时数据库表,每个点位一行,存着最新值、时间戳与质量戳,轮询引擎写它,发布层读它。后段是发布层:它扮演 UA 服务器,把缓存表里的行映射成地址空间里的变量,对外提供第 3 章讲过的全部服务。
三段结构解释了网关行为的许多"怪癖"。为什么 UA 侧读到的时间戳有时是几秒前的?——那是中段缓存里轮询写入的时刻,不是你读取的时刻。为什么总线上某个从站死机了,UA 侧的变量没有消失而是停在旧值?——轮询失败时引擎会把质量戳置坏,好的实现会让变量值带着"坏质量"标记,糟糕的实现则让旧值安静地躺着冒充实时数据。质量戳的传递是评价网关品质的第一指标。
学习目标
阅读完本节,你应当能够:
- 画出网关三段结构并说明各段的职责与性能瓶颈;
- 判断一个项目该用透传模式还是聚合模式;
- 估算网关的容量上限(点位数、轮询周期、发布频率的相互约束);
- 识别低质量网关的三个典型症状。
一、轮询引擎:网关里住着一位 Modbus 老师傅
前段的核心约束直接继承自第 2 章的轮询时间账:总线的采集周期由最慢事务决定,网关自己再快也没用。这带来第一个容量公式——总线侧能力 = 从站数与寄存器组数决定的最小轮询周期。十台从站、每台两组寄存器、单事务五十毫秒,这条总线的物理极限就是一秒一轮。UA 侧无论怎么订阅,数据的新鲜度都被钉死在一秒。项目评审时若有人承诺"网关侧做到百毫秒刷新",先让他算总线的账。
轮询引擎的第二个设计空间是按需轮询。不是所有点位都需要同频刷新:关键的工艺量一秒一轮,统计用的累计量一分钟一轮足够。把点表按刷新率分组、每组配独立周期,能把总线负担降一半以上。看一台网关是否成熟,就看它的轮询配置是不是"每点位可设周期",而不是全网一个全局参数一杆秤。
第三个关注点是异常传播。从站超时、CRC 失败、异常码返回,这些事件不应被网关消化掉,而应变成 UA 侧的质量标记:好、不确定、坏三级。上游系统看到"坏"就该把告警顶出来,而不是拿着过期数据继续计算。验收网关时专门制造一次从站断电,看 UA 侧变量是否在合理时间内变成坏质量——这一招能淘汰市面上相当一部分产品。
二、透传与聚合:两种模式的选择
透传模式把 Modbus 地址空间几乎原样映射到 UA 侧:寄存器 40011 变成命名空间 3 下的一个变量,名字、顺序都与点表一致。好处是映射规则零歧义、调试时两侧对照方便;代价是语义仍然缺失——变量叫 HR_40011,单位量程一概没有,上游拿到的只是"树形点表"。透传适合过渡期场景:先让数据流通,语义随后补。
聚合模式以设备为中心重组数据:网关里为每类设备定义了 UA 模型(3.4 建的泵类型就是素材),轮询来的寄存器值按映射表填进模型的变量,上游看到的是一台台结构化的"语义设备"。好处是上游零负担、跨项目模型可复用;代价是映射表本身成了新的维护对象——设备固件升级改了寄存器布局,映射表必须同步改。聚合是终态,透传是脚手架,成熟项目通常先透传后聚合,分两步走。
| 维度 | 透传模式 | 聚合模式 |
|---|---|---|
| 映射规则 | 地址对地址,机械 | 经模型重组,需映射表 |
| 语义质量 | 无(树形点表) | 单位量程状态齐全 |
| 调试难度 | 低,两侧直接对照 | 中,须经模型定位 |
| 维护成本 | 几乎为零 | 映射表随固件演进 |
| 适用阶段 | 通路验证、过渡期 | 正式交付、长期运行 |
图14 网关三段结构与两种模式的数据通路
三、容量规划与选型清单
给网关做容量规划,三个数字相互牵制:点位总数、总线轮询周期、UA 侧发布频率。规划顺序从总线侧起算(它最硬),先按 4.1 的轮询账算出数据新鲜度上限,再确认上游能否接受;UA 侧的发布能力一般不是瓶颈,除非订阅点位上千且频率拉满。设备资料页上"支持 1 万点位"这类数字,指的是缓存容量,不是采集能力——宣传口径与工程口径的差异,评审时要当面戳破。
选型时按这张清单过:轮询周期是否支持按点位分组配置;质量戳是否三级传递并可订阅;断线恢复后缓存与订阅的续传行为是否可配置;固件升级是否会影响映射表(有版本管理机制的为佳);日志能否输出原始报文(对接 2.4 的抓包排错法)。五个问题问完,产品档次高下立判。
⚠️ 常见坑:把网关当透明管道验收——只测"能读到数",不测断线、不从站、越界这些边界。网关的价值恰恰体现在异常路径上:平时大家都好,出事时的行为才分出品。
四、两种模式之间的中间态与实测要点
透传与聚合之间还有一个实用的中间态:带语义标签的透传——映射关系保持地址对地址,但给每个变量挂上最小的语义三件套(单位、量程、简短描述)。它不需要设备类型定义,工作量只比纯透传多一点,却让上游系统获得了"不查文档也能正确显示"的基本盘。项目排期紧张时,这是性价比最高的折中:先上线带标签的透传,二期再演进到完整聚合。
无论选哪种模式,选型前都该做一次实测,项目单上写"支持聚合模式"不等于"聚合模式好用"。实测清单四项:用聚合模式发布一台测试设备,看模型是否完整可浏览;故意断掉串行侧一台从站,看 UA 侧质量标记的时延;连续运行一小时,看网关内存是否平稳(映射表与缓存泄漏是低质产品的重灾区);固件升级一次,看映射配置是否原样保留。四项实测的成本是半天,换来的判断力超过任何产品彩页。
五、边界职责:网关管什么不管什么
集成扯皮的一大来源是网关职责边界模糊。给一条可写进技术协议的划分:网关负责协议语法与会话维保——字节转换、轮询调度、断线重连、质量戳传递;网关不负责语义裁决——点表对错、单位换算、工艺联锁属于两侧系统的责任。边界划清后,"画面显示不对"这类工单有了快速分岔:原始字节就不对,往总线侧查(第 2 章方法);字节对而显示错,往映射与组态侧查(4.2 方法)。先分侧再动手,多数"数据不对"的工单止步于此,抢修时间省一半。
这条边还有个衍生好处:网关选型时可以理直气壮砍掉"内置逻辑""本地联动"这类越界卖点——功能越多故障面越大,职责越糊。网关在系统里的角色是翻译,不是裁判;越简单越可靠,这在 6.2 的部署参数里会再次得到印证。
本节要点回顾
- 三段结构:轮询引擎、数据缓存、发布层各司其职,数据新鲜度的上限钉在总线侧;
- 质量戳是灵魂:异常必须以质量标记传递到 UA 侧,旧值冒充实况是最危险的静默故障;
- 透传与聚合:透传是脚手架、聚合是终态,成熟项目分两步走;
- 容量从总线算起:点位数、轮询周期、发布频率三数牵制,规划先算最硬的约束。
通道搭好了,下一节处理更难的部分:怎么让翻译过来的数据带着正确的含义。