4.3 解码模型与机器学习:推断、选型与评估的坑
4.3 解码模型与机器学习:推断、选型与评估的坑
本节摘要:解码是统计推断:从带噪特征猜最可能的意图。线性判别分析凭"少样本下稳健、推理成本低"长期占据实用系统的位置,支持向量机与逻辑回归紧随其后;深度网络在数据充足与原始波形输入的场景中后来居上;连续控制则靠卡尔曼滤波一类的递推估计。本节给出模型选型矩阵、信息传输率的计算方法,以及脑机接口评估中最常见的陷阱——错误的交叉验证如何把成绩虚报上去。
上一节把波形压成了特征,这一节要把特征变成答案。但先把期待值校准一下:解码模型在多数实用系统里的作用是"临门一脚",把准备好的特征变成分类结果;特征决定了上限,模型决定接近上限的程度。把两件事的分量搞反,是新人最常见的用力方向错误。
分类器三杰
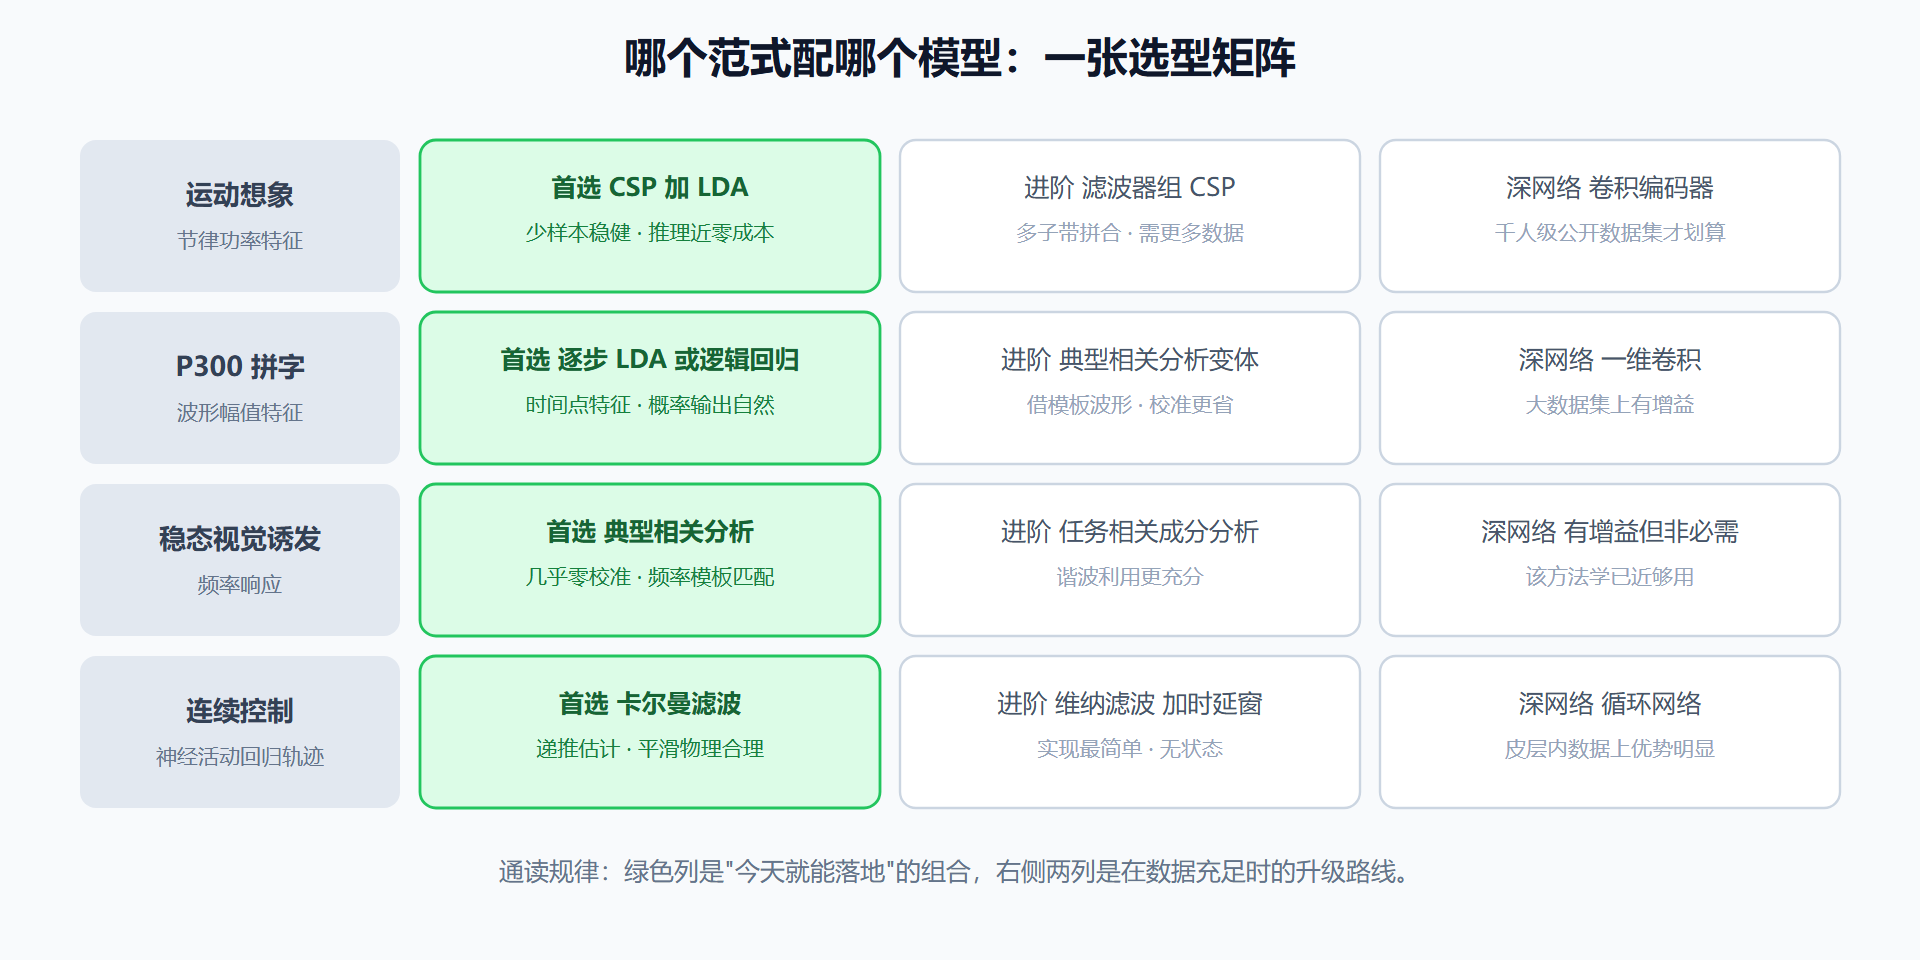
**线性判别分析(LDA)**是运动想象系统的常青树:假设两类特征协方差相同,解一个线性判别面。它的优点几乎全是为脑机接口量身定做的——训练需要的样本少(每类几十个试次就能用)、只有一次矩阵求逆没有迭代、推理成本一乘一加、还能自然输出后验概率。缺点是线性假设在特征高度非线性时会吃亏。**支持向量机(SVM)**用核函数处理非线性边界,中小样本下表现稳定,但核矩阵的规模随样本数平方增长,且概率输出要额外校准。逻辑回归给出干净的概率解释,配合正则化在小样本下也稳,是多分类拼字系统里务实的选择。
选型的经验法则可以压成一句话:**特征好,线性就够;特征弱,换模型也救不动多少。**实践中把时间花在特征与预处理上,通常比花在模型上回报高得多。
图 4-2:范式与模型的选型矩阵
连续控制:回归与卡尔曼
分类范式输出离散类别,连续控制(光标、机械臂轨迹)输出的是连续量,问题从分类变成回归。实用系统的主力是卡尔曼滤波:把手部状态(位置、速度)建成线性动力学系统,神经活动作为对速度的观测,逐帧递推更新状态估计。它赢在两点:一是递推结构天然平滑输出,光标不抖;二是显式建模了运动连续性——上一帧在向左飞,下一帧不可能瞬间到右边。皮层内系统的轨迹解码(BrainGate 系列的机械臂控制)把这套方法用到了天花板,有兴趣深挖的话,第五章闭环部分会接着讲它在实时回路里的位置。
深度学习:什么时候值得上
卷积网络直接吃原始时域波形,跳过人工特征——这既是它最大的卖点(自动学特征),也是最大的代价(需要数据喂养)。经验上的分界线:单被试一两百个试次的自建数据集,线性模型加好特征几乎总是更优;千人级的公开数据集(多被试、多会话),端到端的卷积编码器开始显示优势,且预训练加微调的策略能把新用户的校准成本大幅压低。数据量决定深度的性价比,这条铁律在脑机接口里比在图像领域更严酷,因为每多一个被试就要重新面对传感器位置的个体差异。
评估:脑机接口的头号陷阱
轮到本节最重要的一段。脑机接口的数据有一个图像领域没有的结构:同一被试同一会话内,相邻试次高度相似(电极状态、疲劳度、基线漂移都是共享的)。如果你的交叉验证按试次随机划分——第 1、3、5 个试次训练,第 2、4 个测试——测试试次的"邻居"就在训练集里,模型抄了近道,成绩虚高。八成准确率的系统被虚报成九成五,审稿人与买家都看不出来,直到上线那天现出原形。
正确的姿势是按数据块划分:以会话或以连续十分钟的数据块为单位切分,保证测试块与训练块来自不同时间段。跨被试评估(留一被试)则回答"能不能不校准直接用"的问题——成绩会难看得多,但那才是通用产品的真实起点。记住这条,你就能识破一半的脑机接口性能注水。
最后给一把统一的尺子——信息传输率(ITR),它把"分类数、准确率、每分钟能做几次决策"折算成每分钟比特数,让不同范式的成绩可以同台比较:
import math def itr_bits_per_min(accuracy, n_classes, decisions_per_min): """Wolpaw 信息传输率:比特每分钟""" p = accuracy m = n_classes if p <= 0 or p >= 1: raise ValueError("准确率需在 0 与 1 之间") single = math.log2(m) + p * math.log2(p) + (1 - p) * math.log2((1 - p) / (m - 1)) return single * decisions_per_min # 例:四分类、九成准确率、每分钟十二次决策 print(round(itr_bits_per_min(0.9, 4, 12), 1), "比特每分钟") # 约 25.7 比特每分钟——对照:熟练打字每分钟数百比特
跑一遍就能体会 1.3 节说的"数量级差距":非侵入式系统的典型 ITR 在每分钟十到三十比特,而普通打字在每分钟数百比特。这把尺子也是 5.5 节拼字复盘的记分牌。
本节要点回顾
- 特征定上限,模型定接近度:时间优先投给特征与预处理;
- LDA 是运动想象默认款,SVM 与逻辑回归按非线性需求与概率需求补位;
- 连续控制用卡尔曼:递推估计自带平滑与运动连续性;
- 深度网络看数据量:单被试小数据线性更优,千人级数据端到端才有性价比;
- 交叉验证必须按块划分:按试次随机划分等于让模型抄近道,ITR 是跨范式比成绩的统一尺子。
概率校准:让置信度说真话
2.3 节立过一条纪律:解码输出应携带置信度。本节补上它的技术后半段——置信度本身需要校准。多数分类器的原始输出(判别得分、到超平面的距离)并不是概率:得分 0.9 不代表九成把握,可能只有七成,也可能虚高到九成九。直接拿未校准的得分当置信度,闭环系统里会出现系统性误判——系统总在"很有把握"地犯错。校准的思路是拿一份模型没见过的验证数据,统计"输出得分 s 的预测实际对了多少次",再拟合一条把得分映射到真实频率的曲线(等值回归或温度缩放是常用手段)。校准后的置信度才配进第五章的决策逻辑里:低置信降速、求确认、触发纠错,全部建立在"零点八真的意味着八成"之上。这条工序在论文里常被省略,在产品里却是标配——校准是模型与闭环系统之间的接口协议,漏掉它,5.4 节的加权融合和 7.1 节的责任日志都建立在虚数之上。
模型选好了、成绩也量准了。下一节处理真实世界的最后一关:用户在变、电极在漂,模型怎么跟上。