4.2 统计过程控制与控制图
4.2 统计过程控制与控制图
本节摘要:统计过程控制(SPC)用控制图把过程波动分成两类:随机的正常波动与有因的异常波动,从而回答两个问题——现在该不该干预?过程能力够不够交付公差?本节给出控制限的完整算法、常用控制图的选型表、八条判异规则的使用分寸,以及过程能力指数的计算。算例全部可复算。
任何过程的输出都有波动。车间里两种人对波动的反应截然相反:新手看到每个波动都想调机,老师傅对多数波动视而不见、只在关键时刻出手。SPC 的价值是把手感变成规则——控制图就是那张让"什么时候该出手"有据可查的仪表。
一、两类波动:管错比不管更贵
休哈特把波动分成两类。普通原因波动:过程固有的、大量微小因素叠加的随机起伏——同一台机床、同一批料、同一套模具下,尺寸自然会在一个范围内晃。特殊原因波动:特定因素介入造成的异常——刀具磨损到限、料批混料、温度探头漂移。
区分两类波动的意义在干预决策上:对普通原因波动调机,是给随机噪声加反馈,结果是把波动越调越大(此现象在调机师傅里叫"追波动",统计学上叫过度调整);对特殊原因波动坐视不管,则不良会持续流出。控制图的任务就是给出判据:点在控制限内、且无异常模式,过程"受控",别碰它;出限或出现模式,过程"失控",先找特殊原因再谈别的。
一个必须掰清的概念区分:受控不等于合格。受控只说波动稳定、可预测;若稳定的中心线本身偏在公差带边缘,过程会稳定地生产不良品。所以完整判断分两步:先用控制图判稳定性,再算过程能力指数判充足性——两步都过,才叫能稳定交付。
二、控制限怎么算:以 Xbar-R 图为例
计量型数据(长度、重量、时间)最常用 Xbar-R 图:每组分若干个(通常 5 个)连续测量值,组均值看中心位置,组极差看散布幅度。控制限不是公差,它完全由过程自身数据算出:
Xbar-R 控制限计算(某轴径,公差 9.95 至 10.05 mm) 抽样:25 组,每组 n=5 总均值 Xbarbar = 10.002 mm 平均极差 Rbar = 0.026 mm 系数(n=5):A2=0.577 D3=0 D4=2.114 Xbar 图:UCL = 10.002 + 0.577×0.026 = 10.017 LCL = 10.002 − 0.577×0.026 = 9.987 R 图: UCL = 2.114×0.026 = 0.055 LCL = 0 判稳:25 组无出限、无模式 → 过程受控 能力(受控前提成立后才计算): σ ≈ Rbar ÷ d2 = 0.026 ÷ 2.326 = 0.0112 Cp = (0.05) ÷ (6×0.0112) = 0.744 Cpk = (10.05 − 10.002) ÷ (3×0.0112) = 1.43 不对—— 应取两侧较小值:(10.05−10.002)=0.048;(10.002−9.95)=0.052 Cpk = min(0.048, 0.052) ÷ 0.0336 = 1.43 Cp = 0.05 ÷ 0.0672 = 0.744? 修正:6σ=0.0672,Cp=0.05÷0.0672=0.744
等一下,上面 Cp 与 Cpk 矛盾了——Cpk 永远不大于 Cp,问题出在 σ 估算后的粗心。重算:σ=0.026 ÷ 2.326 ≈ 0.0112,6σ=0.067,公差全带宽 T=0.10,Cp=0.10 ÷ 0.067 ≈ 1.49。Cpk 取较小单侧:0.048 ÷ (3 × 0.0112)=0.048 ÷ 0.0336 ≈ 1.43。结论:Cp≈1.49、Cpk≈1.43——中心略偏上(总均值 10.002 高于公差中心 10.000),能力尚可但逼近 1.33 的常见门槛。这道题留着两版计算是有意的:现场九成的能力指数错误都是粗心错——σ 用错估算系数、Cpk 只算了一侧、公差带宽用错单双侧,数值全变。发布任何能力报告前,用"Cpk 不大于 Cp"这条恒等式自检一遍。
| 数据类型 | 场景 | 推荐控制图 |
|---|---|---|
| 计量型 | 尺寸、重量、时间 | Xbar-R(子组)或 I-MR(单值) |
| 计件不良 | 不良品个数 | p 图(比例可变)或 np 图 |
| 计点缺陷 | 疵点、事故次数 | c 图(面积固定)或 u 图 |
| 小批量多品种 | 定制加工 | 目标图或 I-MR 标准化 |
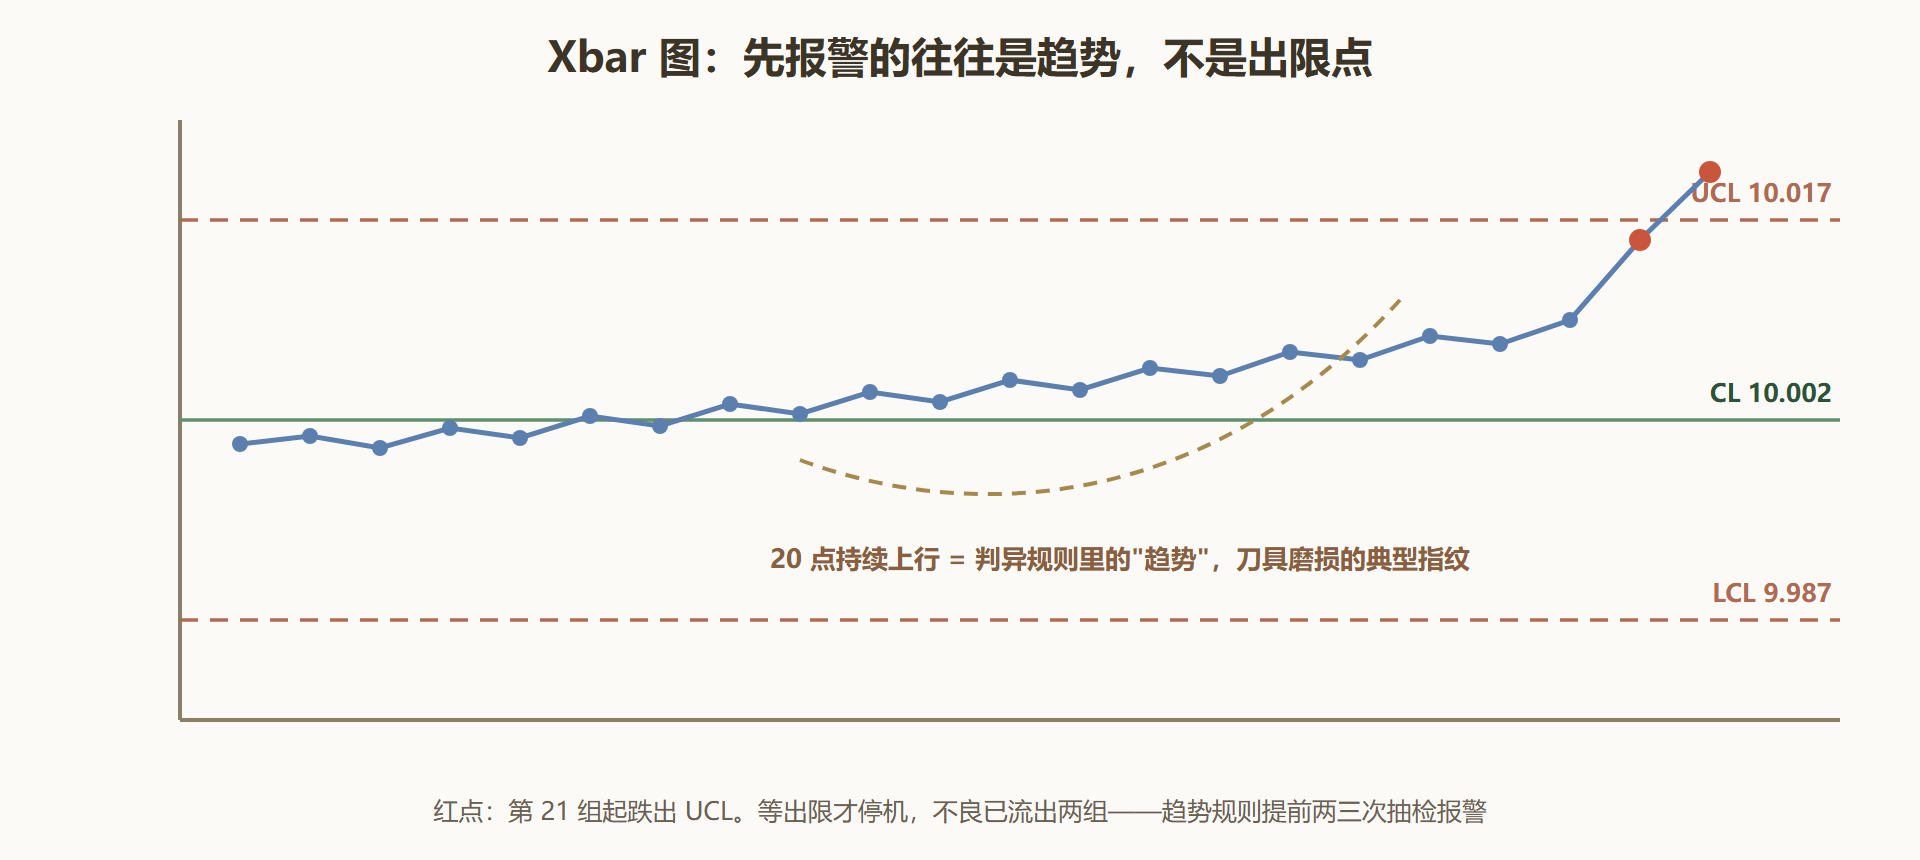
图 4-2 一张失控的 Xbar 图:模式比单点更早报警
三、判异与能力的使用分寸
控制图判异不止"出限"一条。最常用的还有:连续多点在中心线一侧(7 点规则,提示均值已漂移)、连续上升或下降的趋势(提示刀具磨损、温度漂移这类缓变因素)、点在控制限附近密集跳跃(提示组内混入了不同来源的数据)。规则不必全背,选两三条与自己过程的风险模式匹配的即可;规则堆得越多,虚报警报越多,图很快会被"狼来了"淹没。
能力指数的使用分寸三条。其一,先判稳再算能力:失控过程算出的 Cp、Cpk 是无意义的算术。其二,门槛看行业与代价:一般机加常见门槛 1.33,安全件 1.67;门槛的本质是"不良率与拦截成本的平衡",不是玄学分数。其三,子组取样要短时连续:每个子组内的 5 件应当来自几分钟内连续生产——子组内只允许普通原因波动,特殊原因要让它体现在组间。取样方法错了,控制限全错,这是 SPC 推广失败的第一原因。
四、完整案例:包装线的重量控制
背景:某食品厂定量包装线标称 500 克,行业标准要求单件不低于标称的 95%、平均不低于标称。厂里为保下限把目标设到 512 克,每包多给 12 克,一年白送原料约 60 万元;而抽检仍偶有单件触线。
操作:质量工程师在灌装口做短时连续取样,每小时取一组 5 包、连取 20 组,算出 I-MR 与 Xbar-R 双图。发现过程受控但总均值 512、标准差约 3.2 克——问题是散布太大:要保 500 克下限按 99.9% 把握,均值必须放在 500 + 3σ ≈ 510 克附近。第二步降散布:极差图显示第 7 与第 15 组异常,追溯到两条料仓的下料阀开度有 0.3 圈差异;统一开度并加装阀门定位器后,标准差降到 1.4 克。第三步收均值:目标重量从 512 降到 504.5 克(留 3σ 余量仍有 99.9% 把握)。
结果:单件不足风险未变,每包平均少给 7.5 克,年省原料约 38 万元;项目全部投入是一台定位器与两周的取样工时。
解读:这个案例把 SPC 的商业本质演得干净:控制图管稳、能力指数管省——σ 每缩小一半,均值就能向公差中心挪回一个 1.5σ,省下的全是白送出去的"保险原料"。质量做的不是良心生意,是精算生意。
五、易错点与自查
其一,把公差线画在控制图上当控制限:两套线管两件事,混画必乱。其二,用历史杂乱数据建限:控制限要用判稳后的近期数据重新计算,旧数据里的特殊原因会撑宽控制限,让图永远"太平"。其三,子组内隔天取样:组内混入长期变化,组内极差虚高,σ 估算失真。其四,Cpk 季度刷分:能力是给改善定靶的(Cp 与 Cpk 的差就是中心偏移的改善空间),刷分不改善等于体温计擦酒精。
本节要点回顾
- 两类波动两种态度:普通原因别调机,特殊原因必须查——管错比不管更贵。
- 受控不等于合格:控制图判稳、能力指数判足,两步走完才算能交付。
- 控制限由数据自生:Xbar-R 的系数表会帮你,但子组取样方法决定生死。
- 判异规则宁少勿滥:趋势规则常比出限更早报警。
- 能力提升直接换钱:σ 减半,均值回收 1.5σ,包装线一年省 38 万。
波动管住了,下一节把镜头拉高:改善作为一个项目该怎么组织——精益给靶子,六西格玛给流程。