1.2 核心数学与统计学工具箱:让信号可度量、可检验
1.2 核心数学与统计学工具箱:让信号可度量、可检验
本节摘要:量化研究的母语是时间序列分析、概率分布与统计推断。本节按"用"来讲这三样工具:平稳性判断决定你能否直接对价差建模,尖峰厚尾决定你该用什么指标度量风险,假设检验则守护你免受随机性的恭维。上一节解决了"对什么交易",本节解决"如何可靠地度量它"——这是第二章回测流水线的前置装备。
为什么价格序列不能直接当数据用
拿到一段日频价格序列,新手的第一反应是直接算收益、跑回归。麻烦在于,价格本身几乎总是非平稳的:它带着趋势漂移,均值和方差随时间变化,任何"价格高则卖出、低则买入"的规则都建立在"价格会回到某个固定中心"的隐含假设上,而这个假设对指数类资产往往不成立。所以研究的第一步通常是把价格转成对数收益率——它更接近平稳,可加性也好。进一步,多数价差类策略(比如配对交易)在下单前必须回答:两只标的的价差是否平稳?如果价差本身漂移不定,"回归均值"就是一句空话。工程上常用的检验是单位根类检验:原假设是序列存在单位根(非平稳),拒绝它才敢谈均值回归。
以下这段示例代码演示对一段价差序列做平稳性检验的基本流程,输出会给出统计量与对应结论:
import numpy as np def adf_style_check(spread, lags=1): """教学版平稳性检查:对价差序列做自回归并检查均值回复倾向。 spread: 两条对数价格序列之差(numpy 数组) 返回:回复强度估计与简单的显著性参考 """ x = np.diff(spread) # 价差的一阶差分 lag = spread[:-lags] # 滞后一期的价差水平 # 回归 x = a + b * lag + e,b 显著为负说明偏离会被拉回 X = np.column_stack([np.ones_like(lag), lag]) beta, *_ = np.linalg.lstsq(X, x, rcond=None) b = beta[1] resid = x - X @ beta se = np.sqrt(np.sum(resid**2) / (len(x) - 2)) / np.sqrt(np.sum((lag - lag.mean())**2)) t_stat = b / se return {"回复系数": b, "t统计量": t_stat} # 用法示例:spread = np.log(px_a) - np.log(px_b) # t 统计量越负,均值回复倾向越强;正式研究请使用成熟计量库的完整实现
这段代码的教学价值不在精度,而在它揭示了检验的本质:所谓"价差会回归",是一个关于回复系数符号与大小的可证伪命题。凡是不能写成这种命题的策略逻辑,都还没到能回测的阶段。
收益分布:尖峰厚尾告诉我们的事
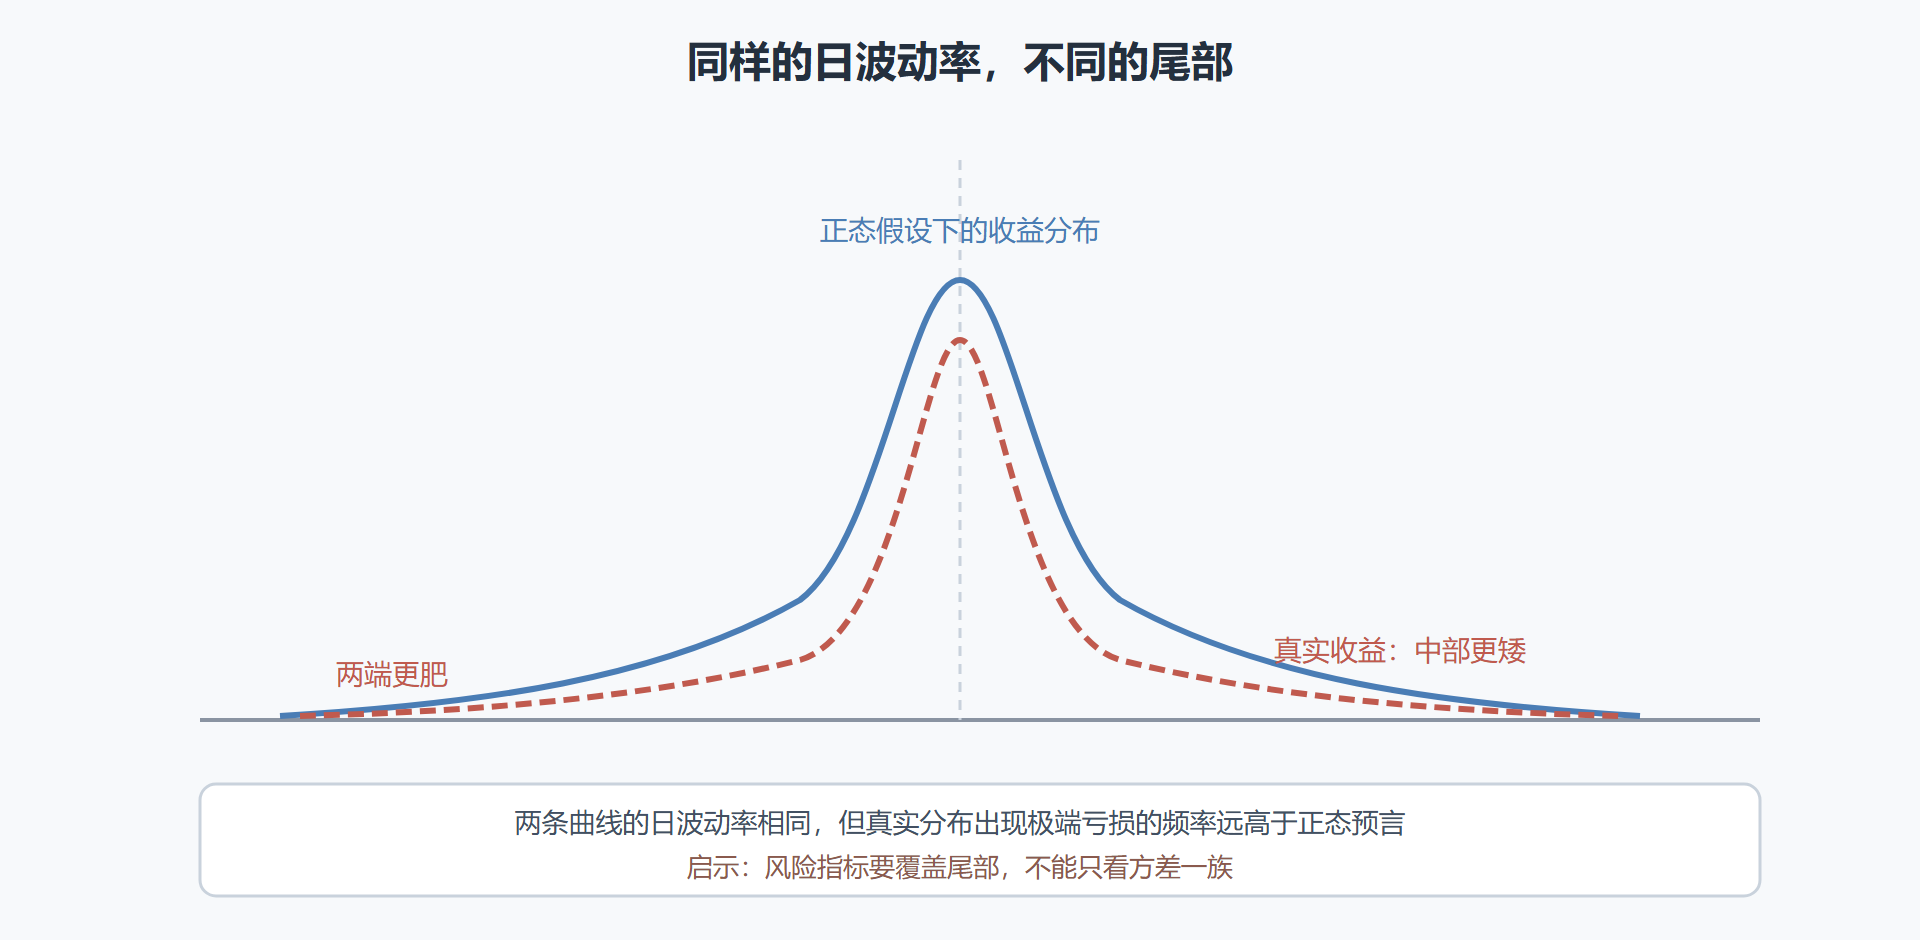
金融收益率的经验分布与正态差得很远:极端事件出现频率远高于正态假设的预言,两侧尾巴又肥又长。这不是学术洁癖问题,它直接改写风险度量。基于方差类度量的指标会系统性低估尾部风险;两个日波动率相同的策略,其深度亏损的频率与幅度可能相差数倍。这就是为什么第五章会同时引入多种风险指标——它们各管一段分布。对策略研究者的日常要求是:看到任何基于"收益率服从正态分布"推导出的漂亮结论,先问一句尾巴怎么算。历史上多次著名的基金崩塌,事后复盘都能找到"低估了同时发生多个标准差级别波动的概率"这条根。
图 1-3:同一波动率下两种收益分布的风险差异(示意)
假设检验:对抗随机性恭维的哨兵
回测结果的受众是自己的资金,所以每一句"策略有效"都应该翻译成一个检验:在"策略其实无效"的原假设下,看到这样或更好的历史表现,概率有多大?这个问题的严谨答案涉及多重检验校正——你试过的每一个想法都会抬高"碰巧好看"的概率,试得越多,单次的显著性门槛就该越严。工程上还有两个朴素的替代手段:一是打乱信号时点做随机对照,把策略收益与"随机进出场"的分布比较;二是把样本切成互不重叠的多段,看结论是否在多数时段成立。这些手段不够精致,但对付"把噪音当规律"这个最常见的错误,效果意外地好。
| 工具 | 回答的问题 | 典型误用 |
|---|---|---|
| 平稳性检验 | 价差能否谈均值回归 | 对漂移序列硬套回归规则 |
| 相关与自相关 | 信号与收益是否存在可利用关系 | 把高相关当因果、忽略多重检验 |
| 分布刻画 | 尾部风险有多大 | 用正态假设低估极端亏损 |
| 随机对照 | 表现是否优于瞎猜 | 只与零收益基准比较 |
| 分段验证 | 结论是否跨时段稳定 | 全样本调参后只报最好一段 |
深入一步:一次完整的伪信号解剖
把工具箱用在一个具体案子上。假设你发现"某指数在周五的表现与下一周的周一表现相关",样本三年,相关系数可观。用本节的工具过一遍:第一步,分段验证——把三年切成六段,若相关性只在其中两段显著,多半是样本期的巧合。第二步,多重检验意识——你(或别人)在此之前可能已经试过星期二对星期三、月末对月初、上午对下午;试过二十种日历效应后挑出最亮的一个,它的显著性必须按二十次试验打折。第三步,随机对照——把"下一周"整体平移一天或一周,若相关性消失,说明你捕捉的可能是结算周期这类真实机制;若怎么平移都"显著",反而要怀疑计算过程有数据泄漏。三步走完还活着的规律才值得进入回测。这套流程的全部价值在于:它把"我发现了一个规律"的兴奋,转译成"这个规律在多大比例的扰动下存活"的冷静问题。
💡 关键直觉:统计工具箱的全部意义,是把"看起来有效"翻译成"在多少次独立考验中存活"。翻译不过去的规律,不值得任何资金。
本节要点回顾
- 先变换再建模:价格序列大多非平稳,收益率或价差平稳性是回测前的必要检查;
- 回复系数必须显著:均值回归逻辑要落实为可检验的系数符号与显著性,不能停留在叙事;
- 尾部决定生死:尖峰厚尾意味着方差类指标低估极端风险,第五章会展开补位指标;
- 显著性要算上尝试次数:试过的每个想法都在抬高运气成分,多重检验意识必须贯穿;
- 朴素手段照样有效:随机对照与分段验证是性价比最高的防自欺工具。
💡 关键直觉:统计工具的角色不是帮你证明策略有效,而是帮你在被市场收费之前,先自己把无效的假设杀掉。
带着这套量具,下一节我们去审视收益来源的合法性——金融经济学原理要回答"凭什么赚钱"。