3.3 DMA:让外设自己搬数据
3.3 DMA:让外设自己搬数据
本节摘要:DMA 引擎让外设绕开 CPU 直接读写内存。本节讲清 DMA 解决什么问题、一致性与流式两种映射的分工、一次完整传输的时序与缓存同步,最后点出地址对齐与掩码这两个高频翻车点。
先看一段 CPU 亲自搬数据的循环:从外设 FIFO 读一个字,存进内存,指针前移,循环往复。对几个字节的状态数据这没什么,但想象图像传感器每秒产出几十兆字节——CPU 的时间全花在"搬运工"角色上,真正的计算任务反而饿着。DMA(直接内存访问)的思路是给这块搬运工作配一个专职引擎:CPU 告诉 DMA 控制器"源、目的地、长度",然后去干别的;引擎搬完,用一个中断通知"货到了"。CPU 从搬运工变回调度员。
DMA 传输的完整时序
一次典型的"外设到内存"传输分五步,每步都有明确的主角:
1. 驱动准备缓冲区,把地址与长度写入 DMA 控制器寄存器 2. 驱动启动传输,CPU 立刻返回去干别的 3. DMA 引擎按协商好的总线事务逐块搬运,CPU 全程不参与 4. 搬运完成,DMA 控制器发出完成中断 5. 中断处理里驱动确认状态、交付数据、准备下一轮
配套的硬件细节是描述符:大多数 DMA 控制器不吃单条传输命令,而吃一张链表——每项描述符写着一小段传输的源、目的、长度与"下一项在哪"。驱动的工作就是填描述符、维护链表,引擎顺着链表自己往下走。这个结构在第 5 章网络驱动的收发环里会原样再现。
CPU 搬运与 DMA 搬运的对照
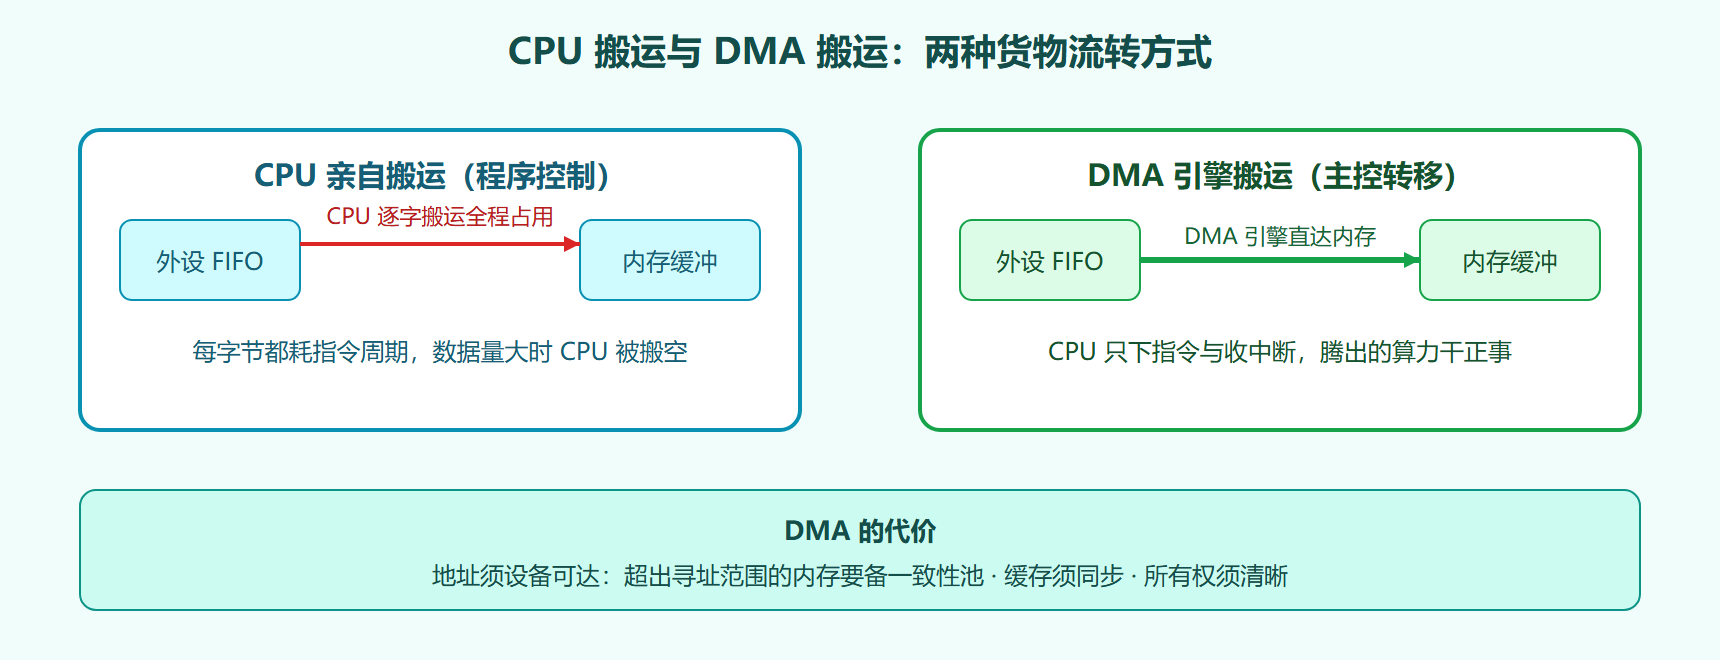
两类映射:一致性缓冲与流式映射
DMA 的麻烦不在搬运本身,而在内存系统的不一致。CPU 带缓存写数据,最新内容可能还在缓存里没落到内存;DMA 引擎直接访问内存,看到的却是旧数据。内核用两类映射解决这个问题,适用场景不同。
一致性映射:缓冲区分配时就带"CPU 与设备一致"属性——CPU 写完立即可见,设备写完 CPU 立即可读,不需要手工同步。代价是这类内存分配代价高、可能牺牲缓存性能,适合长期驻留的控制结构,比如 DMA 描述符链本身:
#include <linux/dma-mapping.h> struct dma_desc { /* 设备约定的描述符格式 */ u32 src_addr; u32 dst_addr; u32 length; u32 next; }; static struct dma_desc *desc_virt; /* CPU 侧虚拟地址 */ static dma_addr_t desc_dma; /* 设备侧 DMA 地址 */ desc_virt = dma_alloc_coherent(dev, sizeof(*desc_virt) * 32, &desc_dma, GFP_KERNEL); /* 两个地址指向同一块内存:CPU 用 desc_virt,写给设备的寄存器用 desc_dma */
注意一个内存、两个地址:CPU 拿虚拟地址访问,DMA 控制器拿总线地址访问,两者都由分配函数一并给出。把虚拟地址直接写进设备寄存器是新手大忌。
流式映射:对已经存在的缓冲区(比如网络包缓冲)做临时映射,映射期间所有权归设备,归还时做方向相关的缓存同步。适合大批量、一次性的数据传输:
dma_addr_t buf_dma; /* 发送方向:CPU 写完 → 映射 → 设备读 */ buf_dma = dma_map_single(dev, tx_buf, len, DMA_TO_DEVICE); if (dma_mapping_error(dev, buf_dma)) return -EIO; iowrite32(buf_dma, dma_base + REG_SRC); /* 告诉引擎源地址 */ iowrite32(len, dma_base + REG_LEN); /* 告诉引擎长度 */ iowrite32(1, dma_base + REG_START); /* 发车 */ /* 完成中断里:先撤销映射(内含缓存同步),CPU 再访问 */ dma_unmap_single(dev, buf_dma, len, DMA_TO_DEVICE);
方向参数不是摆设:DMA_TO_DEVICE 只刷出 CPU 缓存,DMA_FROM_DEVICE 只作废缓存让 CPU 重读。方向标错,轻则数据陈旧,重则破坏相邻内存。
三个高频翻车点
地址对齐与宽度。许多 DMA 控制器要求缓冲区地址与长度按特定宽度对齐(常见 4 或 8 字节起线)。分配时用带对齐参数的分配器,别赌运气。
掩码声明。设备能寻址的内存范围有限(32 位设备够不到 64 位地址的高区),驱动必须先声明能力:
ret = dma_set_mask_and_coherent(dev, DMA_BIT_MASK(32)); if (ret) return ret; /* 设备与平台协商失败,后续 DMA 不可用 */
不声明掩码,分配器可能给出设备根本访问不到的地址,传输悄无声息地失败——日志干净、数据全错,是 DMA 排错里最难缠的一类(第 7 章的排错实录有它的戏份)。
所有权纪律。缓冲区映射给设备期间,CPU 不得读写——两边同时写就是数据损坏竞态。纪律很简单:映射即移交,撤销即收回,中间绝不插手。
散列表与多段缓冲:真实设备的常态
单一连续缓冲只是教学形态,真实传输常常碎成多段:网络包的数据与头部分离存放、上层想"零拷贝"地直接把用户页交给设备。DMA 框架为此提供散列表映射——把一串分散的内存段一次性映射,产出设备可见的散列表结构:
#include <linux/scatterlist.h> struct scatterlist sg[2]; struct page *page1, *page2; /* 两段不连续的页 */ sg_init_table(sg, 2); sg_set_page(&sg[0], page1, PAGE_SIZE, 0); /* 第一段:整页 */ sg_set_page(&sg[1], page2, 512, 0); /* 第二段:半页 */ ret = dma_map_sg(dev, sg, 2, DMA_TO_DEVICE); if (ret != 2) /* 返回映射后的段数 */ return -EIO; /* 遍历映射结果写入描述符链:引擎按段逐块搬运 */ for_each_sg(sg, sg_iter, ret, i) { desc->addr = sg_dma_address(sg_iter); /* 设备侧地址 */ desc->len = sg_dma_len(sg_iter); desc = desc->next; } dma_unmap_sg(dev, sg, 2, DMA_TO_DEVICE);
注意映射后取地址与长度要用专门的取值宏——映射过程中框架可能做了合并或重排,原始散列表内容不能直接用。支持散列聚合的设备(一次描述符吃多段)与不支持的设备(一段一描述符)在这里分野,驱动的描述符管理代码按设备能力写,映射接口是统一的。
本节要点回顾
- DMA 把 CPU 从搬运中解放:下指令、收中断,其余交给引擎。
- 一个内存两个地址:CPU 用虚拟地址、设备用总线地址,勿混用。
- 一致性映射管控制结构,流式映射管批量数据:按生命周期选型。
- 方向、对齐、掩码是三大事故源,每个都有明确的检查手段。
寄存器与内存的通道都通了。最后一站补上"通道的规矩"——总线协议:同样的寄存器操作,挂在 I2C、SPI 还是 PCIe 上,玩法完全不同。