1.3 从平面到立体:一场被迫的范式转移
1.3 从平面到立体:一场被迫的范式转移
范式转移(paradigm shift)在这里指:解决短沟道效应的出路不再是"把平面器件做得更精",而是改变"沟道躺平、栅极从上压"这个延续五十年的几何前提。 本节讲清三件事:胡正明团队 1999 年论文给出了怎样的数学论证;把沟道立起来在工艺语言里意味着什么;为什么最终量产的是三栅 FinFET 而不是教科书里更理想的双栅。
一篇论文如何改写器件设计语言
1999 年到 2000 年间,加州大学伯克利分校胡正明(Chenming Hu)团队连续发表关于 FinFET 的论文,其中《FinFET—A Self-Aligned Double-Gate MOSFET Scalable to 20 nm》成为被引用最多的那一篇。论文里没有惊艳的实验数据,核心是数值求解三维泊松方程后得到的一组结论:把沟道做成垂直于衬底的薄硅鳍、让栅极从两侧(或三侧)包裹,短沟道效应的抑制能力随鳍宽的缩小指数增强。
论证的骨架可以拆成三步。第一步,把短沟道效应的严重程度与"栅极对沟道中心电势的控制比例"挂钩,定义栅控因子——沟道中心电势随栅压的变化率。平面器件因为源漏电场穿透,这个因子大约 0.6 到 0.7;栅极漏一成控制力,漏极就多拿一成话语权。第二步,对薄鳍结构求解泊松方程,得到栅控因子随鳍宽指数逼近 1 的解析趋势:鳍宽 10 纳米时已超过 0.9。第三步,也是最关键的一步,指出源漏耗尽区在沟道里的交叠长度随鳍宽指数衰减——鳍宽从 20 纳米缩到 8 纳米,交叠长度下降两个数量级。
这三步合起来释放了一个颠覆性的信号:鳍宽取代栅长,成为抑制短沟道效应的主控变量。 此前五十年的器件微缩都围绕"怎么把栅长做短"组织工艺;这篇论文之后,先进工艺研发的中心问题变成"怎么把又高又窄的鳍做出来"。
值得停下来想一层:论文用的工具并不新——泊松方程、有限差分、MATLAB。新的是提问方式。同时代大量研究在"更薄的栅介质、更陡的掺杂分布"里寻找平面结构的出路,相当于在旧范式里做优化;胡正明团队问的是"什么几何形状能让静电学公式本身变漂亮"。这种从"优化参数"到"更换变量"的跳跃,是范式转移的典型特征。
工艺语言的翻译:把"包裹"变成可制造的动作
理论上的"两侧夹住沟道",落到工艺上是一连串必须重新发明的动作。平面时代的全部工艺——光刻、刻蚀、薄膜、掺杂——都在为一个"俯视的二维图形"服务;鳍式结构要求工艺垂直方向也精确可控。这个翻译过程里最典型的例子是鳍的成型:193 纳米浸没式光刻的直接分辨极限在 40 纳米上下,而 22 纳米节点要求的鳍宽只有 6 到 8 纳米,差着五倍。
解法是把"直接刻出细线"改写成"用侧墙定义细线",也就是自对准多重图形技术。它的思路很像用模具的边沿画线:先刻出一排较宽的牺牲线条,在其侧壁保形沉积一层薄膜,再把牺牲层去掉,剩下的侧墙薄膜就是窄线条,宽度由沉积厚度决定——厚度控制比光刻分辨率容易一个数量级。下面用 mermaid 复现这条流程链(工艺细节在第 3 章展开):
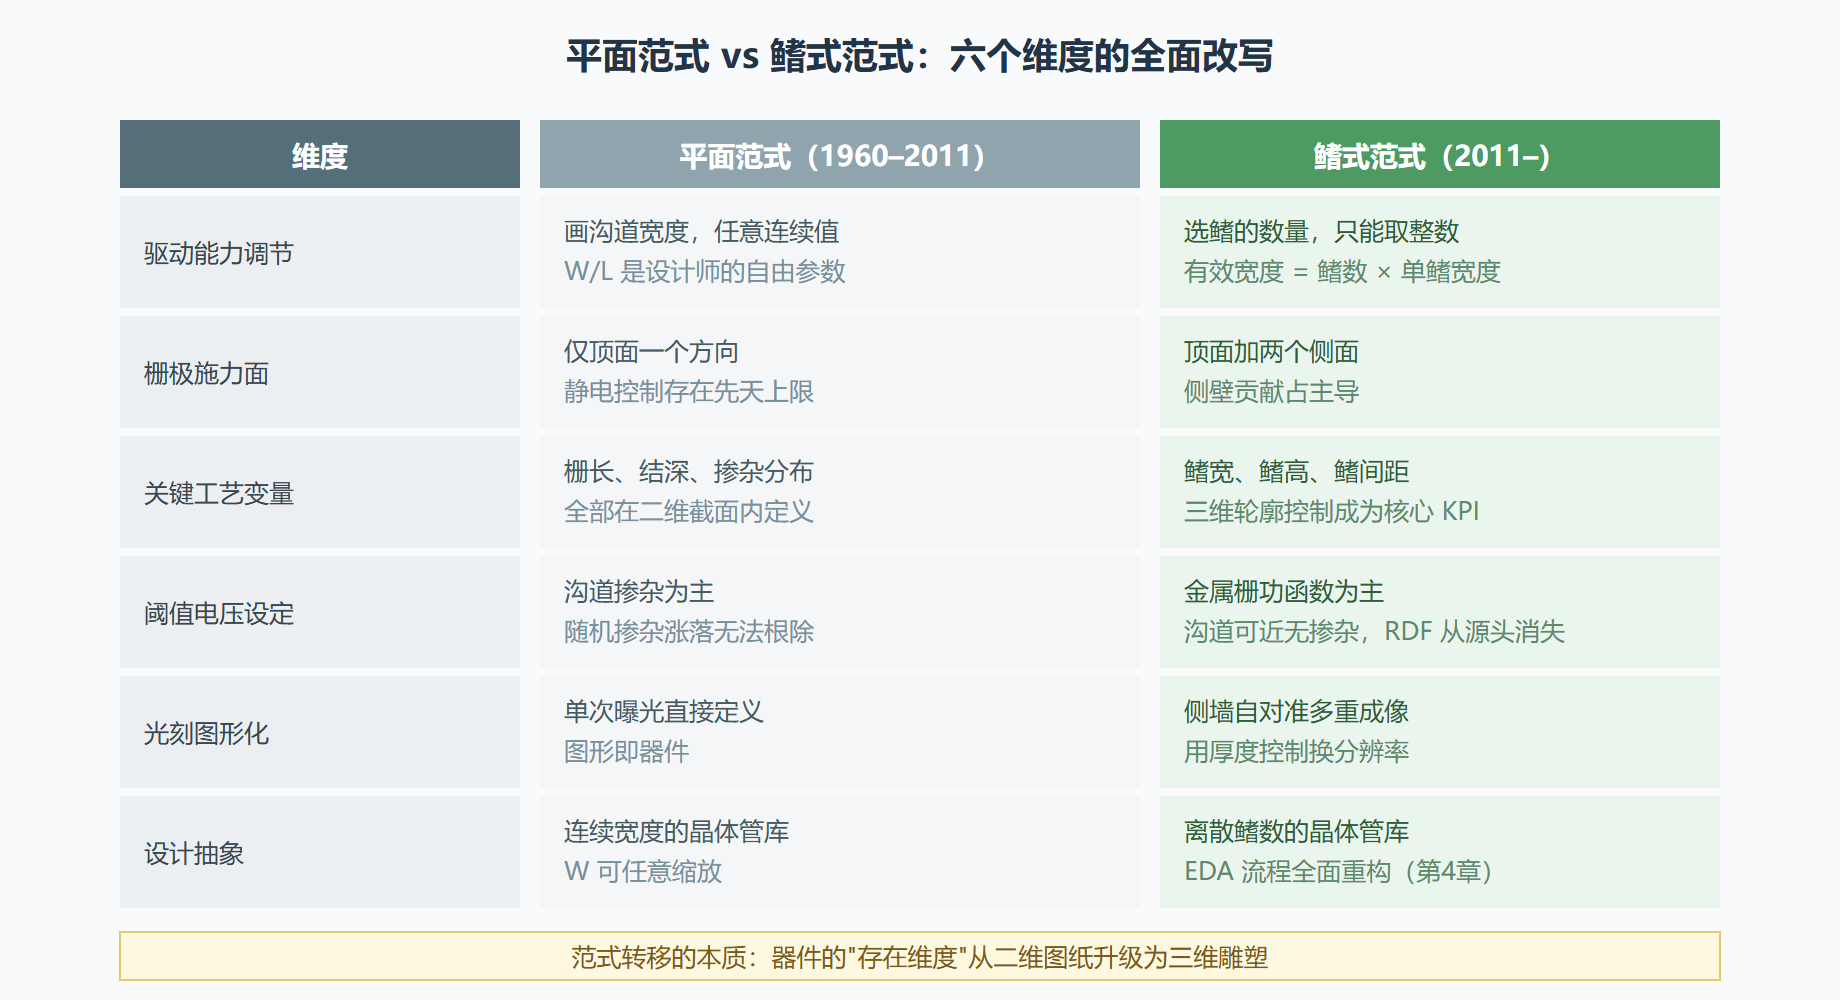
注意最后一步的产物:一排间距一致、宽 6 到 8 纳米、高 30 到 40 纳米的硅鳍阵列,之后的栅极工艺横着"跨"过这些鳍,自然形成三面包裹。鳍式结构不是给平面工艺加一道工序,而是把整套工艺的坐标系从 XY 平面扩展到了 XYZ 空间——光刻要管俯视图形,刻蚀要管侧壁角度,薄膜要管台阶覆盖,计量要管三维轮廓。范式转移的成本,大头就花在这套工艺语言的全面重写上。
图 1-3 两种范式的对照表
为什么量产的是三栅,而不是更理想的双栅
胡正明原始论文论证的结构是双栅:栅极只覆盖鳍的两个侧面。静电学上双栅更"纯"——鳍顶不参与导电,没有顶部拐角的电场集中问题。但量产落地时,业界清一色选择了三栅(tri-gate):栅介质连同金属栅把鳍顶也包进来。
原因出在工艺的可制造性上。自对准工艺造出来的鳍,顶部必然有一个有一定宽度、形状受刻蚀影响的顶面。若要把顶面"绝缘掉",需要额外一道选择性的顶部掩蔽工艺——在只有几纳米宽的鳍顶上做选择性沉积或刻蚀,良率风险极高。更务实的做法是承认顶面的存在,让它参与栅控:拐角的电场集中用鳍顶圆化(把尖角磨圆)缓解,顶面贡献的额外电容换来更强的整体控制。这是整个 FinFET 历史里反复出现的模式:不是选择物理上最优雅的结构,而是选择"现有设备精度下良率最高"的结构。
同样的逻辑也解释了另一个常被问到的问题:为什么不用一步到位的环绕栅(GAA)?2002 年前后学界已经在 IEDM 上展示过环绕栅器件,静电控制比 FinFET 更好。但环绕栅要求把沟道完全悬空或做成水平堆叠的纳米片,工艺跨度太大。FinFET 的聪明之处在于它是"保守的三维化":仍然使用体硅衬底、仍然沿用平面时代的大部分单元工艺,只是把沟道立起来——产业可以在不推翻既有设备投资的前提下吃到三维结构的静电红利。等到工艺能力再上一个台阶,GAA 才在 2022 年前后逐步接棒(详见第 7 章)。
落地时刻:2011 年的 22 纳米与产业跟进
2011 年 5 月,英特尔宣布 22 纳米三栅工艺量产,首批产品是 Ivy Bridge 处理器,单颗芯片集成约 14 亿个 FinFET。官方给出的对比数据是:与 32 纳米平面工艺相比,同性能下功耗降低约 50%,同功耗下性能提升约 37%。对 1.2 节那笔芯片级算术有所了解的读者会明白,这组数字的主要来源正是静态漏电的坍缩式下降。
此后三年,全行业完成转向:台积电 16 纳米(2015 年量产)、三星 14 纳米(2015 年初)、格罗方德与中芯国际随后跟进。值得注意的细节是各家命名——16、14、22 纳米,这些"节点数字"与栅长的物理对应关系从 FinFET 时代起就名存实亡(22 纳米工艺的实际栅长在 26 到 30 纳米附近),数字更多是营销代际标识。这背后有一整套产业话术的演变,第 5 章第 3 节专门拆解。
本节要点回顾
- 范式转移的实质是换变量:胡正明团队把短沟道效应的主控变量从"栅长"换成"鳍宽",交叠长度随鳍宽指数衰减,静电控制的解空间被彻底打开。
- 工艺语言全面重写:光刻从"直接刻细线"变成"侧墙定义细线",薄膜从平面沉积变成台阶保形覆盖,计量从线宽测量变成三维轮廓表征——范式转移的成本在工具链,不在原理。
- 三栅是良率妥协的产物:理想双栅需要难以良率化的顶部掩蔽工艺;三栅承认鳍顶参与栅控,用圆化处理拐角,换来可制造性。
- FinFET 是保守的三维化:沿用体硅衬底与既有工艺栈,让产业在不推翻设备投资的前提下吃到静电红利;更激进的 GAA 留给了下一个十年。
- 2011 年之后节点数字失去物理含义:22 纳米工艺的真实栅长接近 30 纳米,"节点"退化为代际营销符号。
第 1 章到此收束:平面结构的死因(1.1)、死亡证明(1.2)、以及解法的诞生(1.3)都已交代。第 2 章进入 FinFET 的物理内核——三面包裹的静电学到底怎么运作。