1.2 漏电功耗墙与变异:平面器件的三重绝症
1.2 漏电、功耗墙与变异:平面器件的三重绝症
亚阈值漏电(SS 劣化)、漏致势垒降低(DIBL)与工艺变异(RDF/LER)是平面器件在 22 纳米门口的三重绝症:前两者让关态电流指数级上涨、静态功耗吞掉功率预算,后者让阈值电压散布宽到电路无法收敛。 本节把 1.1 节的单器件物理放大到芯片与产线尺度,用数字说清每一堵墙的高度。
学习目标
阅读完本节,你应当能够:
- 写出亚阈值电流的指数表达式,解释 60 mV/dec 热力学极限的来历;
- 说明 SS 劣化与 DIBL 分别沿哪条路径抬高关态电流,并估算十亿晶体管芯片的静态功耗量级;
- 用 Pelgrom 图的思路解释随机掺杂涨落(RDF)与线边缘粗糙度(LER)如何决定阈值散布;
- 说出三堵墙相互咬合的关系:变异抬高漏电、漏电放大功耗、功耗反过来限制设计空间。
一、60 mV/dec:写在物理定律里的红线
先看亚阈值区的电流表达式。栅压低于阈值时,沟道并未完全关断,电流由源端势垒上的热发射载流子决定:
栅压每退一格,电流按指数衰减。衡量衰减快慢的指标是亚阈值摆幅 SS:电流下降一个数量级需要的栅压变化量。室温下 n=1(栅极对沟道电势拥有完全控制权)时:
这就是著名的 60 毫伏红线——任何靠热发射输运的场效应晶体管,室温下都不可能比它更陡。它对数字设计的含义很直接:阈值电压不能无限调低。要保证关态电流达标,Vth 与 0 之间必须留出足够的"指数距离"。举例来说,SS=90 mV/dec 的器件,Vth 每降 90 毫伏,关态电流就涨十倍。
平面器件的麻烦在于 n 回不到 1。n 的物理来源是栅极电容与沟道耗尽层电容的分压:耗尽层电容越大,栅压对沟道电势的实际控制比例越低。短沟道器件里耗尽区电荷分享(1.1 节)进一步恶化这个分压比,32/28 纳米平面工艺的 SS 普遍落在 90 到 110 mV/dec。把它代进功率预算里看后果:假设十亿颗晶体管、目标关态电流每颗 1 纳安,SS 从 75 恶化到 95 mV/dec,相当于阈值下限被迫抬高约 260 毫伏——要么牺牲速度(高 Vth 意味着低驱动),要么牺牲漏电,没有第三条路。
图 1-2 平面与鳍式器件的亚阈值转移特性对比
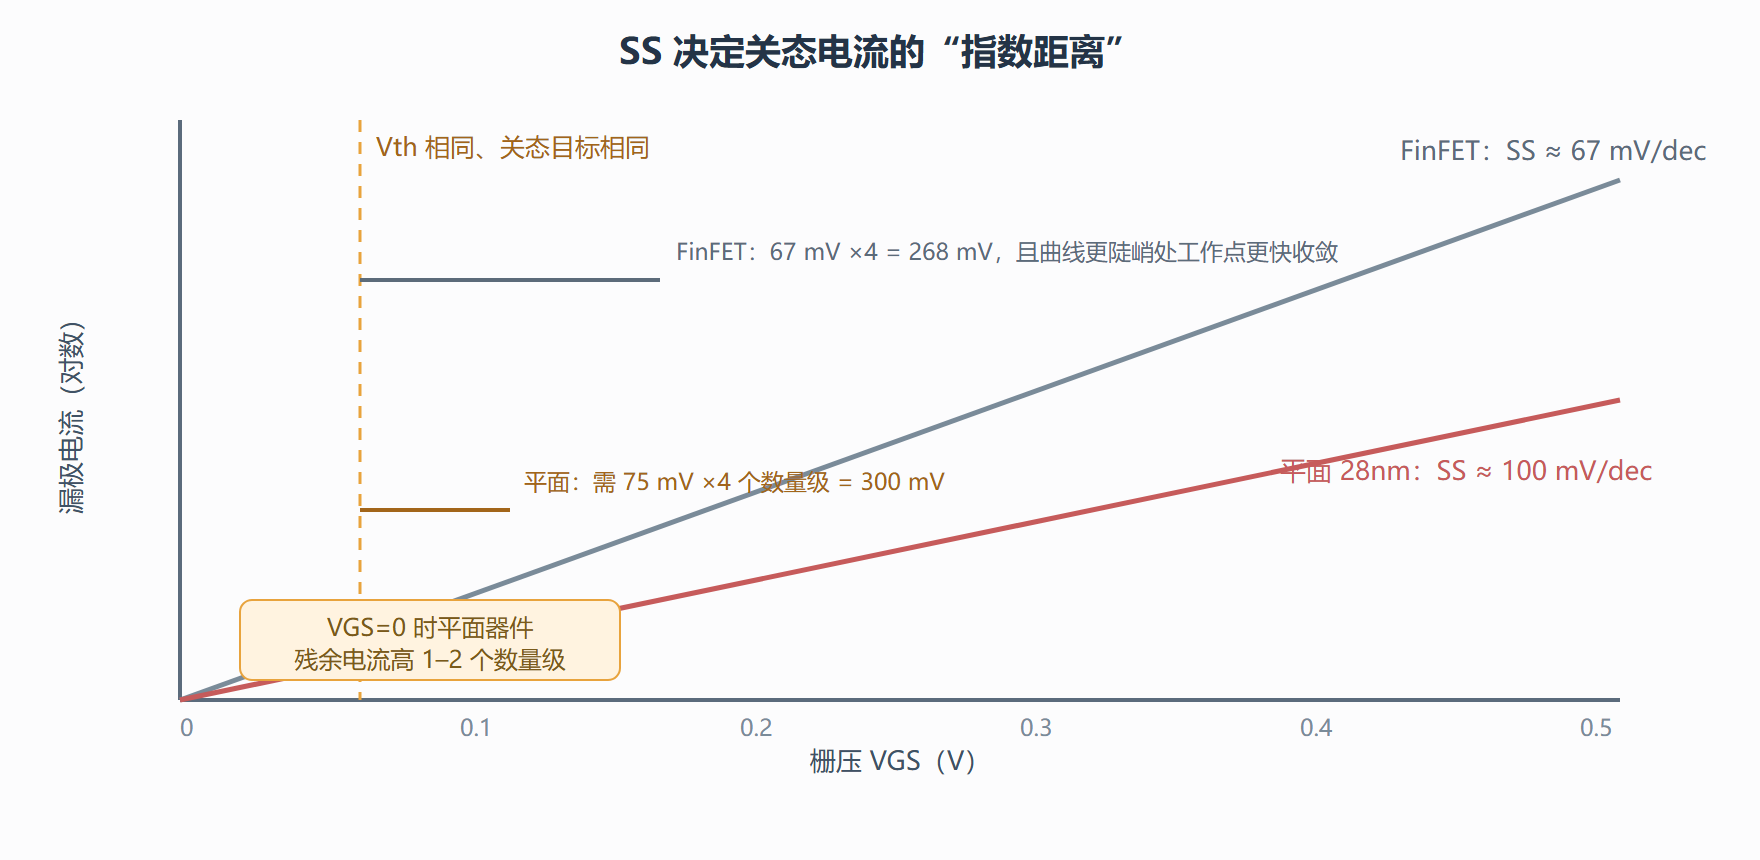
图 1-2 用对数坐标画出两类器件的转移曲线:同样的阈值、同样的关态目标,SS 更平的平面器件必须把工作点往右推得更远,或者在关态容忍更多漏电。SS 不是"曲线好看与否"的指标,而是把阈值电压、驱动电流、关态漏电三者捆在一起的耦合常数。
二、DIBL:让"关态"名存实亡
第二堵墙是漏致势垒降低。1.1 节已经给出物理图像:漏极电场穿透沟道、拉低源端势垒。它对漏电的杀伤力在于方向——DIBL 直接作用于指数的指数:势垒每降低几十毫伏,通过源端势垒的热发射电流就按 exp(qΔφ/kT) 放大约一个数量级每 60 毫伏。
工程上 DIBL 定义为阈值电压对漏压的敏感度:
28 纳米平面工艺的典型值在 100 到 130 mV/V,22 纳米 FinFET 能压到 30 到 40 mV/V。差别的产业后果可以用一个具体场景掂量:手机 SoC 的漏电预算通常按"高温、高漏压"最坏角签核。DIBL=120 mV/V 的器件在 1.0 伏漏压下阈值被拉低约 110 毫伏,折算成亚阈值电流的放大倍数是 10 的 110/SS 次方——SS=100 时约为 12 倍。也就是说,**桌面场景测得好好的芯片,装进手机跑满载,待机电流可能翻一个数量级**,这正是 2000 年代中期多家厂商在高端移动芯片上真实踩过的坑。
DIBL 还有一个隐蔽的帮凶效应:它与自热耦合。漏电抬高温度,载流子热发射率随温度指数上升,漏电进一步增加——正反馈回路一旦启动,芯片就在热逃逸边缘徘徊。平面时代工程师的应对是给漏电预算留两倍余量、把高漏电单元尽量分散布局,都是治标;根子上的解法还是把漏极电场的渗透路径掐断,这又要回到第 2 章的三面栅控。
三、芯片尺度的算术:三堵墙怎么互相咬合
单器件物理放大到芯片规模,最能说明问题的工具是一段十行的功率算术。下例模拟一颗 32 纳米平面工艺的四核 SoC,参数取公开文献的典型量级:
import numpy as np n_dev = 1.0e9 # 晶体管数 vdd = 0.9 # V ss_planar, ss_fin = 100.0, 70.0 # mV/dec vth_nom = 0.28 # V sigma_vth_planar, sigma_vth_fin = 0.030, 0.022 # 阈值散布,V def leak_power(vth, ss, sigma, T=330): # 高斯阈值散布下取 2σ 高漏角 + 热激活因子 vth_worst = vth - 2*sigma - 0.06*(T-300)/30 decades_off = max(0.0, vth_worst) / (ss/1000.0) i_off_dev = 1e-10 * 10**(-decades_off) # A,基准 0.1nA @Vth=0 return vdd * n_dev * i_off_dev print(f"平面 32nm 静态漏电 ≈ {leak_power(vth_nom, ss_planar, sigma_vth_planar):.1f} W") print(f"鳍式 22nm 静态漏电 ≈ {leak_power(vth_nom, ss_fin, sigma_vth_fin):.1f} W")
跑出来大致是:平面结构在高温角、2σ 阈值漂移下,静态漏电约 15 到 20 瓦——而这类 SoC 的总功率预算通常只有 35 瓦上下,静态部分吃掉一半,留给动态计算的空间所剩无几。换用 SS=70、散布更小的参数,静态漏电掉到 1 瓦量级。这个量级对比就是 2011 年前后全行业押注 FinFET 最直接的经济理由。
三堵墙的咬合关系在代码里已经体现:变异墙(σVth)通过 2σ 高漏角直接抬高漏电墙,漏电墙叠加 DIBL 构成功耗墙,功耗墙反过来逼迫设计师降频降压,性能诉求落空。 三者不是并列的三件事,而是同一条因果链上的三个环节。
四、变异墙:Pelgrom 图里的良率账
第三堵墙的两位主角——随机掺杂涨落(RDF)与线边缘粗糙度(LER)——都服从 Pelgrom 定律:器件面积开根号越大,参数散布越小:
平面器件里 RDF 长期是第一位贡献者:沟道里起关键控制作用的掺杂原子只有几十到几百颗,多几颗少几颗,阈值电压就以几十毫伏的量级随机游走。更棘手的是它是"原子计数"问题,改进光刻、修退火都无济于事。LER 则是光刻与刻蚀留下的边缘锯齿,栅长 30 纳米时 2 纳米的边缘波动就是 7% 的长度误差。
变异墙伤得最重的是 SRAM。6T 存储单元为了密度用最小尺寸器件,阈值散布最大;而单元的读稳定性与写容限对两侧晶体管的匹配极其敏感。平面 32 纳米时代,SRAM 良率损失中相当比例可归因于 Vt 失配,业界被迫加大单元面积或提高工作电压,密度与功耗双双受损。
⚠️ 常见坑:把变异问题当"统计尾巴"处理。实际签核中,2σ 角与 3σ 角的漏电差异可达数倍,移动芯片按典型角优化、按最坏角出货,是良率事故的高发区。
💡 关键直觉:FinFET 对变异墙的缓解是"结构性无掺杂"——沟道可以做到近乎不掺杂(依赖功函数调阈值),RDF 这一项从源头消失;代价是宽度量化把设计自由度变离散,详见第 4 章。
本节要点回顾
- 60 mV/dec 是热发射器件的热力学红线:n 由栅控电容与耗尽层电容的分压决定,平面短沟道器件 SS 普遍 90–110,逼迫设计在速度与漏电之间二选一。
- DIBL 以势垒为杠杆:漏压每拉低源端势垒 60 毫伏,关态电流放大约十倍;平面工艺 100+ mV/V 的 DIBL 让"高温高压角"成为移动芯片的漏电噩梦。
- 三堵墙是一条因果链:变异抬高漏电,漏电叠加 DIBL 构成功耗墙,功耗墙压缩性能空间;芯片级算术显示平面 32nm 的静态漏电可吃掉近半功率预算。
- Pelgrom 定律给出变异的面积标度:RDF 是原子计数问题,工艺改良无效;SRAM 因最小尺寸器件与匹配敏感成为最大受害者。
- FinFET 的应对是结构性的:三面栅控压 SS 与 DIBL,近无掺杂沟道消除 RDF——每一堵墙都有对应的几何解,这是 1.3 节范式转移的底牌。
下一节回到历史现场:从应变硅、高K金属栅这些续命补丁,到胡正明团队的 FinFET 论文,看这场被迫的三维化革命如何在理论与工艺的双重推动下落地。