4.1 宽度量化:设计者失去的连续旋钮
4.1 宽度量化:设计者失去的连续旋钮
平面时代的设计师像在砌一堵可以任意切割的墙:想多宽,就把砖切开半块补上;FinFET 时代砖不能切了,门宽只能按整砖数跳变。 宽度量化不是误差、不是工艺妥协,而是一条物理定义:有效沟道宽度等于整数根鳍的并联,没有中间值。本节看这个整数如何重构驱动强度、单元高度、版图行结构,以及综合器与单元库如何被迫学会"数鳍"。
宽度变成整数:不是误差,是定义
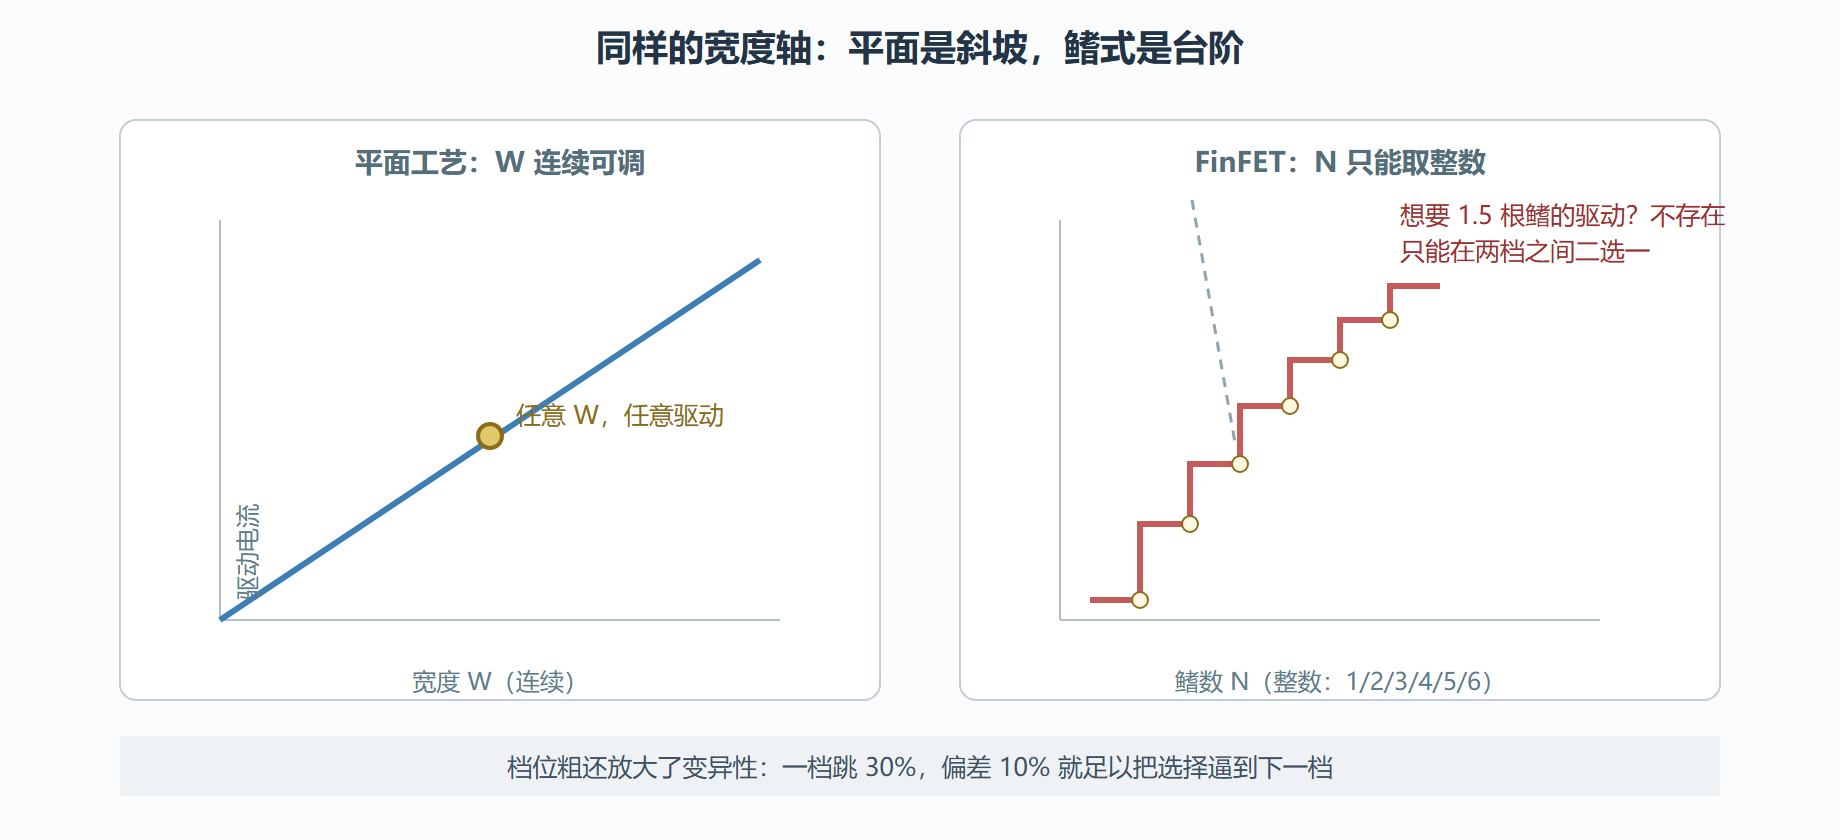
平面工艺里,沟道宽度 W 是连续变量。版图上拖出 42.37 微米,工具照单全收;器件模型在任意 W 上平滑插值,驱动电流随 W 线性缩放。设计者手里因此握着一个连续旋钮:差一点驱动,就把 W 加宽一点,时序刚好收敛。
鳍式结构把这只旋钮掰成了档位。第 2 章给过公式:单根鳍的有效宽度是 2Hfin+Wfin,一个器件的宽度是 N 根鳍的整数倍——N 只能取正整数。想加大 15% 的驱动?没有"1.15 根鳍"这种东西,只能在 3 根和 4 根之间二选一,档位差接近三成。
档位有多粗,看一组 22 纳米级 PDK 的典型数据(归一化驱动电流):
| 鳍数 N | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 归一化驱动 | 0.41 | 0.83 | 1.22 | 1.64 | 2.01 | 2.43 |
| 相邻档位增幅 | — | +102% | +47% | +34% | +23% | +21% |
低鳍数区间档位极粗:从 1 根加到 2 根,驱动翻倍;2 根到 3 根也有近五成的跳变。标准单元库的驱动强度序列因此被迫稀疏——X1.4、X1.7 这类中间档位造不出来,只能靠两个单元并联凑,面积与功耗双双吃亏。
更麻烦的是档位并不严格线性。上表是理想模型;真实硅片上,鳍底应力梯度与界面态随鳍数非单调变化,3 根鳍的实际驱动可能只有 2 根的 1.32 倍而非理想的 1.5 倍。这种"量化引入的非线性偏差"深植于三维静电结构,传统模型参数校不平。后果在签核阶段才爆发:某 SoC 项目里,综合器按标称库选了 3 鳍的反相器,静态时序分析全绿,后仿真却显示输出边沿拖沓到 138 皮秒——比目标值劣化近四成。标称库里没建模的非线性,静态时序分析天生看不见。
图 4-1 连续旋钮变档位:平面与鳍式的驱动强度景观
鳍对齐:单元高度与版图行结构的重构
宽度量化的冲击穿透到物理设计的地基——标准单元的高度。平面工艺的单元高度是全局常量,由电源轨宽度与间距决定;鳍式单元的高度必须容纳整数根鳍的排列,高度本身成了鳍数的函数。不同鳍数的单元高度不同,而同一版图行(row)内的单元必须共享电源轨——把 4 鳍单元和 2 鳍单元塞进同一行,要么电源轨断裂,要么插入填充结构补齐。
于是版图规则里多了一条"鳍对齐约束":同一行内所有单元的鳍配置必须兼容,布局工具在行间隙里自动插入不参与逻辑的虚设鳍(dummy fin)来补齐。虚设鳍不导电,却占金属层空间、贡献寄生电容——某 AI 加速器项目里,虚设填充密集区的电源网格被挤弱,局部电压降超标,芯片启动失败。对策是把高驱动单元与存储位单元按行分组物理隔离:宏单元 6 鳍一行、位单元 2 鳍一行,各自成行后,面积省下一成多,关键路径的负时序裕量也改善了两百皮秒级。
注意这条约束如何一路反弹到逻辑综合层:综合器选单元时如果只看时序功耗、不管行兼容性,布局阶段就要用面积和电压降来还债。所以现代综合流程里,"这一族单元允许进哪一行"的提示要在综合阶段就注入,让逻辑优化与物理规划共享同一份整数约束。
综合器学会数鳍:从连续优化到整数规划
旧流程对付量化的土办法是"连续求解,结果四舍五入"。这条路在签核阶段系统性翻车,原因前面说过:四舍五入抹掉的非线性,正是硅片行为的真实组成部分。
现代综合器把整数性编译进了求解器内核,典型流程分两阶段。第一阶段是预枚举与剪枝:读入库时识别每个单元的鳍数属性,对每条候选路径先做一次快速可行性判断——用该鳍数下的驱动电流估算输出边沿,不满足目标就当场剪掉,不进昂贵的精确评估。第二阶段是整数规划主求解:每个逻辑门必须从合法鳍数的单元集合里恰好选一个(0-1 变量),时序与负载约束线性化后联立,目标函数是面积与时序的加权和。关键在于系数显式编码了"3 鳍比线性外推弱 15%"这类实测非线性——求解器不是在理想台阶上选档,而是在真实台阶上选档。
# 驱动强度选档:量化台阶上的最近档搜索(综合器剪枝逻辑的缩影) drive_table = {1: 0.41, 2: 0.83, 3: 1.22, 4: 1.64, 5: 2.01, 6: 2.43} # 实测非线性修正:3 鳍比线性外推弱约 12%(示意) penalty = {3: 0.88} def pick_fins(target_drive): best, gap = None, None for n, d in drive_table.items(): d_eff = d * penalty.get(n, 1.0) # 用实测档位而非理想档位 if d_eff >= target_drive: # 驱动必须覆盖目标 g = d_eff - target_drive # 再取最小过驱动,省面积 if gap is None or g < gap: best, gap = n, g return best for t in (1.0, 1.2, 1.35): n = pick_fins(t) print(f"目标驱动 {t:.2f} → 选 {n} 鳍(有效驱动 {drive_table[n]*penalty.get(n,1.0):.2f})") # 目标 1.35 会跳过 3 鳍直接选 4 鳍——这就是档位粗的本质
这套机制的收益有实测背书:某 22 纳米项目把"静态时序通过而后仿真失败"的路径占比从 18.7% 压到 2.3%,代价是综合运行时间增加约三成——换来的是签核收敛轮次减少两轮,百万门级设计每轮一天多,总账划算。另有两个高频陷阱值得记录:其一,某单元在库里标着 3 鳍,版图生成脚本坐标四舍五入后实际画出 2 鳍——差整整一根鳍,静态时序全过、硅片全挂;防御办法是例化后立即做鳍数校验,库声明与版图几何逐一比对。其二,不同工艺角下最优鳍数不同(快角 3 鳍够、慢角要 4 鳍),单角优化出的网表换个角就违例,必须多角联合求解,宁可多花一档面积换全角收敛。
单元库重构:让量化可见、可算、可签
所有上层变革的地基是一个正确建模量化的单元库。复用平面库、只改几个数值,是灾难的起点。合规的库至少多出四件事:
- 按鳍数拆分单元:一个反相器不再是黑箱,而是 N 个单鳍器件的显式并联——两根鳍里一根因缺陷阈值漂移 50 毫伏,整体驱动只降两成多而非失效,这种统计鲁棒性要在模型里可见;
- 全工作点仿真矩阵:鳍数 × 电压 × 温度 × 负载 × 输入边沿全组合,一百八十个点上少于一百二十个就会漏掉"3 鳍在高温高压下异常饱和"这类拐点;
- 量化敏感度标注:每条时序弧标出对鳍数变化的敏感等级,敏感弧优先保障;
- 虚设鳍建模:填充结构不参与逻辑,但它的电容必须进寄生提取——功能正确与物理真实,缺一不可。
本节要点回顾
- 宽度量化是定义不是误差:有效宽度等于整数根鳍的并联,驱动强度只能按档跳变,低鳍数区档差可达三成到一倍。
- 档位本身还带非线性:3 鳍相对 2 鳍的真实增益常低于线性外推,标称库不建模它,静态时序就看不见它——后仿真翻车的经典根源。
- 单元高度成了鳍数的函数:鳍对齐约束迫使同行单元鳍配置兼容,虚设鳍补行要付出面积、电容与电压降的代价,行分组要在综合阶段就规划。
- 综合器必须数着鳍做整数规划:预枚举剪枝加整数求解、系数带实测非线性、多角联合——这套组合拳把驱动失配率从近两成压到百分之二。
- 库是量化时代的地基:按鳍拆分、全矩阵表征、敏感度标注、虚设建模,四件事缺一件,上层流程都在沙地上盖楼。
宽度的档位刚数清楚,下一节处理第二张账单:栅从一面变三面之后,藏在版图褶皱里的寄生参数全面涨价。