3.2 MIP矩阵帧内预测
3.2 MIP矩阵帧内预测
本节摘要:MIP(Matrix-based Intra Prediction,基于矩阵的帧内预测)是VVC方法论上最值得咀嚼的新工具——它把帧内预测从"插值"改写成"一次矩阵乘法":参考像素下采样成向量,乘以离线训练好的小矩阵,直接产出预测块。解码端只需要乘加运算,没有网络、没有浮点、没有模型文件。本节拆解它的三步流程、三套矩阵的分组设计、与其他模式的关系,以及它为AI进入标准蹚出的路。
承接3.1:方向模式再密,本质上仍是"沿方向抄像素"的插值思维。MIP换了思路——预测器本身是个离线训练出来的模型。3.3节的跨分量预测则继续在本帧内找新的相关性维度。
动机:插值思维的盲区
方向插值隐含的假设是"当前块是参考边的延长线"。但有一大类内容不满足:规则的棋盘格纹理、周期花纹、人造图形。这类内容的局部统计特性是二阶的——像素间存在复杂的联合分布,单靠"抄一行"抓不住。
MIP的出发点:既然线性模型能抓住二阶统计(类似线性回归拟合),那就离线训练一组小矩阵,让"参考像素 → 预测块"的映射直接被矩阵参数吸收。训练在标准化阶段完成,矩阵烧进标准文本的表格里;解码器实现时就是查表加乘加,与实现一个DCT的复杂度同量级。
💡 划时代之处不在"用了AI"(它只是最简单的线性模型),而在"训练产物进入标准语法"这件事本身——它证明了"标准内小模型"这条路在工程与知识产权上都走得通。第10.4节的神经编码讨论会回到这个原点。
三步流程:下采样、矩阵乘、上采样
MIP的完整流程干净得可以画在一张餐巾纸上:
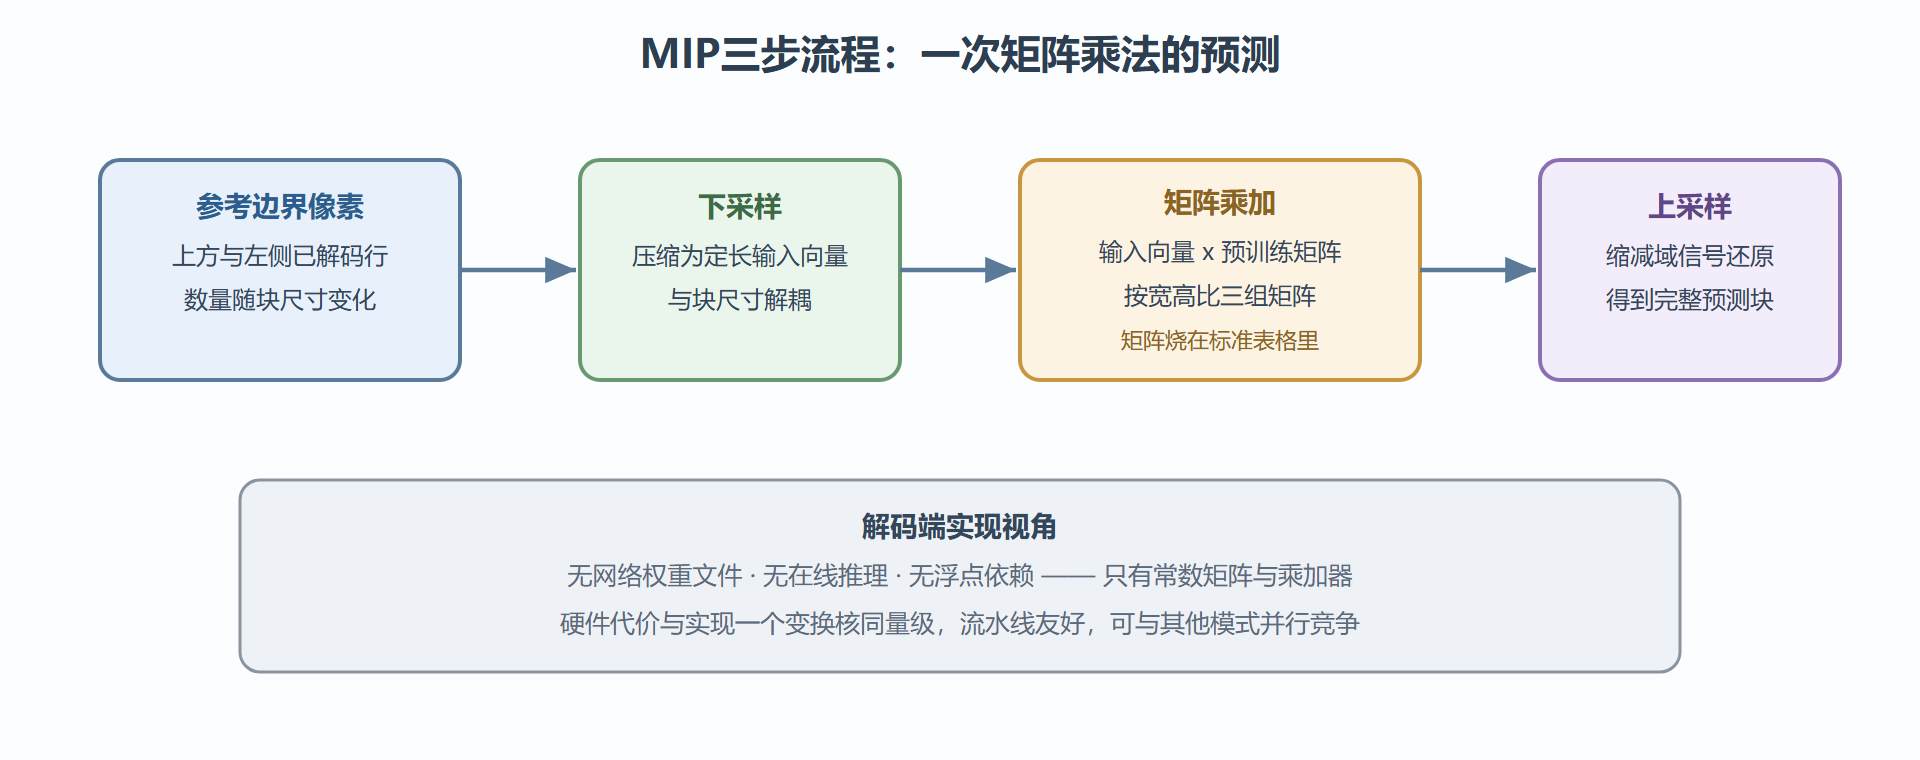
第一步,参考像素下采样。当前块上方与左侧的参考边界像素(数量随块尺寸增长)被下采样/重组为一个固定长度的输入向量。目的有两个:让矩阵尺寸与块解耦(不同大小的块共享矩阵);砍掉冗余信息,矩阵可以更小。
第二步,矩阵乘加。输入向量乘以预训练矩阵,加偏置,得到一个缩减域的预测信号。矩阵按块的宽高比分三组:
| 矩阵组 | 适用块 | 矩阵规模感受 | 设计意图 |
|---|---|---|---|
| 第一组 | 方形块 | 最小 | 方形块各向同性,模型最简 |
| 第二组 | 偏横/偏竖的矩形 | 中等 | 捕捉方向性统计差异 |
| 第三组 | 细长条块 | 稍大 | 长宽比极端,输入维度更大 |
第三步,上采样还原。缩减域信号经上采样插值展开为完整预测块。下采样-上采样的组合,等于给模型加了一个低通先验——这与"预测要平滑、残差管细节"的分工哲学一致(细节交给第5章的残差编码)。
流程图解
与传统模式的关系:竞争而非替代
MIP不是替代65方向模式的"新引擎",而是并列参赛的第67+号选手:编码器RD搜索在传统模式与MIP之间择优,码流里一个标志位声明用的是哪类。实测中的分工图景大致是:
- 自然图像大多数块:传统角度模式仍是主力(语法熟、实现快、多数场景够准);
- 规则纹理与人造图形:MIP命中率显著上升(棋盘格、织物、UI元素、部分屏幕内容);
- 极端尺寸块:MIP被限制在中等尺寸块使用(过大块的矩阵会膨胀,过小块统计不稳定),这又是一次工程折中。
一个常被引用的直觉:MIP在**内容有"可学习的结构"、但结构又不够强到值得用IBC或调色板(第7章SCC工具)**的中间地带最活跃。三个工具按"结构性"强弱各占一段光谱。
伪代码与复杂度账
MIP 解码端伪代码(示意): 输入:参考边界像素 ref[],块尺寸 w,h,矩阵组索引 g 1 v = downsample(ref) # 定长输入向量 2 M = MIP_MATRIX[g][aspect_bin] # 查标准表格取矩阵 3 y = M * v + bias # 一次乘加 4 pred = upsample(y, w, h) # 还原到块尺寸 返回 pred 复杂度感受: 乘加次数 ≈ 输入维度 x 缩减维度, 与同尺寸块的变换(第5章)同量级, 且矩阵为常数,可烧进ROM,无缓存压力。
⚠️ 工程提醒:软件实现里最容易被忽略的是下采样与上采样的插值细节——标准对边界参考像素的重组顺序、滤波位置有精确规定,实现偏差会造成编码端与解码端的预测不一致(漂移),码率统计上表现为"莫名其妙的画质劣化"。做解码器对齐测试时,MIP是高发错位点,值得单独准备测试向量(第10.1节解码工程会回到这个话题)。
MIP的深远意义
把MIP放进更大的时间线里看:H.264时代没人敢想象"训练出来的参数"写进标准;HEVC时代有探索但未进正文;VVC正式接纳了最朴素的形式(线性矩阵)。它验证了一条中间路线——AI不必以端到端网络的形式才能进标准,蒸馏成常数矩阵也能带来真金白银的码率收益。沿着这条路,环路滤波的神经增强(第6章ALF的后续研究)、帧间预测的模型化(第10.4节ECM/NNVC)都在推进。裁缝铺的说法:MIP是店里第一台电动缝纫机——它还是照着老工序走线,但动力已经是新的了。
MIP的边界与两问两答
诚实地划出MIP的能力边界,比吹它的 novelty 更有用。三个"不管用":强噪点内容(相关性被噪声淹没,矩阵学到的先验失效,退回DC反而稳);大面积强方向内容(角度模式一两比特就够,矩阵乘加反而贵);块尺寸超出MIP适用范围时标准直接禁用(过大过小都不伺候)。MIP是中距离武器——内容有点结构、又不够纯,正是3.3节末尾那条光谱的中间三档。
问:MIP的矩阵到底多小?
输入向量与缩减维度的乘积决定规模,典型在几十乘几十的量级——比一次同尺寸变换还小。标准按块分组给了矩阵集,全部烧进ROM是几KB到几十KB级——硬件视角"几乎免费",这是它被标准接纳的硬指标。
问:解码端要做矩阵乘,浮点怎么办?
标准定义的是整数运算流程(矩阵系数定点化、中间精度有规定),解码端全程整型乘加——"神经"在这里只剩形式,实体是一张整数表加乘法器。想看懂细节,标准文本的MIP章节配着本节流程图读即可对上号。
本节要点回顾
- MIP三步:参考像素下采样成定长向量、乘离线训练矩阵、上采样还原预测块;
- 三组矩阵按宽高比分:方形、偏矩形、细长条各一组,矩阵烧进标准表格;
- 竞争而非替代:与65方向模式并列参赛,规则纹理与人造图形是它的主场;
- 解码端零AI包袱:只有常数矩阵与乘加,与变换核同量级的硬件代价;
- 方法论意义大于单项收益:它为"训练产物进标准"蹚出了工程与知识产权双通道。