5.1 MTS与LFNST残差变换
5.1 MTS与LFNST残差变换
本节摘要:变换的任务是把残差能量集中到少数低频系数,好让量化一刀切掉大头。VVC在这步上做了两件事:MTS(多变换选择)在DCT-2、DCT-8、DST-7三核之间按内容择优;LFNST(低频不可分变换)对帧内残差的低频系数再做一次不可分的二次聚能。本节讲清"为什么要换核"与"为什么只变换低频",并还原本节吸收进来的原LFNST独立小节内容。
第5章开篇。预测(第3、4章)越准,残差越小越"碎"——碎残差的统计特性多变,单一DCT-2核不再处处最优,这就是变换环节升级的动机。
为什么单一核不够用
几十年来的默认选择是DCT-2(经典离散余弦变换):对"平滑渐变+少量边缘"的残差能量集中度极好。但VVC的残差来源变了——65方向预测、MIP、仿射补偿之后,剩下的残差呈现新的统计面貌:
- 帧内角度预测后的残差:沿预测方向被"拉直",垂直方向的残差能量分布陡峭,DST-7对这类陡峭分布的集中度优于DCT-2;
- 细长块残差(QTMT的产物):长条块两个维度的统计差异大,单一核"横竖同核"就不匹配;
- 强边缘残差:尖锐边界的频谱衰减慢,需要更贴合的基函数形状。
**MTS(Multiple Transform Selection)**的答案:给水平、垂直两个方向各自提供DCT-2、DCT-8、DST-7三种核,按块独立选择组合(编码器RD搜索决定,码流传索引)。它延续第2章以来的主线——自由度跟着内容走。
| 变换核 | 基函数形状直觉 | 擅长的残差类型 |
|---|---|---|
| DCT-2 | 经典余弦,两端缓 | 平滑渐变、一般纹理 |
| DCT-8 | 端点斜率更陡 | 边缘陡峭、方向性强 |
| DST-7 | 端点不为零的奇对称感 | 帧内角度预测后的陡峭残差 |
隐式MTS与显式MTS是两档用法:帧内残差在很多情况下由预测模式隐式决定变换核(模式即索引,省掉信令);需要精确控制时用显式MTS传一个索引。又是"能推导就不传"的信令哲学(呼应4.2节SMVD)。
LFNST:低频的第二次聚能
MTS是可分变换——水平一个核、垂直一个核,行列分开做,计算省、硬件熟。但帧内残差有个残留问题:主变换后低频区仍有残余相关(帧内预测的特性决定残差不是理想白噪声)。**LFNST(Low-Frequency Non-Separable Transform)**补这一刀:
只取低频角落。把主变换后左上角最多4×4或2×8/8×2的低频系数取出来,其余系数原样保留;
做一次不可分变换。"不可分"意味着不能拆成行列两次一维变换——它是一个真正的二维联合映射,用一个预训练矩阵(是的,MIP同款设计:离线训练、烧进标准表格)把16个低频系数整体旋转到新基下,进一步聚能;
系数数不增。变换后仍是同样个数(或截断为零)的系数,码流结构不变,只是能量更集中、高频更稀疏。
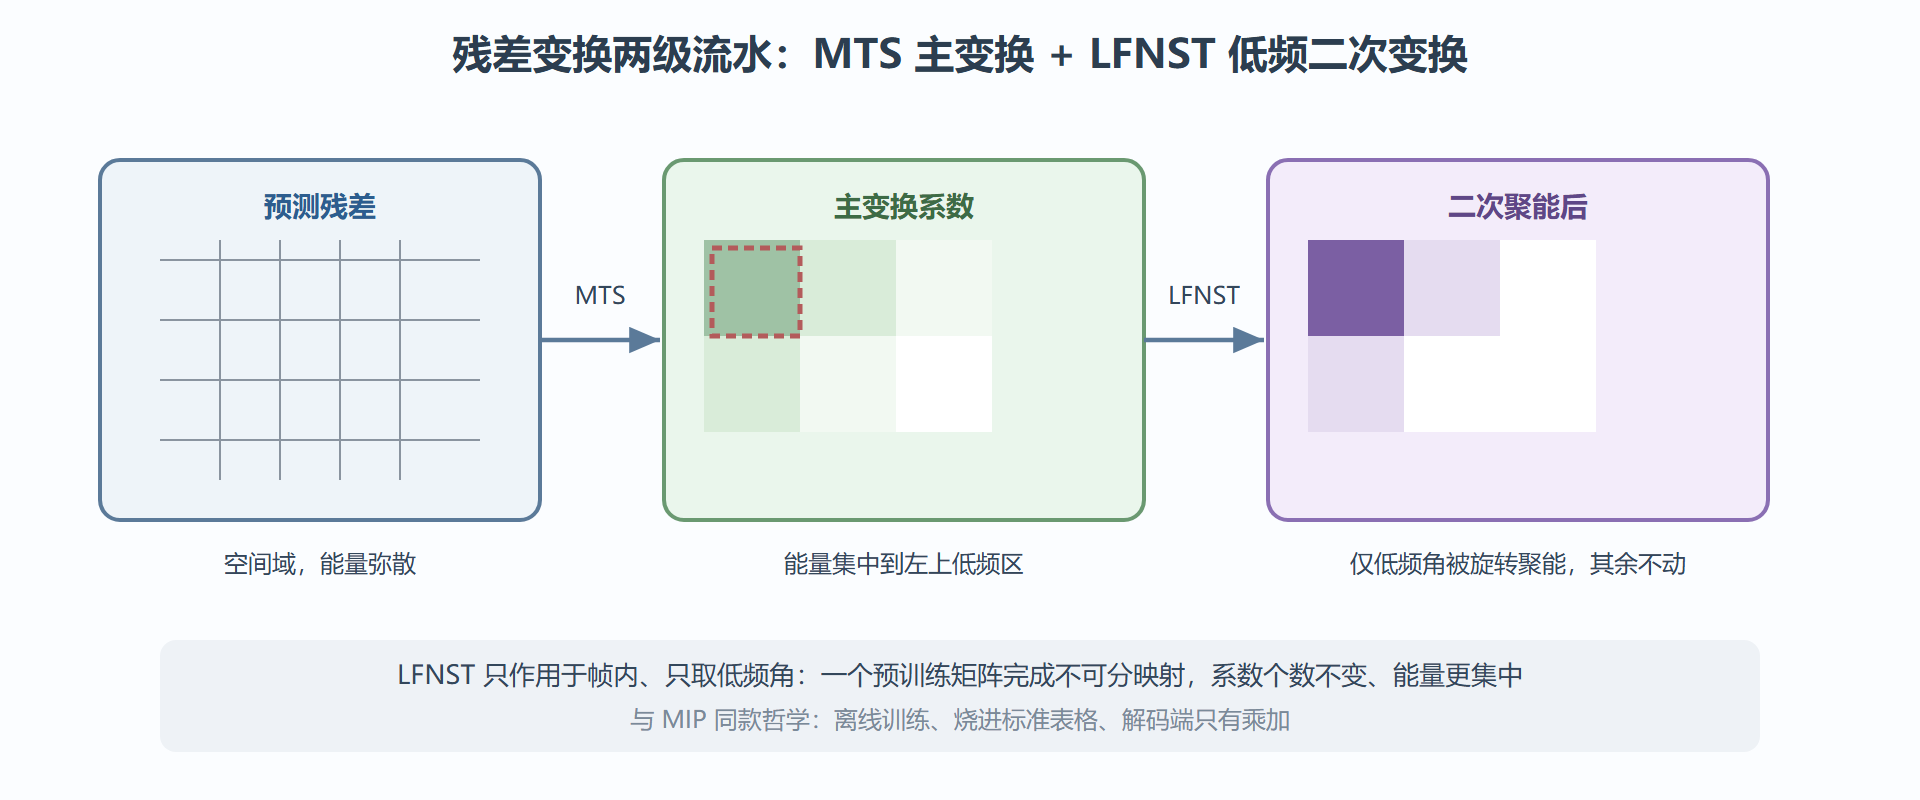
两级变换的联动与约束
LFNST不是想开就开,标准设了多重门(每一种都值得琢磨其工程动机):
- 只对帧内残差启用:帧内预测后的低频残余相关显著,帧间残差统计不同,收益不抵成本;
- 尺寸与模式门控:块的宽高、帧内模式类型决定能否启用、取多大的低频角;
- 与MTS的顺序锁定:先MTS后LFNST,且启用LFNST时对MTS的核选择有联动限制——两级变换的"组合爆炸"被标准按住了;
- 索引与矩阵集:LFNST传一个索引选择变换矩阵集(按块形状分组,同MIP的分组思路),矩阵规模小、ROM占用可控。
💡 为什么"不可分"这么晚才进标准:可分变换行列解耦,计算量随尺寸线性增长,硬件实现成熟;不可分变换是全系数联合映射,计算与访存都贵。LFNST的聪明在于只在4×4这么小的低频角上做不可分——把"贵"的算法锁在"小"的面积里,成本可控而收益兑现。这个"以小搏大"的定价思路在标准设计里屡试不爽。
伪代码与实现提醒
残差变换解码流程(帧内块示意): 1 res = 重建块 - 预测块 # 残差来自反量化后的系数(先看5.2) 2 coef = InvMTS(res, mts_index) # 行列可分反变换,核由索引或模式隐式定 3 if lfnst_idx != 0: 4 low = InvLFNST(coef 左上角, lfnst_idx) # 小矩阵乘加 5 coef 左上角 = low 6 残差重建完成 → 进入第6章环路滤波 实现提醒: - LFNST 矩阵是 16x16 级别的小矩阵,但取角位置随块形状变化, 索引边界错位是解码器对齐测试的高频错误点; - MTS 的隐式选择规则(由帧内模式推导)必须逐条对照标准实现, 猜错核会全块漂移,症状是特定模式下的周期性花屏。
两问两答与一个调参直觉
问:MTS的显式索引要付多少比特,何时隐式更划算?
显式索引走CABAC只需几比特,但乘以每帧数万块就不是小数——所以标准让帧内残差在多数情况下由模式隐式定核(角度模式与变换核的统计关联是训练出来的映射),显式索引留给"隐式映射失手"的少数块。信令哲学照旧:能推导的不传,推导错了才买单。
问:LFNST与MIP都是"训练矩阵进标准",训练目标一样吗?
不一样。MIP的矩阵学的是"参考像素到预测块"的映射(替预测器);LFNST的矩阵学的是"主变换后低频系数的再聚能基"(替变换基)。一个作用于预测域、一个作用于频域,但共享同一套工程范式:离线训练、小规模矩阵、烧进标准表格——这条范式正是第10.4节"标准内AI"路线的基石。
调参直觉:观察编码统计里"MTS显式启用率"与"LFNST命中率"两个指标——前者持续偏高说明隐式映射与你的内容不匹配(考虑档位调整),后者在屏幕内容桶里异常低属正常(屏幕内容残差稀疏,二次变换无用武之地)。把这两个指标纳入编码回归看板,是调优第5章工具的起点。
本节要点回顾
- MTS三核择优:DCT-2/DCT-8/DST-7按残差统计选,帧内大量场景由模式隐式定核、免信令;
- LFNST补低频:帧内残差主变换后仍有残余相关,小矩阵不可分变换二次聚能;
- 只在小面积做贵算法:低频角最多4×4,成本锁定、收益兑现;
- 两级变换联动受限:顺序锁定+组合约束,防组合爆炸;
- 训练矩阵进标准:与MIP同款哲学,是VVC方法论层面的一贯路线。