5.3 CABAC熵编码改进
5.3 CABAC熵编码改进
本节摘要:熵编码是压缩流水线的最后一道工序:把量化后的语法符号序列压成尽可能短的比特流。VVC沿用CABAC(上下文自适应二进制算术编码)框架,改进集中在三个方向:上下文数量与初始化的重新定价、解码吞吐的流水线化(上下文加载去瓶颈、旁路通道并行)、系数编码的新扫描组织。本节从CABAC的直觉讲到VVC的具体翻新。
第5章收官。变换聚能(5.1)、量化取舍(5.2)之后的幸存符号,在这里数成最后的比特。产品随后交给第8章组织成码流。
CABAC三分钟入门
CABAC = 上下文建模 + 二进制化 + 算术编码,三层各司其职:
二进制化:任何语法元素(MV差、系数值、模式索引)先拆成一串比特(二元符号),常用的拆法有截断莱斯码、一元码等——拆得好,常用符号的比特串就短。
上下文建模:每个二元符号不是独立编码的。CABAC为它挑一个"上下文"(概率模型),记录"这个位置的0/1出现概率各多少"。概率越偏(比如99%是0),编码越省。上下文的选择依据邻域信息(比如"左边块和上边块的系数是否非零"),这就是"自适应"与"上下文"的含义。
算术编码:按概率把整串符号算进一个越来越窄的区间,最后输出区间位置的二进制表示。理论上能逼近信源的熵——即数据压缩的物理极限。
💡 一句话直觉:CABAC像一位记账员,一边记账一边学规律——见得越多的模式,下次记得越短。
VVC翻了哪三处
框架不变,但VVC的语法元素清单大换血(QTMT划分、依赖量化状态、各种新工具的标志位),CABAC相应做了系统性翻新:
其一,上下文重新定价
HEVC的上下文数量众多,且每个都要逐块初始化、更新。VVC做了两件事:精简上下文总数(合并统计特性相近的模型,砍掉低收益的细分),并重设初始化——大部分上下文在条带级一次性初始化,且初始值按帧内/帧间等场景给出更准的先验。收益是双重的:省比特(模型更贴合真实统计)也省实现(状态表更小)。
其二,解码吞吐的流水线化
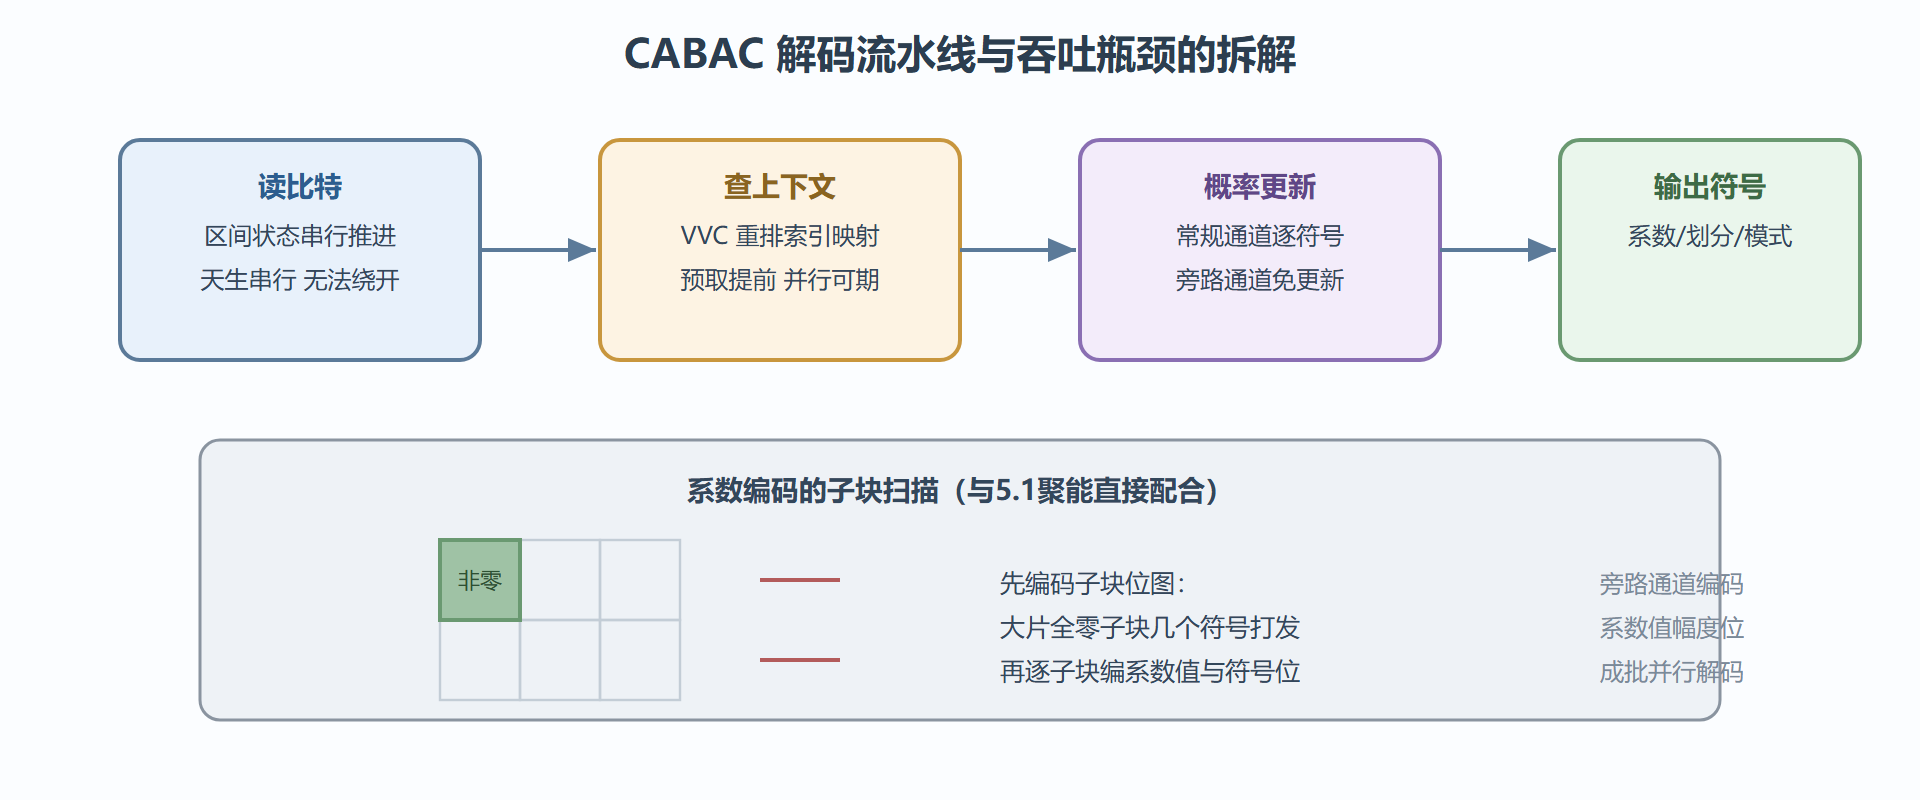
算术解码天生串行:下一个比特的解码依赖上一个符号更新后的区间状态。HEVC解码器的著名瓶颈就在这。VVC的两处关键改进:
- 上下文加载去瓶颈:解码每个二元符号前要查上下文概率表,VVC重新组织了"上下文索引→存储位置"的映射,让连续符号的上下文读取能提前、能并行预取;
- 旁路通道批处理:等概率的比特(bypass,如系数值的低位)不走概率更新,VVC允许它们成批解码——一次取多个比特并行处理,吞吐倍增。系数编码恰好是旁路大户,收益直接兑现。
其三,系数编码的新扫描组织
变换块里非零系数怎么描述?HEVC按对角扫描+游程。VVC的新组织(子块扫描+双扫描模式)把系数块切成4×4子块,先编码"哪些子块有非零"的位图,再进子块编系数;对部分帧内块还允许反向第二扫描。好处:非零系数聚集在低频(5.1节聚能的结果)时,子块位图大片全零,几个符号打发一片——熵编码与变换聚能形成了直接配合。
用一段伪代码串起第5章
一个变换单元的完整残差旅程(解码端视角): 1 sig_flags = cabac_decode_subblock_map() # 子块位图:哪些4x4块有非零 2 for sb in 非零子块(按扫描序): 3 for coef in sb: 4 sig = cabac_decode(上下文: 邻域非零数) # 本系数是否非零 5 if sig: 6 gt1 = cabac_decode(上下文: 位置相关) # 幅度是否大于1 7 rest = cabac_decode_bypass_batch() # 余下幅度位:旁路批处理 7' level = 依赖量化重建(sig, gt1, rest, 状态机) # 5.2节的有状态重建 8 coef块 = InvLFNST → InvMTS # 5.1节两级反变换 9 重建 = 预测 + 反量化残差 # 进入第6章环路滤波
五行伪代码里,第5章三节各就各位:5.3管符号怎么读、5.2管数值怎么重建、5.1管残差怎么还原。这条链路也是解码器性能优化的主战场——业界开源解码器(第10.1节)的帧率提升,大半来自把这条串行链做出并行度。
⚠️ 认知纠偏:常有初学者把熵编码当成"压缩的最后一步所以最重要"。实情相反——CABAC已经很接近熵极限,VVC在这一步的收益百分比是全流水线里最小的。大头永远在预测(第3、4章)。熵编码的价值在于不浪费前面各环节省下的每一个符号,并把解码吞吐做到工程可用。
上下文初始化与短条带:一个容易被忽略的交互
本节开头说VVC"重设初始化",这里把它的工程后果展开。上下文模型的初始概率决定条带开头几十个符号的编码效率——条带越长,初始化的影响被摊薄;条带越短,初始化质量直接决定整条带的熵效率。
这层交互在两个场景里变成主角:低延迟场景(条带切得碎,2.2节的子图并行进一步缩短条带)里,初始化先验准不准每条带都要重新付账——VVC按帧内/帧间等场景给出更准的初始值,收益在这里兑现;错误恢复场景(8.2节,丢包后从访问点重进)里,解码器重新初始化上下文的状态必须与码流意图一致,否则整条带解码漂移。实现层的教训:上下文初始化是解码器对齐测试必须覆盖的路径,只测长条带顺利路径会漏掉短条带场景的偏差。
两问两答
问:旁路通道为什么能并行?
旁路符号概率恒定对半分——解码它的区间运算不依赖概率更新,只做等分与选择。多个旁路比特的区间缩放可以预先算好(纯移位与查表),一次并行处理一串。这就是"成批解码"的算法根基,也是VVC系数吞吐提升的主要来源。
问:CABAC解码的错误会传播多远?
算术解码的区间状态一环扣一环——一个比特解错,其后所有符号全错,且通常不报错(只是画面花掉)。所以工程上把CABAC输出与后续重建的一致性校验(CRC类机制在容器层)作为码流损坏的第一道发现手段,这属于系统层设计而非熵编码本身。
本节要点回顾
- CABAC三层结构:二进制化、上下文建模、算术编码,越常见的模式记得越短;
- VVC三处翻新:上下文精简与初始化重定价、上下文加载与旁路通道的吞吐化、子块扫描的系数组织;
- 旁路批处理是吞吐关键:系数幅度位成批解码,兑现并行收益;
- 子块位图与聚能配合:全零子块几个符号打发,熵编码吃到了5.1的红利;
- 定位要摆正:熵编码不产增益,只保证不浪费;流水线优化的主战场在解码串行链。