9.3 复杂度与硬件实现友好性
9.3 复杂度与硬件实现友好性
本节摘要:VVC的效率红利不是白来的。本节摊开两张账本:编码复杂度的三大来源(划分搜索、模式竞争、解码端细化的编码端模拟),解码复杂度的量级与构成(ALF、仿射插值、依赖量化的串行性);再看标准为硬件铺的路——VPDU车道、子块尺寸下限、工具独立开关。本节吸收原"硬件实现友好性"独立小节的内容,把9.2节实验里"编码时间"一列背后的机理讲透。
第9章收官。9.1给了尺子、9.2打了样,本节算清效率之外的第二张账——它直接决定第10章的落地节奏。
编码复杂度:三大来源
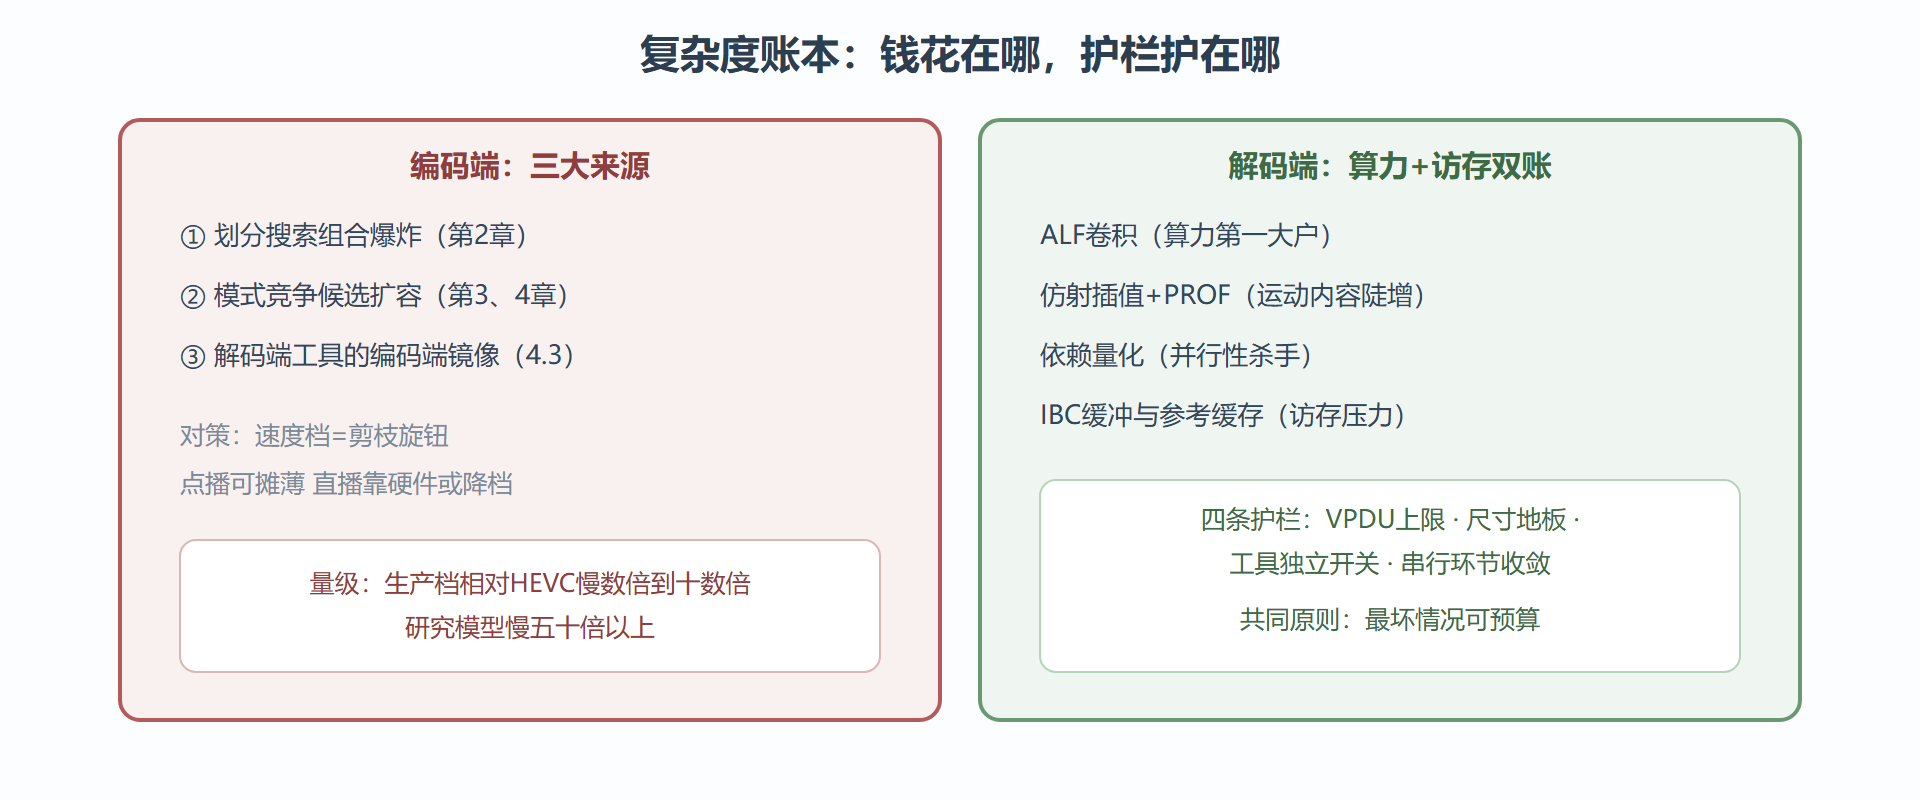
其一,划分搜索的组合爆炸(第2.1节的伏笔在此兑现)。QTMT给了划分自由,编码器要在指数级的划分树里做RD搜索。一块内容的"最优树"没法解析求解,只能靠剪枝的穷举——这是VVC编码器相对HEVC慢的第一来源。生产级编码器(如VVenC)的全部秘密武器几乎都在这里:启发式早停、粗筛加速、机器学习引导剪枝。
其二,模式竞争的候选扩容。帧内65+模式加MIP(第3章)、帧间Merge扩容加仿射加组合预测(第4章)——每个块要打的擂台赛选手翻了几倍。单项不贵,乘以每帧数万块就是数量级差异。
其三,解码端工具的编码端镜像。DMVR、BDOF这类工具(第4.3节)解码端算,但编码器RD决策时必须模拟同样过程才能预知效果——解码端细化把计算搬去了解码端,却在编码端留下了影子成本。
复杂度账本的量级感受(经验区间,随版本与档位浮动): 编码时间(同机同素材同质量目标): x265 medium 1x VVenC faster 约 2~4x VVenC medium 约 5~15x VVenC slower 约 30x+ VTM(研究模型) 约 50~100x 解码计算(相对HEVC,量级口径): 整体 约 1.5~2x 其中 ALF、仿射插值、依赖量化反量化 是三个显著增量项; 解码"慢"的另一面是访存—— IBC历史缓冲、多参考帧缓存对带宽的压力 常比计算本身更先顶到天花板。
档位的存在意义:生产编码器提供faster到slower的速度档,本质是"剪枝激进程度"旋钮——9.2节的实验里预设档是必记变量,档位每降一档,效率掉一点、速度快一截,曲线族(速度-效率包络)才是编码器的完整画像。
解码复杂度:算力与访存的双重账
解码端的三笔显著增量,逐一对应前文工具:
- ALF(第6.2节):每像素一次小卷积,是解码算力第一大户——低端设备"关ALF保帧率"的依据(码流里有开关,合规跳过);
- 仿射插值与PROF(第4.1节):子块级MV的高精度插值加梯度修正,运动内容多时算力陡增;
- 依赖量化(第5.2节)的串行性:反量化必须按扫描顺序逐系数推进状态机——它不是算力大项,而是并行性杀手。硬件解码器的流水线深度设计要专门为它开串行通道。
访存账常被低估:IBC历史缓冲(第7.1节)、双参考列表缓存、行缓冲的行数上限(VPDU的由来,第2.2节)——芯片的功耗与面积里,搬数据的成本常常盖过算数。这也是为什么标准文本里那些"尺寸下限、边界对齐"条款(第2.1节约束表)要一条条较真。
标准为硬件铺的路
复杂度失控的标准没人能用。VVC在"给自由"的同时预埋了四条护栏(本节吸收原硬件友好性小节的核心内容):
| 护栏 | 机制 | 护住的是什么 |
|---|---|---|
| VPDU约束(2.2节) | 解码触及区域上限 | 行缓冲容量可预算,芯片面积可控 |
| 子块尺寸下限 | 4×4为多数工具的粒度地板 | 处理粒度统一,流水线节拍可设计 |
| 工具独立开关 | ALF、LMCS、IBC等按块/帧可关 | 弱设备降级路径合规、平滑 |
| 串行环节收敛 | 依赖量化、ISP等串行源集中管理 | 串行段落集中,其余环节可并行展开 |
一条设计原则贯穿四条护栏:最坏情况可预算。硬件设计不看平均值看最坏情况——一块极端划分的CTU若能让流水线停摆,整个解码器的频率设计就毁了。VVC把"最坏情况"钉在可推导的边界上,芯片工程师才敢签时间表。
从账本到决策
把两张账本叠到业务上(第10章将展开的行业视角在此预热):
- 点播/转码:一次编码多次播放,编码贵可摊薄——VVenC生产档已是可用区间,效率红利净赚;
- 直播:编码预算以毫秒计,纯软件VVC直播仍靠更快档位+更强机器硬扛,或等待硬件编码器成熟;
- 终端播放:解码算力由芯片决定,旗舰SoC已就位、中低端靠工具开关降级合规("关ALF"路径)平滑过渡;
- 监控/云桌面:上行带宽与存储成本主导,编码端可离线或服务器级——SCC工具的收益(第7.1节)在这个场景被放大。
💡 决策直觉:复杂度账本的关键不是"贵不贵",而是贵在编码端还是解码端、一次性还是持续性。编码端成本随芯片工艺逐年打折,解码端成本随终端换机周期缓慢摊开——两个不同的时间常数,决定了VVC渗透曲线"云端先行、终端跟进"的形态(第10章硬件问答将反复用到这个判断)。
两问两答
问:硬件编码器为什么总是慢软件一拍?
软件编码器改的是代码(迭代周以天计),硬件是电路(流片周期以年计)——而且VVC编码的划分搜索天然适合软件的灵活剪枝,映射到固定电路反而要重新设计架构。产业规律是:标准定稿后,生产软件编码器先行铺路,硬件编码器在其后切入对成本敏感与实时性要求高的场景。
问:软件与硬件解码会长期并存吗?
会,且分工稳定:硬件解码吃走主流终端的功耗敏感场景,软件解码(10.1节的VVdeC/OpenVVC)守住三类阵地——旧终端兜底、多路并发服务端、以及新标准发布初期的"时间差"覆盖。每代标准的前几年,软解都是生态的救火队员。
本节要点回顾
- 编码复杂度三大来源:划分搜索、模式竞争、解码端工具的编码端镜像;速度档就是剪枝旋钮;
- 解码复杂度双账:算力(ALF、仿射、PROF)与访存(IBC缓冲、参考缓存)并行记账,访存常先见顶;
- 依赖量化是并行性杀手:不是算力大项,而是流水线设计的难点;
- 四条护栏一个原则:VPDU、尺寸地板、独立开关、串行收敛,共同守住"最坏情况可预算";
- 决策看时间常数:编码端成本在云端快速摊薄、解码端成本随换机周期展开——渗透形态由此定型。