10.4 后VVC时代的AI编码
10.4 后VVC时代的AI编码
本节摘要:VVC之后是什么?标准界的现在进行时有两个名字:ECM(探索性编码模型,混合框架的"下一代工具试验田")与NNVC(基于神经网络的视频编码,AI原生路线)。本节梳理两条路线的分工与进度,讲清神经编码进入生产的两大瓶颈(算力、可控性),并回望MIP开创的第三条路——把训练产物蒸馏进标准语法。全册在此收束。
第10章与全书的最后一节。第3.2节埋的"标准内小模型"伏笔、第9.3节的算力账、第10.1节的工程现实,在此合流成一个问题的答案:编码的下一个十年往哪走。
两条路线的分工
标准组织(JVET及其后续)对下一代的研究沿两条并行轨道推进:
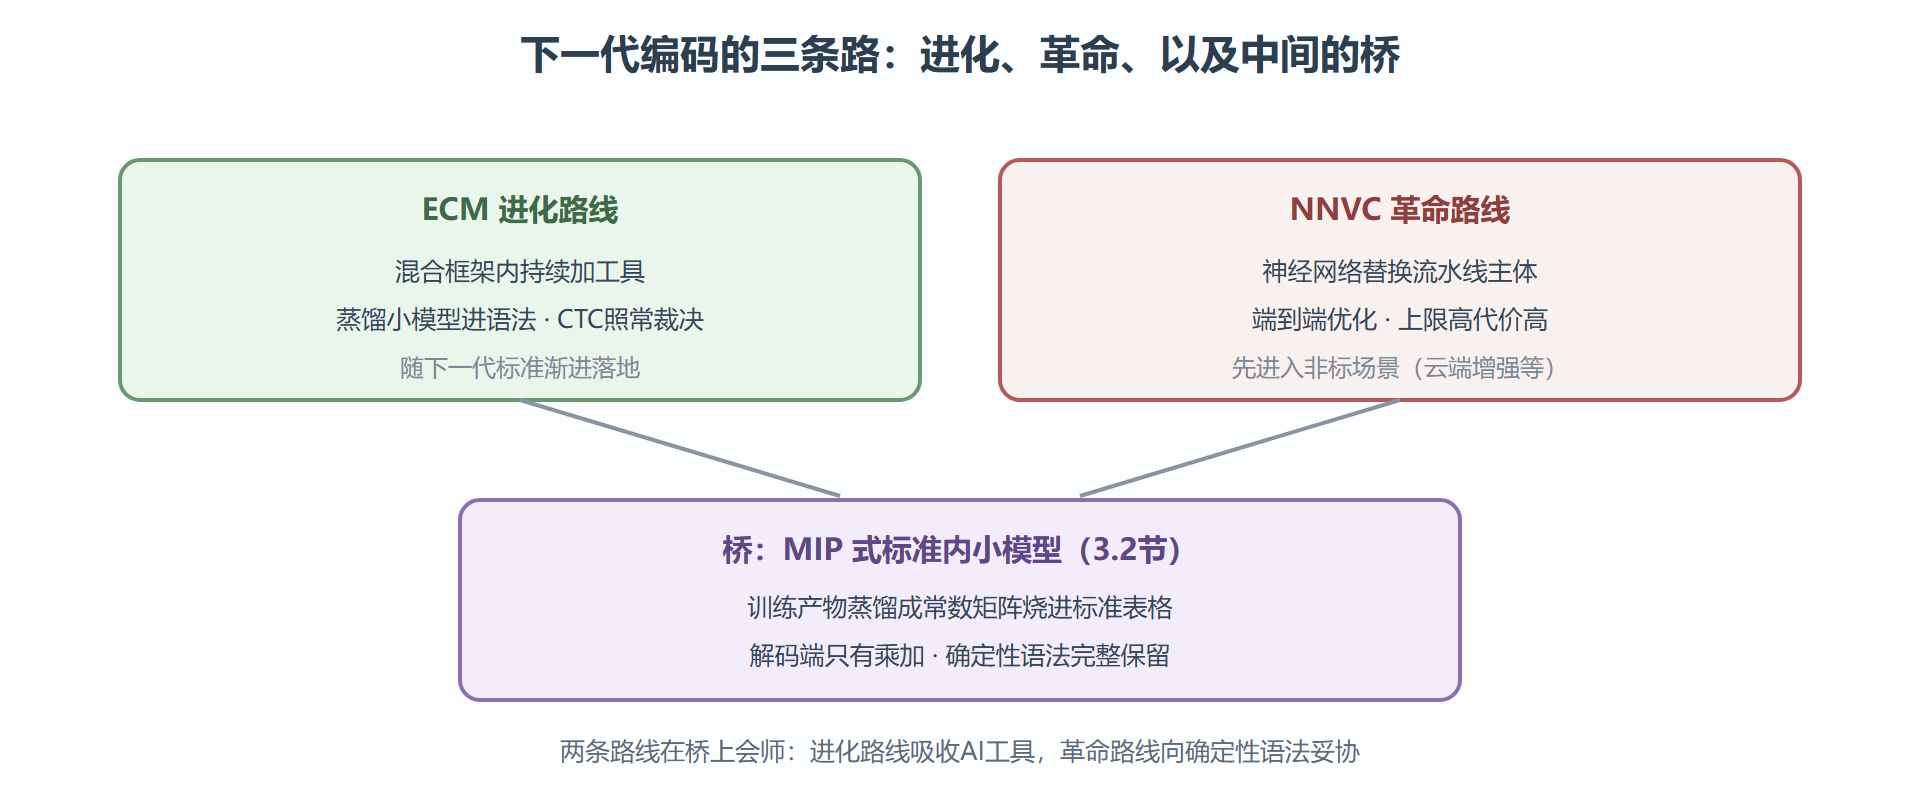
ECM(Enhanced Compression Model,增强压缩模型):不推翻混合框架,继续往里加工具——更灵活的划分、更精细的帧间预测、更强的环路处理,其中相当一部分工具本身就是轻量的机器学习模型(MIP思路的扩展:更多预训练矩阵、更聪明的模式选择)。它的收益计量沿用CTC加BD-rate(第1.1节的老方法),每一步都可复现、可裁决。ECM是"进化论"路线:渐进、可回溯、风险低。
NNVC(Neural Network-based Video Coding,基于神经网络的编码):AI原生路线——用神经网络替换流水线的整段或全部(帧内预测网络、环路滤波网络、甚至端到端的变换与熵模型)。它的上限更高(端到端优化不受手工模块的分割掣肘),但要过两道生产瓶颈(下文)。NNVC是"革命论"路线:上限高、风险与代价同样高。
| 维度 | ECM路线 | NNVC路线 |
|---|---|---|
| 框架 | 混合框架内加工具 | 替换或重造流水线 |
| AI成分 | 蒸馏后的小模型入语法 | 神经网络为主体 |
| 收益来源 | 渐进优化各环节 | 端到端联合优化 |
| 可控性/随机访问 | 完整保留 | 重建中(难点) |
| 算力 | 与VVC同量级或略增 | 高出一个量级 |
| 产业可用预期 | 随下一代标准逐步落地 | 更远期,先进入非标场景 |
神经编码的两大生产瓶颈
瓶颈一:算力与功耗。端侧解码要跑神经网络推理,模型再小也是一片乘加阵列——中低端终端的功耗与散热预算根本没这笔钱。第9.3节的账本逻辑在神经编码上原样重演且加倍:解码端成本从"算法算力"变成"模型推理",访存压力(权重搬运)更加凶残。
瓶颈二:可控性与可信赖性。生产环境对码流的要求远超"平均质量好":广播要求精确的帧级随机访问(8.2节)、医疗与安防要求确定性与可解释(出了伪影要能定位原因)、版权与合规要求比特级可复现。端到端网络在这些维度上的答卷至今不完整。混合框架最被低估的资产恰恰是它的"确定性语法"——每个像素怎么来的都有据可查,这在关键应用里是刚需而非加分项。
第三条路:MIP式的桥
回望3.2节:MIP没有带来神经网络的全部威力,却证明了一件更重要的事——训练产物可以以常数矩阵的形式进入标准语法,解码端零AI包袱、确定性完整保留、知识产权边界清晰(矩阵就是标准文本的一部分)。LFNST(5.1节)同款思路。沿着这座桥:
- 环路滤波的神经增强(比ALF更聪明的滤波系数生成)已在ECM的试验清单上;
- 帧间预测的模型化(用小模型替代部分运动搜索)在探索;
- 甚至熵编码的概率建模也有"查表化神经网络"的尝试。
桥的意义在于它绕开了两大瓶颈:小模型的推理算力与变换核同量级(9.3节账本放得下);语法确定性分毫未损。代价是潜力打折——蒸馏过的模型只能吃到端到端优化的一小部分红利。下一代标准的实际形态,很可能就是这座桥的加宽:混合框架为体、蒸馏模型为用。
💡 给工程师的站位建议:未来五年的确定性机会不在"用神经编码替代一切",而在三处——(1)编码端决策的AI化(划分剪枝、模式预判,纯编码端自由、不入语法、9.3节三大复杂度来源的解药);(2)环路滤波与后处理的神经增强(先走非标接口,等标准收编);(3)把MIP式蒸馏做深(如何把更大的模型压进更小的矩阵,是标准内AI的核心手艺)。这三处都不赌标准路线之争的输赢。
全册收束:回到裁缝铺
从第1章的家谱到本章的未来,裁缝铺的比喻可以收摊了:VVC是这家铺子四代手艺的集大成——剪刀更自由(QTMT)、量体的花样更多(65方向、MIP、仿射)、缝纫与锁边更精细(MTS、依赖量化)、熨烫三连招(去块、SAO、ALF)、打包更巧妙(CABAC、参数集、随机访问),还兼营屏幕布料(SCC)与球形布料(全景)的定制。下一代铺子会引入电动缝纫机(AI工具),但量体-裁剪-缝纫的工序并未消亡——好的工具演进从不推翻工序,只重塑每一道工序的手艺。读懂了这句话,你就读懂了这套文集。
现状的数字直觉与从业者建议
给"瓶颈一:算力"一个量级锚点(经验口径,随硬件演进浮动):与VVC解码同主观质量的端到端神经编码方案,解码端算力需求高出数倍到一个量级——这个差距不是优化能抹平的量级,而是范式差。它在云端(算力富裕、按质付费的场景)已经可用,卡住的始终是端侧。这也解释了产业现状:神经编码最先落地的位置是云端转码与增强服务(如基于网络的后处理提升旧片源质量),而非标准码流本身——不动标准、只动两端,是绕开两大瓶颈的商业化捷径。
给准备入行的工程师三句话:第一,把混合框架学透(本册的路径)永远是第一性——AI编码研究的论文里,最好的那些恰恰出自对混合框架理解最深的手;第二,跟着开源走(10.1节工具链加学术界开源编码研究项目),复现一篇端到端论文比读十篇更有体感;第三,盯住"蒸馏"这门手艺——如何把网络压小、压准、压进确定性语法,是未来十年标准内AI的核心竞争力。
本节要点回顾
- 两条路线分工明确:ECM进化(混合框架内加工具、CTC裁决)、NNVC革命(网络为主体、上限高代价高);
- 神经编码两大瓶颈:端侧推理算力/功耗,与生产环境要求的确定性、随机访问、可解释;
- MIP式蒸馏是桥:训练产物烧进标准表格,绕开两瓶颈、代价是潜力打折;
- 下一代形态大概率是桥的加宽:混合框架为体、蒸馏模型为用;
- 工程师的确定性机会三处:编码端AI化、滤波神经增强、蒸馏手艺本身。