4.2 BVH:从建树到遍历的完整拆解
4.2 BVH:从建树到遍历的完整拆解
上一节的分野立在台面上:切空间还是切物体。本节的主角包围体层次结构(BVH)站在物体剖分一侧——它不划分空间,而是把基元递归分组,每组裹一个包围盒。这个看似朴素的倒置,恰好避开了 kd 树的三笔重账:基元只属于一个叶子、节点数与基元数同阶、构建快一个量级。代价是兄弟盒子的互相重叠,需要靠"切得聪明"来弥补——于是本节的主线就是两件事:怎么建一棵聪明的树(SAH),怎么把树走得快(顺序栈遍历)。
建树第一步:中位数切分与它的天花板
最朴素的 BVH 构建是中位数切分:在基元中心最分散的轴上排序,从中间劈成两半,递归直到每叶只剩少数基元。实现只要二十行,构建复杂度与排序同阶,效果"能用"。但它的盲目性也显而易见:劈开的只是"数量",不管"空间"。一列基元中心均匀分布、体积悬殊时,中位数劈法可能让小盒子里塞着巨大包围盒、大盒子反而空旷,重叠与浪费随之而来。
改良的第一步是中点切分:取包围盒最最长轴的中点作分界面,按基元中心在界面的哪侧分组。它在常规场景往往更好,但遇到基元中心挤成一团而体积四散的场景,会把所有基元分进同一侧、树退化成链表。两类朴素方案的共同缺陷是:没有任何一个量在度量"切得好不好"。要把这件事做好,得先给"好"定一个价。
SAH:给每次切割定价
表面积启发式(Surface Area Heuristic)的出发点是一条概率常识:一条随机射线穿过某个包围盒的概率,正比于该盒子的表面积。于是任何一次切割的期望成本都可以定价:遍历节点有固定开销,射线命中左盒的概率乘以左子树的求交成本、命中右盒的概率乘以右子树的求交成本,全部加起来——
C(切法) = C_遍历 + (面积_左 / 面积_父) × N_左 × C_求交 + (面积_右 / 面积_父) × N_右 × C_求交 若 C(切成叶子) = N × C_求交 更便宜,则停止切分,直接做叶子
公式的三个因子各有深意。面积比是命中概率的估计——把子盒切得越小越分离,代价越低;基元数是求交成本——每叶基元越少越便宜;"切了还不如不切"的比较给了算法一个自然的停止条件,避免了为三五个基元继续掏遍历税的场景。构建时在每个节点穷举三个轴、沿轴滑动分界平面评估所有候选,取最便宜者。代价是构建时间翻几倍,换来的遍历性能提升通常有五成上下——离线渲染与引擎离线构建场景里稳赚,实时每帧重建则吃紧,这个矛盾 4.3 会专门处理。
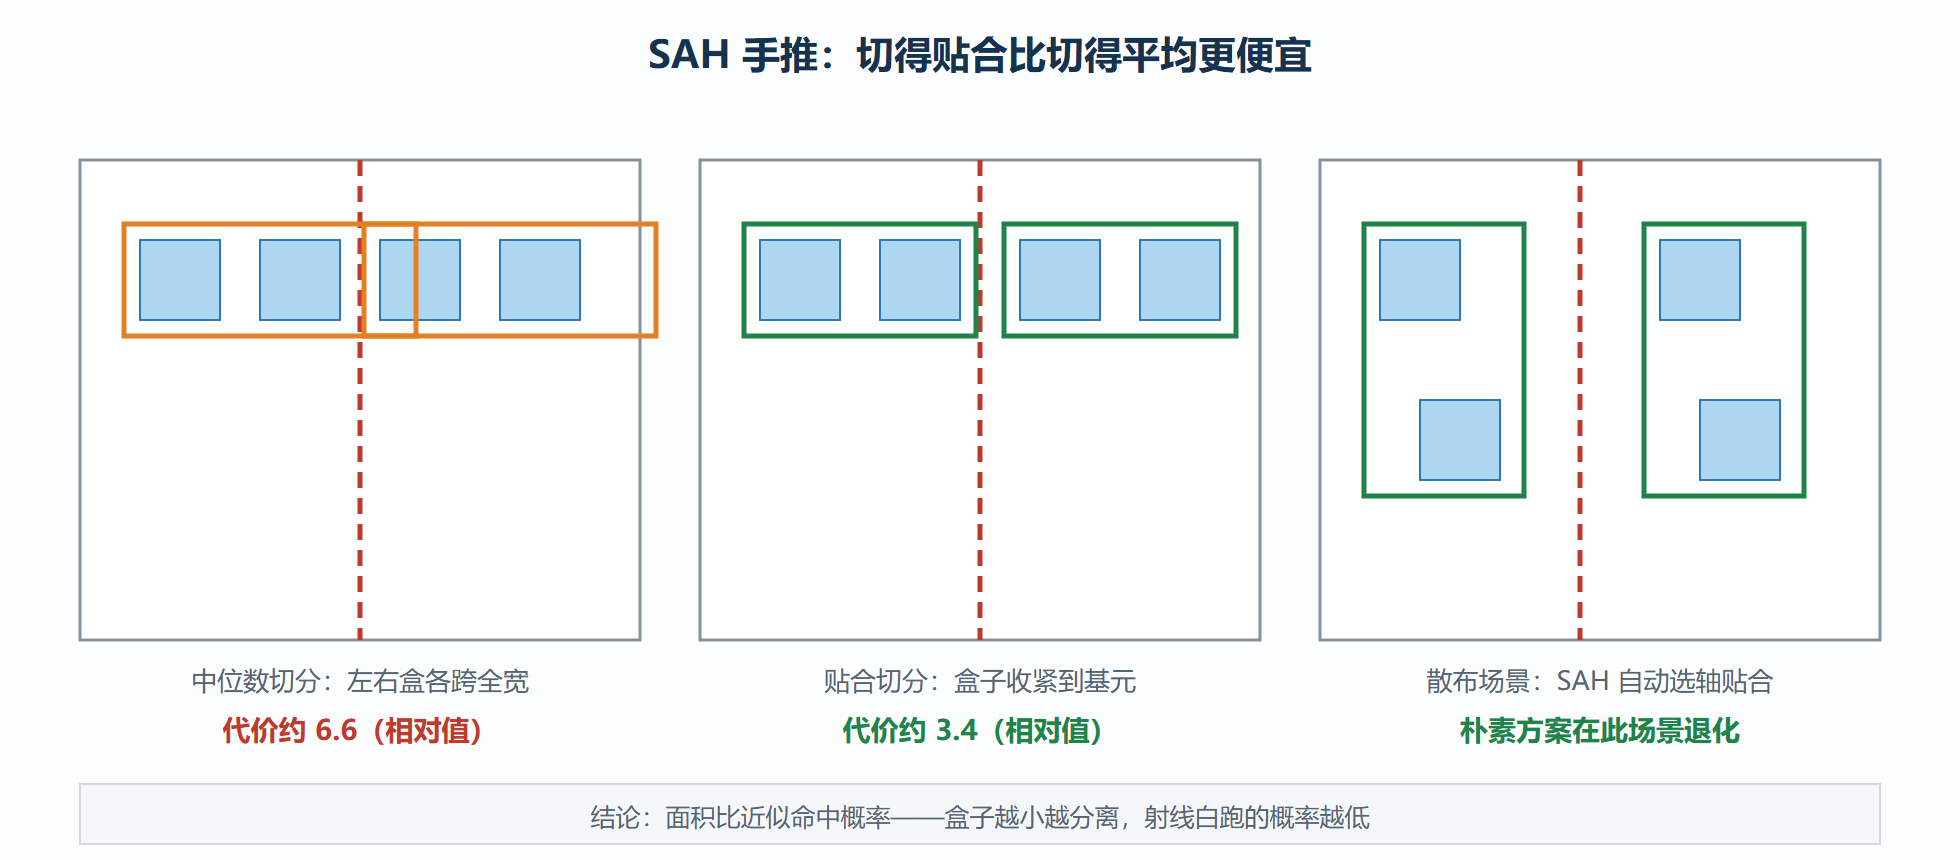
手推一个小算例把公式焐热。四个单位立方体,中心在 x 等于 1、2、10、11 处,父盒表面积约 2000(量纲只看相对值),C_遍历取 1、C_求交取 2。方案甲沿 x 等于 6 分界:左二右二,左右子盒各含 1 到 11 的跨度,表面积各约 1400,代价约 1 + (1400/2000)×2×2 + (1400/2000)×2×2 = 6.6。方案乙沿 x 等于 3 分界:左二右二,但左盒只跨 1 到 2、表面积约 600,右盒跨 10 到 11、约 600,代价约 1 + 0.3×2×2 + 0.3×2×2 = 3.4。同样的数量切分,切得贴合的方案乙便宜近一半——SAH 的价值就是在这千万次切割里都选中乙这类切法。
图:同一组基元的三种切法与 SAH 代价对比
遍历:顺序栈与两个提速支点
树建好了,射线怎么走?标准答案是顺序栈遍历:从根出发,测两个孩子的包围盒区间(3.1 平板法),都命中就先压远的、走近的——栈保证后出的近孩子先被处理,一旦它命中且距离小于远孩子的进入区间,整棵远子树直接丢弃。
function bvh_traverse(ray): stack.push(root); best = miss while stack not empty: node = stack.pop() if node.box.t_enter > best.t: continue # 支点一:区间裁剪 if node.is_leaf: best = min(best, intersect_prims(node, ray)) else: near, far = order_by_entry(node.left, node.right, ray) stack.push(far) # 支点二:近孩子优先 stack.push(near) # 栈后进先出,近者先处理 return best
支点一的本质是拿"进入子树的最早距离"与"当前最优命中距离"比价:比最优还晚才进盒的子树,无论如何不可能给出更近的命中。支点二的价值在于让"丢弃"更早发生——近孩子先完成求交,远孩子常在出栈前就死于支点一的判断。any-hit 类查询(阴影、遮挡)还有额外红利:不需要最近,撞上任何东西立即返回,遍历甚至不必按距离排序。衡量一棵树的三个实务指标也顺带立此存照:平均访问节点数(越低越好)、盒子重叠度(SAH 代价的实况)、内存布局(叶子与节点紧凑排布、索引用 32 位整数,直接决定缓存命中率)。
实验台:给迷你渲染器装上第一棵树
动手环节。沿用第 3 章的三球一平面场景只有五个基元,BVH 显然是杀鸡用牛刀——所以这次把场景扩成两千个随机球。第一步,按 4.2 公式实现 SAH 建树(先用中位数版对拍正确性,再换 SAH 版比性能);第二步,接入顺序栈遍历,统计每条射线平均访问节点数。典型结果:暴力遍历每射线约两千次球测试,BVH 版访问内部节点约四十个、叶子测试约八次,总求交开销降两个数量级。解读时留意一个反直觉现象:把每叶基元数从 4 调到 1,树更深、节点更多,总耗时反而可能变差——遍历税吃掉了求交节省。变式:把 balls 换成三根细长圆柱,观察 SAH 树与中位数树的访问节点数差距急剧拉大——细长斜置基元正是朴素切分的死穴。
家族速览:宽节点与压缩
教材里的 BVH 都是二叉的,工业实现大多是四叉或八叉的宽节点版本:一次访存取回四个或八个孩子的盒子,遍历器对这批孩子做批量区间测试,再统一按距离排序入栈。收益来自摊薄——树深的对数底从 2 换成 4 或 8,跳转次数骤减,而批量测试恰好喂饱向量计算单元。代价是树质量略降、建树代码变复杂,真实收益要在实测里验证:通常是每射线访问节点数降三成上下,总耗时降一到两成。
压缩是另一条省钱路线。盒子坐标不存浮点全量,改存"节点基准值加八位量化偏移",节点体积缩到四分之一左右,缓存命中率随之上涨。量化有精度损失,但对剪枝影响甚微——盒子本来就是保守估计,边界差千分之几换命中率大涨,是笔好交易。这两项改造都不动算法骨架,只在数据布局上做文章,收益却常常超过换算法本身。BVH 调优的次序因此应该是:先把 SAH 质量调对,再上宽节点与压缩,最后才考虑更偏门的遍历技巧——顺序反了,等于在没铺平的地基上装修。
本节要点回顾
- BVH 切物体不切空间:基元只属一个叶子、节点数与基元同阶、构建比 kd 树快一个量级;代价是兄弟盒重叠。
- SAH 用表面积估算命中概率,把"切得好不好"变成可比价的数字,且自带"切不如停"的终止条件。
- 顺序栈遍历两支点:区间裁剪丢弃无效子树,近孩子优先让丢弃更早发生;any-hit 查询免排序还有额外红利。
- 每叶基元数是遍历税与求交费的平衡点,典型取 2 到 8,需按场景实测。
- 树质量三指标:平均访问节点数、盒子重叠度、内存布局紧凑度。
静态场景的树已臻完善。可世界会动——角色迈步、粒子飞溅,树怎么办?下一节把 refit、rebuild 与 TLAS、BLAS 送上实验台。