4.1 空间分区:网格、八叉树与kd树
4.1 空间分区:网格、八叉树与 kd 树
上一章末尾留了道算术题:百万三角形对上亿射线,裸奔必死。本节上第一味药——给空间本身打格子。网格、八叉树、kd 树是同一思想的三个版本,本节把它们逐个拆开,最后立起一个贯穿本章的概念分野:切空间的方案允许基元横跨格子,切物体的方案允许包围盒重叠。看清这条分野,4.2 的 BVH 为什么赢、什么时候输,就全部可以推出来。
均匀网格:最笨也最诚实的起点
做法没有任何玄机:场景包进一个大盒子,切成 n 乘 n 乘 n 的小格子,每个三角形登记到自己覆盖的所有格子里。查询时射线先走格子、只与路过的格子里的三角形求交。格子怎么走?三维数字差分分析(DDA):从射线起点所在的格子出发,每次跨到"沿方向最先碰到的下一张格子壁",步进量由三个轴向的跨壁距离取最小值得出——正是 3.1 平板法区间思想的逐格版本。
function grid_traverse(ray, grid): cell = grid.cell_of(ray.origin) t = ray.tmin while cell is valid and t <= ray.tmax: for prim in grid[cell]: # 只查路过格子的基元 if intersect(prim, ray): return hit t = t + min_distance_to_next_wall(ray, cell) # 三轴跨壁取最小 cell = grid.next_cell(ray, cell) return miss
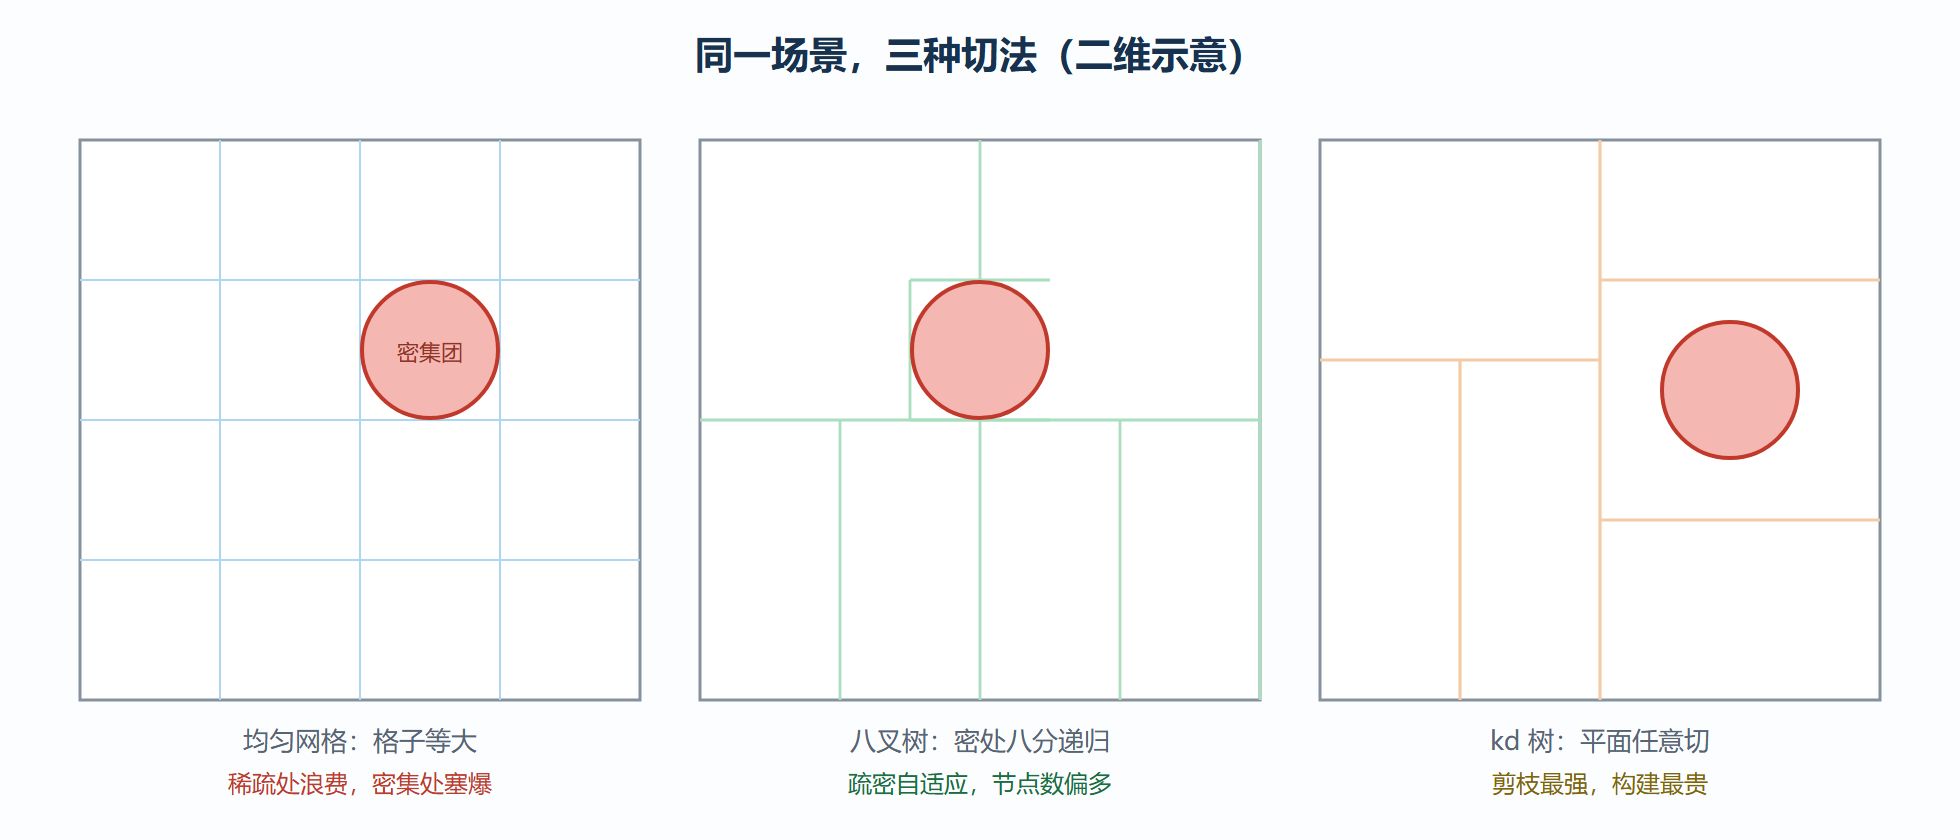
均匀网格的成败全押在分布均匀性上。理想场景(粒子云、头发束)里基元密度平坦,它表现良好;可一旦遇到"茶壶放在体育场里"的经典病态——场景里既有毫米级精细模型又有上百米开阔空间——格子尺寸顾小则大空间里格子数爆炸,顾大则小空间里每个格子塞进成千上万三角形,剪枝能力归零。这个病态没有修复参数可调,只能靠"非均匀"的结构救场。
八叉树与 kd 树:给空间装上自适应
八叉树递归地把每个立方体切成八个子块,哪里密就往哪里多切几层——体育场保持一层的粗格子,茶壶内部细切到毫米级。kd 树把自适应推得更彻底:每次不切八块而是用一个轴对齐平面把节点切成左右两半,切割轴与位置可选,空间利用率远高于八叉树的强制等分,也是空间剖分家族的精度上限。
代价同样清楚。其一,基元横跨:一个斜跨多个子空间的三角形必须登记进多个叶子(kd 树的 clipping 技巧可以切分三角形来缓解,但切分本身有数值与存储代价);其二,树结构体积:百万三角形场景的 kd 树常有上千万节点,内存占用与遍历指针跳转都不轻;其三,构建昂贵:好的切割位置需要评估大量候选平面,建一棵高质量 kd 树的时间通常是 BVH 的数倍。这三笔账决定了它在现代渲染器里的地位:遍历质量曾经第一,但构建太慢、对硬件不友好,工程上逐渐让位。
图:三种空间分区对同一场景的切分方式
手推一遍二维 DDA:把遍历走成脚步
光看伪码容易飘,纸上走一遍。取二维简化(三维同理多一轴):网格线在 x 等于 0、1、2 与 y 等于 0、1、2;射线起点 (0.5, 0.5)、方向 (1, 0.4)。起点格子 (0, 0)。x 方向到下一条竖线的距离是 0.5,y 方向是 0.5——同刻到达角点,随意取 x 优先,步进到格子 (1, 0),行进距离 0.5。此后 x 跨壁间距恒为 1 除以 1(方向 x 分量)等于 1,y 跨壁间距为 1 除以 0.4 等于 2.5,于是下一步走 x,进格子 (2, 0),累计 1.5。再下一步该走 y:进格子 (2, 1),累计 4.0。全程只访问 4 个格子——而暴力遍历要检查场景全部基元。这个"每次只走一步、步长取三轴最小"的纪律,就是网格遍历的全部秘密;实现时最常见的 bug 是忘了累计 t 要与射线的 tmax 比较,导致射线早该停下的地方还在空转。
实验台:给两个场景各配一味药
场景 A,静态建筑可视化:八万三角形,分布极不均匀——大面积空墙配局部雕花。均匀网格被"茶壶在体育场"病态直接击倒;kd 树遍历质量最高但八万三角形不构成构建瓶颈,可行;但工程首选仍是下一节的 BVH——质量接近 kd 树,构建快数倍,内存省一半以上。场景 B,每帧更新的五十万粒子:任何树结构的构建都追不上帧率,反而是分辨率适中的均匀网格占优——每帧只需把粒子按格子重登记,构建近乎免费,DDA 遍历也简单。两个案例合起来读出一条选型律:结构开销与动态性成反比,越贵的树越只配伺候越静态的几何。变式自查:头发渲染为什么偏爱专门的束状结构而非通用树?(提示:几十万根细长基元,横跨问题极端严重,行业用按发束聚合的层次结构绕开。)
网格分辨率:一个被低估的旋钮
均匀网格并非只有"用与不用"两个选项,分辨率就是它的全部艺术。求交成本有两个对手:单格基元数决定暴力求交的批量,总格数决定空格步进的趟数。分辨率翻倍,三维里格子数涨八倍,单格拥挤度却只降两三成——网格因此存在一个甜蜜区间:粗了被拥挤杀死,细了被遍历步数与内存杀死。一个可操作的起点是让格子总数与基元数保持同数量级,再按实测的平均访问格数微调。粒子场景还有一招"按维度配分辨率":把分辨率让给几何变化剧烈的维度、收紧平坦的维度,比各向同性布格子聪明得多。
| 结构 | 构建成本 | 更新成本 | 剪枝质量 | 内存开销 | 适配场景 |
|---|---|---|---|---|---|
| 均匀网格 | 近乎免费 | 每帧重登记可承受 | 均匀场景尚可、病态崩溃 | 与分辨率幂次相关 | 粒子、体数据 |
| 八叉树 | 中等 | 慢 | 自适应良好 | 指针开销大 | 稀疏体素 |
| kd 树 | 贵一个量级 | 极慢 | 最强 | 大 | 纯静态、极致质量 |
| 粗格加局部树 | 中 | 中 | 良好 | 中 | 头发、植被等海量细基元 |
表格之外补一条横向观察:这几种结构对缓存的态度截然不同。均匀网格的格子排成紧凑数组,DDA 每步只看一个邻居,访存轨迹近乎线性;kd 树节点虽也能数组化,但剪枝带来的跳转轨迹高度随机,缓存命中率天然吃亏。这解释了一个反直觉的工程现象:剪枝质量最高的 kd 树,在真实硬件上未必跑得赢质量平平的网格——访存模式是坐在复杂度公式头顶上的隐形变量,第 9 章性能剖析会把它请上台面。
还有一类介于两大家族之间的混合物值得点名:先粗网格分桶,桶内再建小树。遍历先走便宜的网格步进,进入目标桶后才付精细遍历的贵账。实时引擎处理头发、植被这类海量细长基元时常用这一手——宏观步进保下限,局部精细保质量。结构选型从来不是单选题,是配比题。
配比之外再祛一次魅:不要迷信"某结构更快"的通用结论,同一结构在两台机器上名次互换并不罕见——访存延迟、缓存层级、向量宽度都会改写结果。正确姿势是带着两三个候选在自家硬件上实测,本章的复杂度分析负责缩小候选范围,实测负责投最后一票。这也是把"茶壶在体育场"这类病态场景写进测试集的原因:病态数据是结构间差距的放大器,平均数据只会告诉你大家都差不多。
本节要点回顾
- 均匀网格构建近乎免费、遍历靠 DDA 步进,输给分布不均的"茶壶在体育场"病态。
- 八叉树与 kd 树用递归细分换来自适应,kd 树剪枝最强但构建贵、内存大、基元横跨问题重。
- 概念分野:空间剖分允许基元横跨格子,物体剖分允许包围盒重叠——两大家族差异的总根源。
- DDA 手推要点:三轴跨壁取最小步进,累计 t 必须与 tmax 比较。
- 选型律:动态性越强,越要选构建便宜的粗结构;静态高价值场景才养得起精细树。
空间剖分家族已经看完。下一节请出真正的工业主力 BVH——它站在分野的另一侧:不切空间,切物体。