8.1 RT Core与专用硬件:遍历铸进电路
8.1 RT Core 与专用硬件:遍历铸进电路
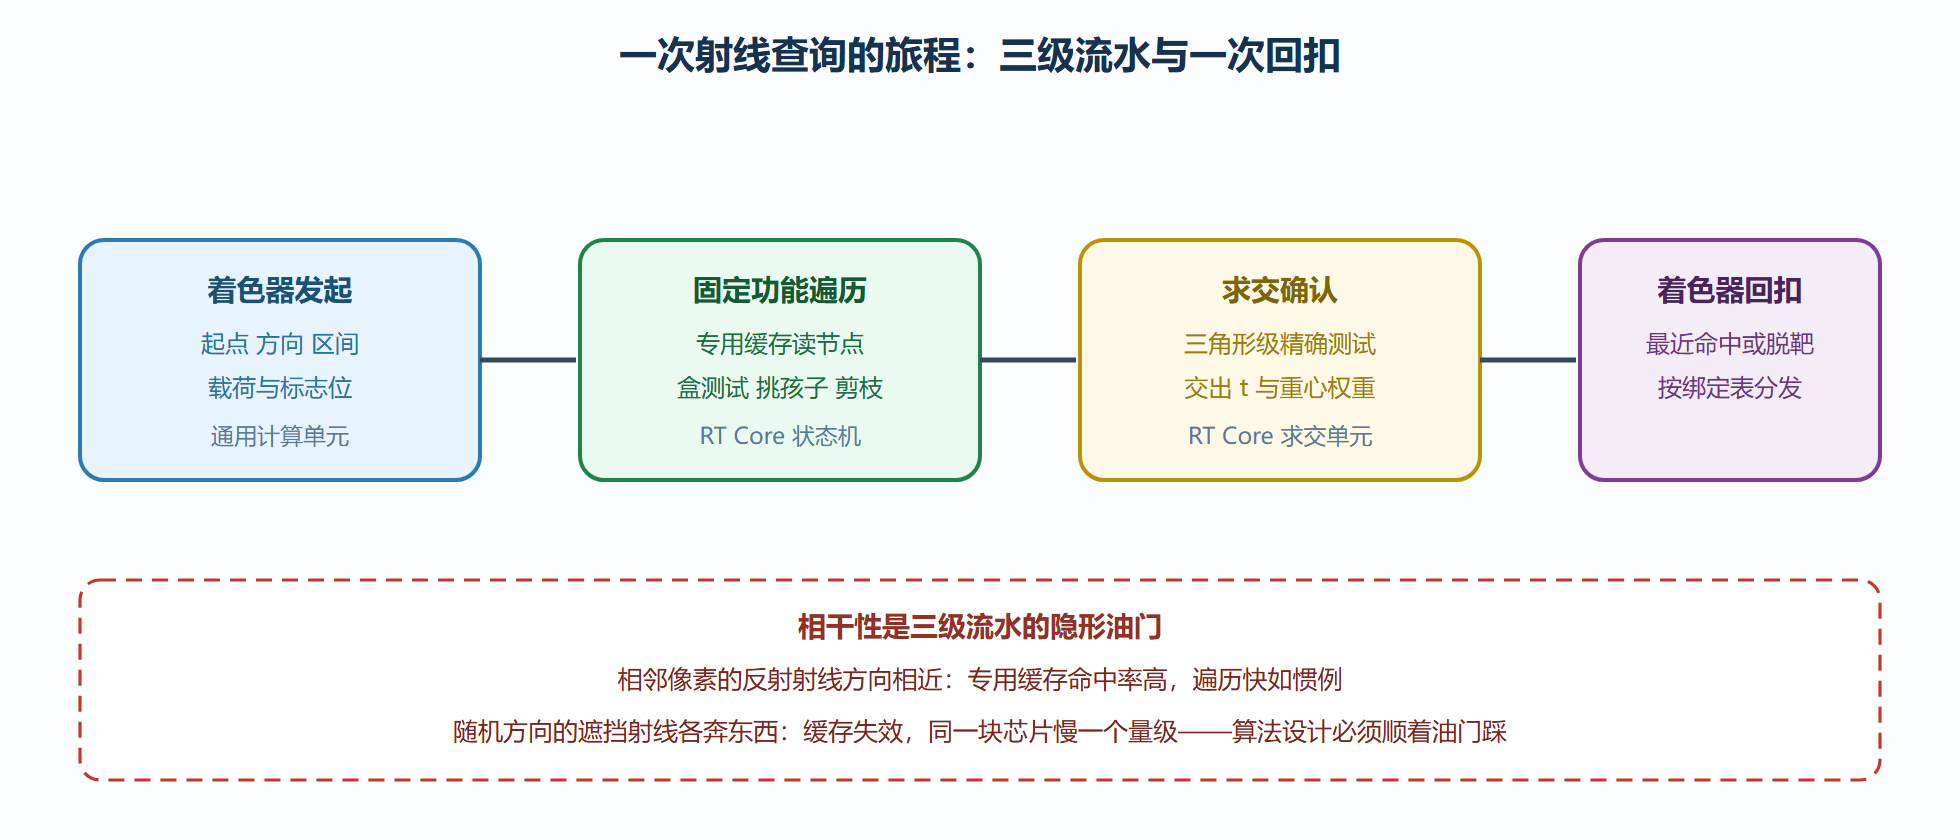
上一章的遍历伪码跑在通用计算单元上时,性能瓶颈不在算术而在访存:每下一个 BVH 节点都是一次随机的指针跳转,缓存命中率低得可怜。本节的主角 RT Core 就是针对这个病根的器官移植——把遍历与求交从"软件循环"变成"硬件状态机"。本节拆它的三级流水线、直面它的软肋(相干性问题),并交代软件侧的配合手段。读完你会明白:专用硬件不是"更快的通用计算",而是一笔"按公共部分固化、按契约组织数据"的交易。
为什么恰恰是遍历被固化
先看交易的一方。GPU 的通用单元擅长规整的批量算术,最怕两件事:分支发散与随机访存。而 BVH 遍历恰好两样全占——不同射线路径不同(发散),节点在内存里随处分布(随机跳转)。测算下来,遍历环节的耗时大头是等显存返回,算术单元大量时间在空转。软件层面的优化(节点压缩、预取、紧凑布局)能救一部分,但救不满:指针跳转的延迟就是延迟。
再看交易的另一方:把遍历做成固定功能电路,换来三个通用单元给不了的属性。其一,专用缓存——遍历单元挂一个为 BVH 节点定制的小缓存,热点节点命中率远超通用缓存。其二,无分支状态机——硬件按固定节奏吐节点、测盒子、挑孩子,不占着色器的寄存器与分支预测。其三,与着色器解耦——遍历是长延迟任务,专用单元在等着色器返回期间可以继续推进其他射线的遍历,天然把"遍历"与"着色"两种节奏流水化。三者合起来,硬件遍历对软件遍历的吞吐差是数倍到十数倍量级——这笔账支撑了从"通用计算光追"到"RT Core 光追"的整代迁移。
图:一次射线查询的三级流水
相干性:硬件契约的另一面
固化电路按"公共部分"设计,而射线间最大的公共部分是方向相近。相邻像素的主光线、镜像面上的反射射线、大片平面上的阴影射线——成束发射时,一束射线几乎读同一批 BVH 节点,专用缓存吃得很饱,硬件吞吐拉满。反过来,路径追踪式的随机弹跳让束内射线各奔东西:每个节点只为一条射线服务,缓存形同虚设,性能跌落一个量级。这就是"实时光追先普及阴影与反射、路径追踪要靠降噪器撑腰"的硬件层解释——第 7 章那些算法选择,本质上都在顺着相干性这条油门踩。
软件侧的配合手段也围绕相干性展开。射线重排:把一帧内数千条待发射射线按方向或起点聚类后再提交,牺牲一点并行度换束内相近——部分驱动与硬件的着色器执行重排机制正在把这个工作从软件挪进硬件。结构组织:TLAS 的实例按空间聚合,让"近的实例在树上也近";BLAS 节点做定向压缩(按主轴存储),减小节点体积提升缓存驻留。这些手段的共同哲学与 4.2 的内存布局一脉相承:数据形状服从访问模式,访问模式服从硬件脾气。
实验台:同场景两套遍历的对照
一个值得亲手做的对照实验:同一样例场景(二十万三角形、三种查询——主光线、阴影射线、随机方向遮挡采样),分别在纯计算着色器遍历与硬件查询两种路径下计时。典型观察分三行。主光线:两套方案差距数倍,硬件胜在专用缓存与无分支状态机。阴影射线:硬件优势进一步拉大——any-hit 的提前退出被硬件状态机天然支持,软件版还要自己写栈管理。随机遮挡采样:差距显著收窄,硬件版被缓存失效拖住,此时算法侧的射线聚类反而成了决定性因素。解读结论:硬件不是免费的午餐券,而是一张按相干性计价的价目表——项目里哪类查询占比高,直接决定硬件加速的兑现率。变式:离线渲染 farms 至今仍以 CPU 求交内核(下一节的 Embree 一族)为主力,因为离线路径追踪的高随机性让固定功能电路的兑现率打折,而 CPU 端的大缓存与复杂分支预测恰好补位——"什么场景用什么芯片"本身就是一条工程决策。
代际演进与一张对照表
固定功能遍历单元不是一潭死水,代际之间沿两条线迭代。第一条线是吞吐与功能:早期单元只支持三角形的最近命中,后续代次陆续把任一命中原生化(阴影射线不再需要着色器往返)、支持每实例标志与自定义求交回扣、加入射线排序的硬件队列——让乱序射线在进流水线前被重新聚簇,这正是软件时代射线重排思想的电路化。第二条线是数据格式:压缩节点、量化边界、实例级变换常量化,显存带宽省下的每一字节都直接变成吞吐;第 4 章讲过的 BVH 压缩,在硬件侧被推到更极致的形态。
把两条遍历路线的账摆在一张表里:
| 维度 | 计算着色器软件遍历 | 固定功能遍历单元 |
|---|---|---|
| 相干射线吞吐 | 好 | 极好 |
| 随机射线吞吐 | 尚可,大缓存补位 | 差一个量级 |
| 算法自由度 | 完全可编程 | 限定查询类型 |
| 定制几何求交 | 循环里随便加 | 走回扣着色器,往返贵 |
| 迭代与调试 | 常规工具链 | 需专用剖面工具 |
表格右侧的"限定"两行解释了一个现象:高度定制求交(程序化几何、体积介质、发丝曲线)的项目在硬件单元上反而要精打细算——自定义求交要退回着色器执行,往返流水线的开销吃掉固化红利。
代际线之外还有一条值得记录的支线:着色器执行重排。思路是承认乱序不可避免,于是先照常执行、到回扣着色器门口再按材质与状态重新排队,把分散的着色器分支聚成一簇。它把第 9 章波前调度的思想挪进了驱动层,对材质高度多样的场景收益可观——本质还是那句话:相干性可以制造,不必只靠场景赏赐。顺着这条线还能看到混合形态的兴起:相干的大批量查询(阴影、反射)走硬件,随机弹跳走计算着色器软件内核,两套结果在着色层合流。工程复杂度不小,但两端各吃最优——它存在的本身,就是对"价目表"最好的注脚。
收尾给一个判据句:项目里最近命中与任一命中占查询九成以上(阴影、反射、可见性类),固定功能单元的兑现率就高;查询以随机弹跳为主(路径追踪核心、复杂介质),兑现率要按折扣估。这句话不能替代实测,但能在立项会上替你挡掉一半想当然。
把本章与第 4 章连读还有一层深意:BVH 是软件与硬件的共同语言。同一棵树、同一套遍历语义,在处理器上是精心布局的数组,在固定功能单元里是状态机的指令流,在接口层是两步构建调用——三层对"树"的理解完全一致,才有了"一次建模、处处加速"的生态。这也是第 4 章每个工程细节(SAH 质量、压缩、粒度)都能穿透到本章兑现的原因:数据结构是契约,契约越稳,上下层的创新越自由。回望本节开头的移植比喻,外科的黄金法则是血型匹配——RT Core 的血型是相干性,受体的血型是查询类型分布;匹配的移植排异小、恢复快,不匹配的硬移植轻则兑现率打折、重则推倒重来。判断血型的手段本章已给全:统计查询类型分布、对照价目表、跑对照实验,三步走完,硬件决策就从玄学变成算术。从本章起,实时光追的一切讨论都默认这张价目表在场;价目表本身也会随代际重印——相干性折扣率在缩小,专用单元越来越会伺候随机射线,但按匹配度定价的结构没变。
本节要点回顾
- 遍历被固化是因为它是访存延迟问题:专用缓存加无分支状态机,吞吐比软件遍历高数倍到十数倍。
- 三级流水:着色器发起、固定功能遍历与求交、着色器回扣——遍历与着色两种节奏被硬件流水化解耦。
- 相干性是隐形油门:方向相近的射线束快,随机射线慢一个量级;算法设计要顺着踩。
- 软件配合三板斧:射线重排、实例空间聚合、节点压缩——都服从"数据形状服从硬件脾气"。
- 离线 CPU 渲染仍是求交内核的领地:芯片选型本身就是按查询类型做的工程决策。
芯片讲完了,交易要有文本——下一节看接口层如何把这套硬件现实写进标准:DXR、Vulkan、Metal 与整个软件生态。