8.2 图形API与软件生态:把硬件写成标准
8.2 图形 API 与软件生态:把硬件写成标准
上一节是一纸硬件契约的"芯片方条款",本节读它的文本——图形 API 与软件库。三大平台的接口(DXR、Vulkan 光追、Metal 光追)在细节上各有方言,概念骨架却完全一致:加速结构的构建与更新、两种射线查询编程模型、着色器分发机制、递归治理。本节先拆骨架,再看软件库(OptiX、Embree 一族)各自卡在哪一层,最后把整条技术栈拼成一张能指导选型的地图(本节吸收原 8.3 软件库内容)。
两种编程模型:管线式与内联式
接口层最重要的分野是"射线查询怎么写"。管线式(DXR 1.0、Vulkan 光追管线):把光追当成一种独立管线——着色器分种类(射线生成、最近命中、脱靶、任意命中),发射射线等于跨着色器跳转,命中后由硬件按绑定表分发到对应的命中着色器。表达力强、天然支持复杂递归逻辑,代价是组织成本高:管线对象、绑定表、着色器标识符一套全要管理。内联式(DXR 1.1 的 ray query、Vulkan 的 ray query):在任何普通着色器里直接发起一次射线查询,函数调用风格,命中结果当场拿回,去哪个着色器、怎么继续完全由自己写。门槛低、控制粒度细,是"光栅化为主体、光追做点查询"的混合管线(第 7 章)的天然搭档——所以今天的商业引擎主力几乎都是内联式。
// 内联式查询(概念示意,以 DXR 风格表达) RayDesc ray; ray.Origin = hitPos + normal * EPS; // 第3章的防自交偏移 ray.Direction = sampleDir; ray.TMin = 0.0; ray.TMax = 1e30; RayQuery< RAY_FLAG_ACCEPT_FIRST_HIT_AND_END_SEARCH > q; // 阴影射线:命中即停 q.TraceRayInline(accelStruct, 0, 0xFF, ray); while (q.Proceed()) { // 每个候选命中都过一遍自定义过滤(透明体衰减等) if (isOpaque(q.CandidateInstanceID())) q.CommitProceduralPrimitiveHit(q.CandidateTriangleRayT()); } if (q.CommittedStatus() == COMMITTED_NOT_HIT) indirectLight += skyContribution; // 通畅则计入天空光
选择的心法一句话:要渲染器式的多跳递归用管线式,要引擎式的定点查询用内联式。两者还能混用——离线模式切管线式,实时模式切内联式,同一套加速结构通吃。
着色器分发:用寻址替代函数调用
管线式模型的分发机制值得单独拆,因为它最能体现"接口是硬件约束的语法化"。着色器绑定表(SBT)是一段精心排布的显存:每种命中组合对应一条定长记录,前段放着着色器标识符,后段放着根参数。射线命中后,硬件不查任何"虚函数表",直接拿实例 ID、几何 ID、射线类型拼出字节偏移,一次寻址取出记录——函数分发被降维成内存寻址。这解释了两件工程事实:其一,SBT 的排布质量直接影响性能(散乱排布破坏缓存命中),引擎都要做 SBT 的分块与打包优化;其二,动态场景频繁更新材质映射时,SBT 的重建成本要摊进帧预算——它是第 7 章账本里容易被漏记的一项。
加速结构的接口语义:4.3 的翻译对照
把 4.3 的维护策略对回接口标志位,对照关系严丝合缝:构建时申请"允许更新"标志(各家方言里都是同一个意思),之后每帧走"更新"模式即为 refit,走"重建"模式即为 rebuild——分层 TLAS 与 BLAS 也是接口的原生概念,构建、反序列化、拷贝同步各有显式指令。三处接口层的工程暗礁值得点名。其一,对齐与布局:加速结构显存有严格的对齐要求,布局紧凑度影响硬件吞吐——别把 4.2 的内存布局功课在接口层丢掉。其二,同步语义:构建或更新完成后必须显式提交拷贝同步,否则当帧查询可能读到陈旧结构——这是典型的异步资源陷阱,报错还往往滞后一帧,极难排查。其三,递归深度上限:管线式着色器必须声明最大递归深度,驱动按它预分配栈空间;上限拉高寄存器压力骤增、占用骤降。现代实践是把递归改写成循环——第 6 章的迭代式路径追踪在这里拿到第二个理由:不只是性能,是接口根本不给你优雅递归的空间。
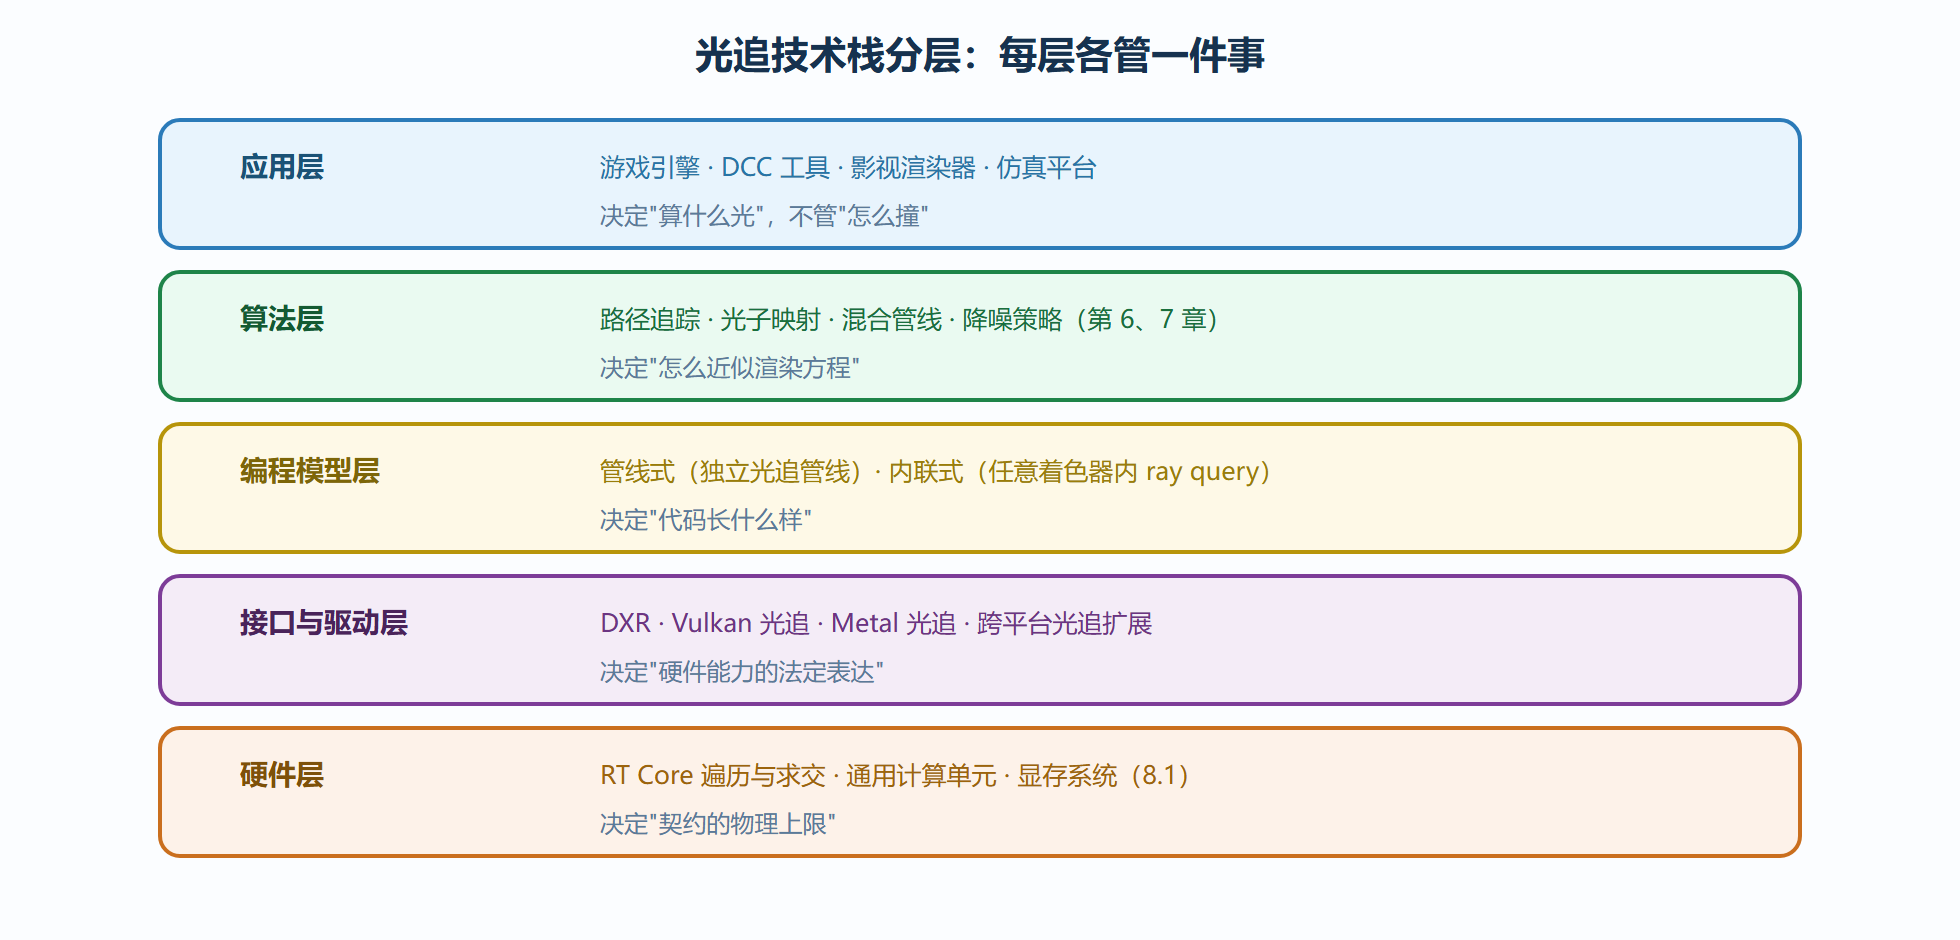
图:完整技术栈的分层地图
软件库生态:每家卡在哪一层
接口之下是芯片,接口之上各层都有专职软件库占位,按层点名。求交内核层(CPU 侧):Embree 一族提供高度优化的 CPU BVH 构建与遍历,是离线渲染器(如开源的 Cycles 架构与多数工作室自研渲染器)的主力内核——多线程、SIMD、缓存友好的节点布局,本册第 3、4 章的手推内容在它们里面都是工业级实现。驱动内框架层(GPU 侧):OptiX 一类框架把"管线管理、加速结构、按需回扣"封装成更友好的抽象,驱动深度参与调度,科研与专业可视化领域常年首选;代价是与具体厂商绑定。渲染器与引擎层:商业离线渲染器把路径追踪加各种专用求解器(第 6 章的族谱排班)打包成生产管线;游戏引擎则把第 7 章的混合管线做成可开关的效果系统——两家都在"算法层"竞争,共享底下的接口与硬件。科学计算侧:光传输内核被复用于声线、无线电、激光雷达仿真——同一套求交内核,换一套介质与响应模型就是另一个学科的工具,这条线索第 10 章会展开。
选型流程也顺着这张图走:先定部署形态(实时还是离线、目标硬件范围),定接口层(跨厂商用 Vulkan 方言,限定平台选原生接口),再选库与渲染器(离线 CPU 集群看求交内核系,实时引擎看混合管线成熟度),最后才轮到算法调优。顺序颠倒的典型症状是"先爱上某个库,项目做完才发现硬件覆盖不达标"。
跨接口移植的对齐清单
真实项目常有"同一渲染器要跑在两家接口上"的需求,移植时最容易翻车的不是大架构而是暗契约,七件事要对齐:加速结构构建标志位的语义(允许更新与允许紧凑的组合,各家等价写法不同);底层与顶层结构构建的显式同步点(一家的隐式同步是另一家的手动栅栏);着色器绑定表的对齐要求与步长(字节对齐不同会直接踩内存);递归深度与内联调用的嵌套上限;世界空间与对象空间的矩阵约定(行主序与列主序、左手与右手系);实例掩码与可见性遮罩的语义粒度;调试剖面的计数器口径(跨平台性能对比必须先换算口径)。清单不长,但每一条都值得在移植第一天就用最小用例验证——任何一条错位,都会以"画面对但性能差三倍"或"偶尔花屏"这种最难排查的形态出现。
这份清单还有个副作用:整理它的过程会逼你把接口差异写成表,而这张表日后就是团队的技术选型材料。移植成本是选型时最常被漏算的一项——清单建立得越早,选型做得越诚实。
本节要点回顾
- 两种编程模型:管线式强表达高门槛,内联式低门槛细粒度;混合管线的时代属于内联式。
- SBT 的本质是寻址替代分发:排布质量影响性能,更新成本要进帧预算。
- 接口标志位是 4.3 的语法化:允许更新即 refit,重建即 rebuild;同步与对齐是两大工程暗礁。
- 递归上限逼出迭代写法:第 6 章的循环式主循环在接口层拿到第二个存在理由。
- 生态按层卡位:求交内核、驱动内框架、渲染器与引擎各管一段;选型自顶向下,别倒着来。
硬件与接口齐了,单帧的管线还不足以叫"工程"。下一章上升到最后一个维度:软件架构、并行调度与性能剖析——把所有零件拧成一个可维护、可扩展、可排障的系统。