9.2 并行调度与性能剖析:让系统跑满
9.2 并行调度与性能剖析:让系统跑满
架构给了骨架,本节解决心跳问题:光追负载天生并行(射线之间几乎独立),却也是出名的"并行不友好"负载——朴素的按像素切分在真实场景里常常只榨出硬件一半的吞吐。本节先诊断三重失灵的病因,再给两种主流药方(波前与任务图),最后上剖析方法论:把"感觉慢"变成"第几层、哪类查询、哪个计数器超标",并以一次完整排障复盘收尾(本节吸收原 9.3 性能剖析与瓶颈内容)。
三重失灵:为什么按像素切分不管用
失灵一:负载撕裂。同一帧内,天空区域的像素一条主光线就收工,镜面交界处的像素却要几百次弹跳。并行单元的调度粒度是成组的(CPU 的向量通道、GPU 的线程束),组内必须同步推进——最慢的那个像素拖住全组,吞吐被最差路径绑架。实测里,纯像素级并行的线程束有效利用率在含镜面场景可以跌到四成以下:近六成算力在陪跑。
失灵二:相干性瓦解。主光线阶段相邻像素方向相近、访存趋同;一进递归立刻散伙——反射线朝镜面对称方向飞,阴影线直奔光源,遮挡采样随机四散,束内线程的 BVH 节点访问序列毫无交集,缓存命中率断崖式下滑。第 8 章从硬件角度讲过这条油门,这里是它在软件调度上的投影:聚批的时机决定缓存命运。
失灵三:内存墙加剧。随机访存无法聚合成长请求,带宽有效利用率被压到峰值的一小半;遍历的指针跳转还专门打击转址缓存。三条失灵互相放大:负载撕裂让组内等待变长,相干性瓦解让每次等待的访存更慢,内存墙让等待本身更贵。
两副药方:波前与任务图
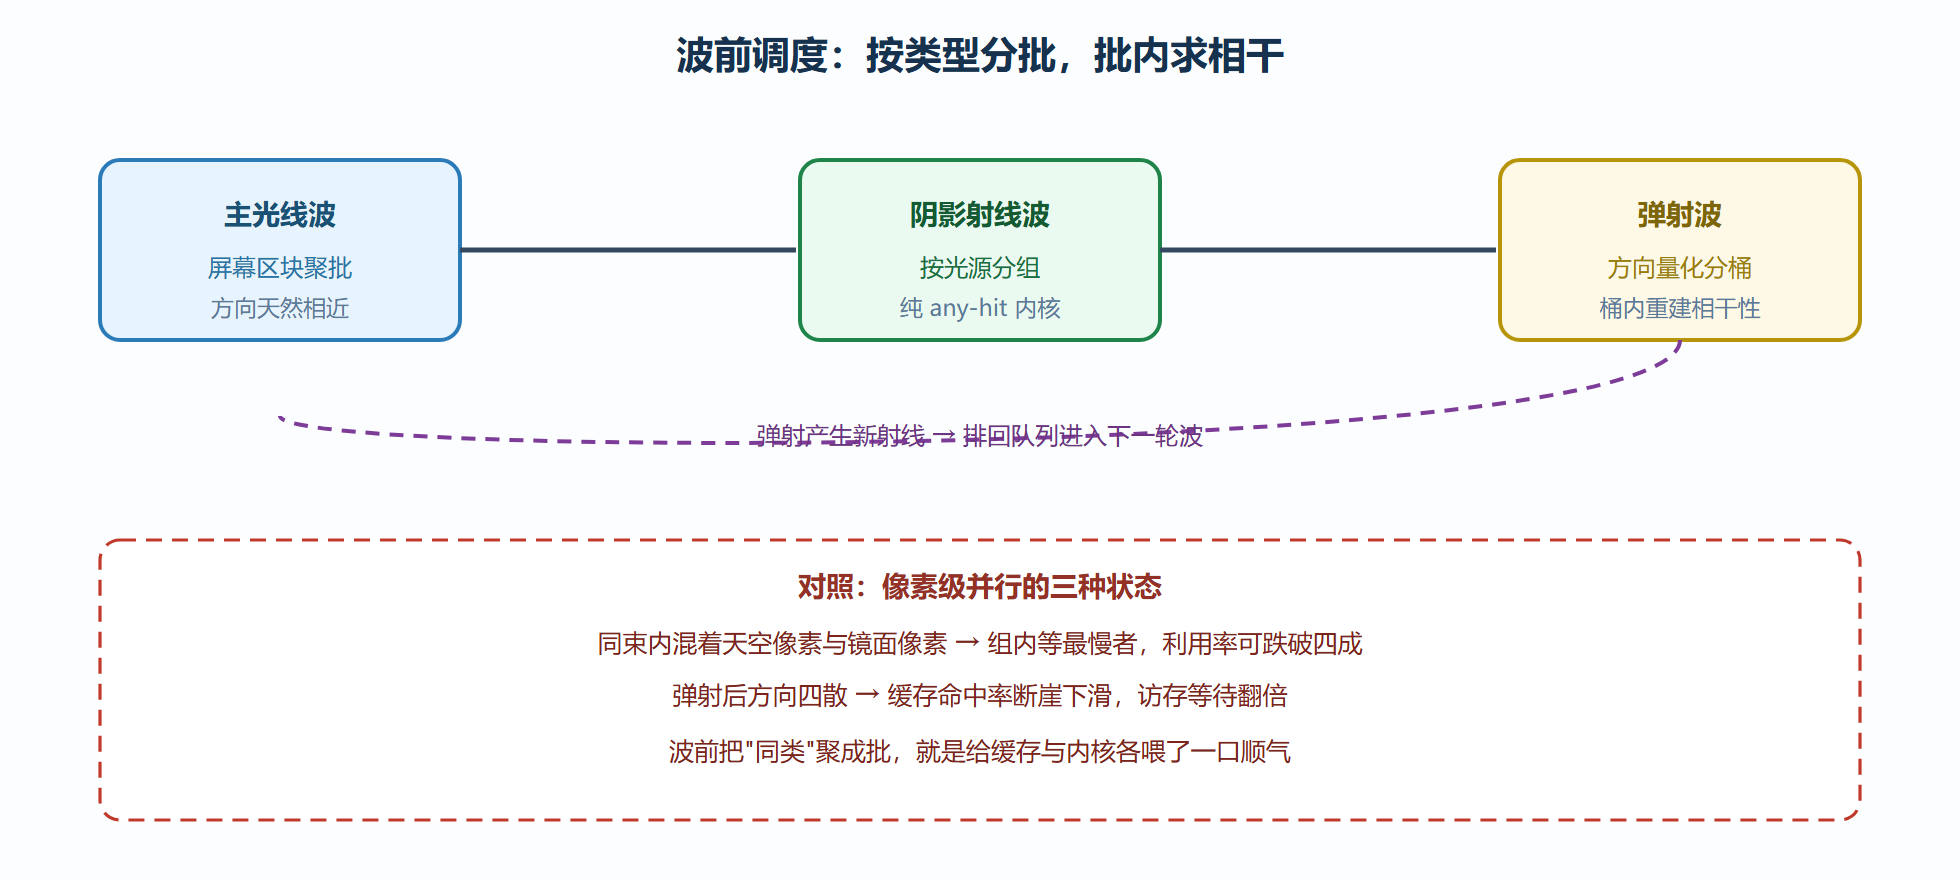
波前(wavefront)模型的核心动作是"按类型分批、批内求相干"。把一帧的射线按生成阶段切波:主光线波、阴影波、反射波……每个波内部再做相干性排序(按屏幕区块聚类、按方向量化分桶),然后整批送进对应的处理内核。收益立竿见影:阴影波内部全是 any-hit 查询,内核可以按 any-hit 的最优路径编译;反射波内部方向相近,缓存命中率高。代价是多遍数据往返——每类射线要在全局显存里排队中转,带宽开销与调度收益要对账。任务图(task graph)模型则把整个渲染过程建成依赖图:节点是"一批同类任务"(生成主光线、求交、材质评估、直接光采样……),边是依赖,调度器按拓扑序推平,哪里有资源哪里开工。它的优势是灵活与自适应——动态负载下自动填满空闲单元;代价是实现复杂、调试困难,任务粒度切错会退化成"更慢的波前"。
波前式伪码(三波结构): wave1 = gen_primary_rays(pixels) # 主光线波,屏幕聚批 hits = trace_all(wave1) # 批量求交 wave2 = gen_shadow_rays(hits) # 阴影波,按光源分组 occl = trace_anyhit(wave2) wave3 = gen_bounce_rays(hits, bsdf) # 弹射波,方向量化分桶 ...循环直至波空 任务图式伪码(依赖驱动): graph = {生成→求交→命中处理→[直接光,弹射生成→求交→...] } while graph.not_empty(): task = scheduler.pop_ready() # 依赖满足即可执行 execute(task) # 完成后解锁后继节点
选型判断有两条经验律。其一,平台决定下限:GPU 上波前式(或其变体)几乎是必选——线程束的同步粒度天然匹配"批处理";CPU 上任务图(常配工作窃取队列)更顺手,线程数少、每线程有独立队列,窃取就能填平负载坑。其二,负载决定复杂度:效果以阴影反射为主(波型固定)用波前三板斧就够;路径追踪式深度动态的负载才值得上任务图。两者也不互斥——成熟系统常见"外层任务图编排查批、内层波前处理"的混合结构。
图:波前模型的三波流水与相干性分桶
剖析方法论:把"感觉慢"翻译成计数器
性能工作的一半是测量哲学:先假设自己是错的,再用计数器找证据。渲染器要在架构期就埋好三类探针。第一类,工作量计数器:每帧发射的射线数按类型分账、遍历访问的节点数、每射线平均三角形测试数——它们回答"活多不多"。第二类,分层计时:生成、遍历、材质、采样、输出各层耗时单独打点——它们回答"活卡在哪层"。第三类,可视化诊断图:按像素记录采样数、路径深度、方差,输出成热图——画面上的噪声分布与负载分布直接可见,"哪个区域贵、为什么贵"一眼定位。
剖析的流程纪律同样重要:一次只改一个变量、每轮测量固定场景与种子(9.1 的可复现随机流在此兑现)、冷启动与热稳定分开测。最后按收益排序动刀——遍历带宽类的修复(节点压缩、布局重排)通常先于算法类修复兑现,因为它们不动数学、风险最低。
实验台:一张慢图的完整排障复盘
完整案例。背景:某室内场景静帧渲染,原估两小时,实测七小时,画面无可辨差异。操作按流程走。第一步分层计时:遍历层占四成六、材质层占三成八——两处异常,正常比例遍历应过半、材质约两成。第二步工作量计数器:每射线平均三角形测试数正常,但材质求值次数是命中次数的三倍——异常证据。第三步热图定位:材质开销集中在两面大理石墙,对应的恰是新加的"程序化大理石"材质(5.3 的分形噪声配方)。第四步查因:噪声函数在每次 BSDF 求值时现场重算六层倍频,而路径追踪里同一命中点的材质会被求值多次(直接光、间接光、采样各一次)。修复:命中点首次求值后把结果缓存在内存池里供同一路径复用,噪声倍频从六层降到四层(视觉无可辨差异)。结果:总耗时七小时降到两小时四十分钟,材质层占比回落到一成九。解读:这次排障没有动一行算法,收益全部来自"测量定位重复劳动"——性能问题的大多数不是算法不够聪明,而是同一份工作被悄悄做了多遍。变式:若热图显示的是遍历层热点(比如某个走廊区域节点访问数畸高),处置方向就换成 4.2 的树质量指标复查——同一套流程,处方随计数器而变。
三类探针的健康读数
探针埋好只是开始,读数要有参照系,给一份经验参考。每射线平均访问节点数:健康区间约为树深的 1 到 3 倍,突然翻倍多半是树质量滑坡或实例堆积。遍历层耗时占比:静态场景六到七成、动态场景过半,明显偏低反而要查材质是否失控——像实验台那种三倍求值就是典型案例。缓存命中率:遍历节点与三角形缓冲要分开看,低于平台经验的七成时,布局重排的收益通常远超算法优化。时序复用有效样本数(衔接第 7 章):稳态低于 8 说明历史验证过严或运动矢量失真。读数对照不是普适常数,平台换代要重新标定——但"判断异常之前先知道正常"这个动作本身,就是剖析与瞎调的分界线。
本节要点回顾
- 三重失灵:负载撕裂绑架组内吞吐、相干性瓦解打崩缓存、内存墙抬高每次等待——像素级切分三样全占。
- 波前模型按类型分批、批内相干排序,GPU 上的事实标准;任务图按依赖编排、自适应填缝,CPU 侧更顺手;混合结构是成熟形态。
- 三类探针要在架构期预埋:工作量计数器、分层计时、按像素热图——剖析的是证据,不是感觉。
- 流程纪律:单变量改动、固定场景种子、冷热分开、按收益排序动刀。
- 性能问题的多数形态是"重复劳动"与"布局违和",算法层面的大手术要放在最后。
工程闭环到此完整:架构、调度、剖析三位一体。最后一章走出实验室,看看这一切在影视、游戏、设计与科学的世界里如何真正落地。