4.1 虚拟内存与地址翻译的硬件代价
4.1 虚拟内存与地址翻译的硬件代价
本节摘要:虚拟内存让每个程序以为自己独占一片连续地址空间,代价是每次访存前都要完成一次从虚拟地址到物理地址的翻译——页表遍历潜在地要把一次访存放大成多次。本节讲清页表的结构、旁路缓冲如何把翻译摊薄到近似免费、翻译与缓存如何配合,以及设计者手里缩小翻译代价的几张牌。
为什么处理器再快,程序也常常在等内存
主存的速度几十年里始终远落后于处理器,一次主存访问的时间够流水线执行上百条指令。更糟的是,在虚拟内存体系下,处理器拿到虚拟地址后连这次慢速访问都还不能开始——必须先把虚拟地址翻译成物理地址。如果每次翻译都要去内存里查页表,等于慢上加慢。整章的叙事就从这个双重困境开始:既要缩短"数据离处理器多远"(4.2 的缓存),也要缩短"地址翻译本身多贵"(本节)。
先弄清翻译机制在买什么。隔离:两个进程的地址空间互不可见,野指针写不穿别人家的墙。灵活:物理内存可以碎片化分布,虚拟地址照样连续;页面可以换出到磁盘,物理内存可以超卖。保护:每段页表项自带权限位,只读段写一下就陷入异常。这三样是现代操作系统运转的前提,代价是每次访存前的翻译手续。
页表:翻译规则的登记簿
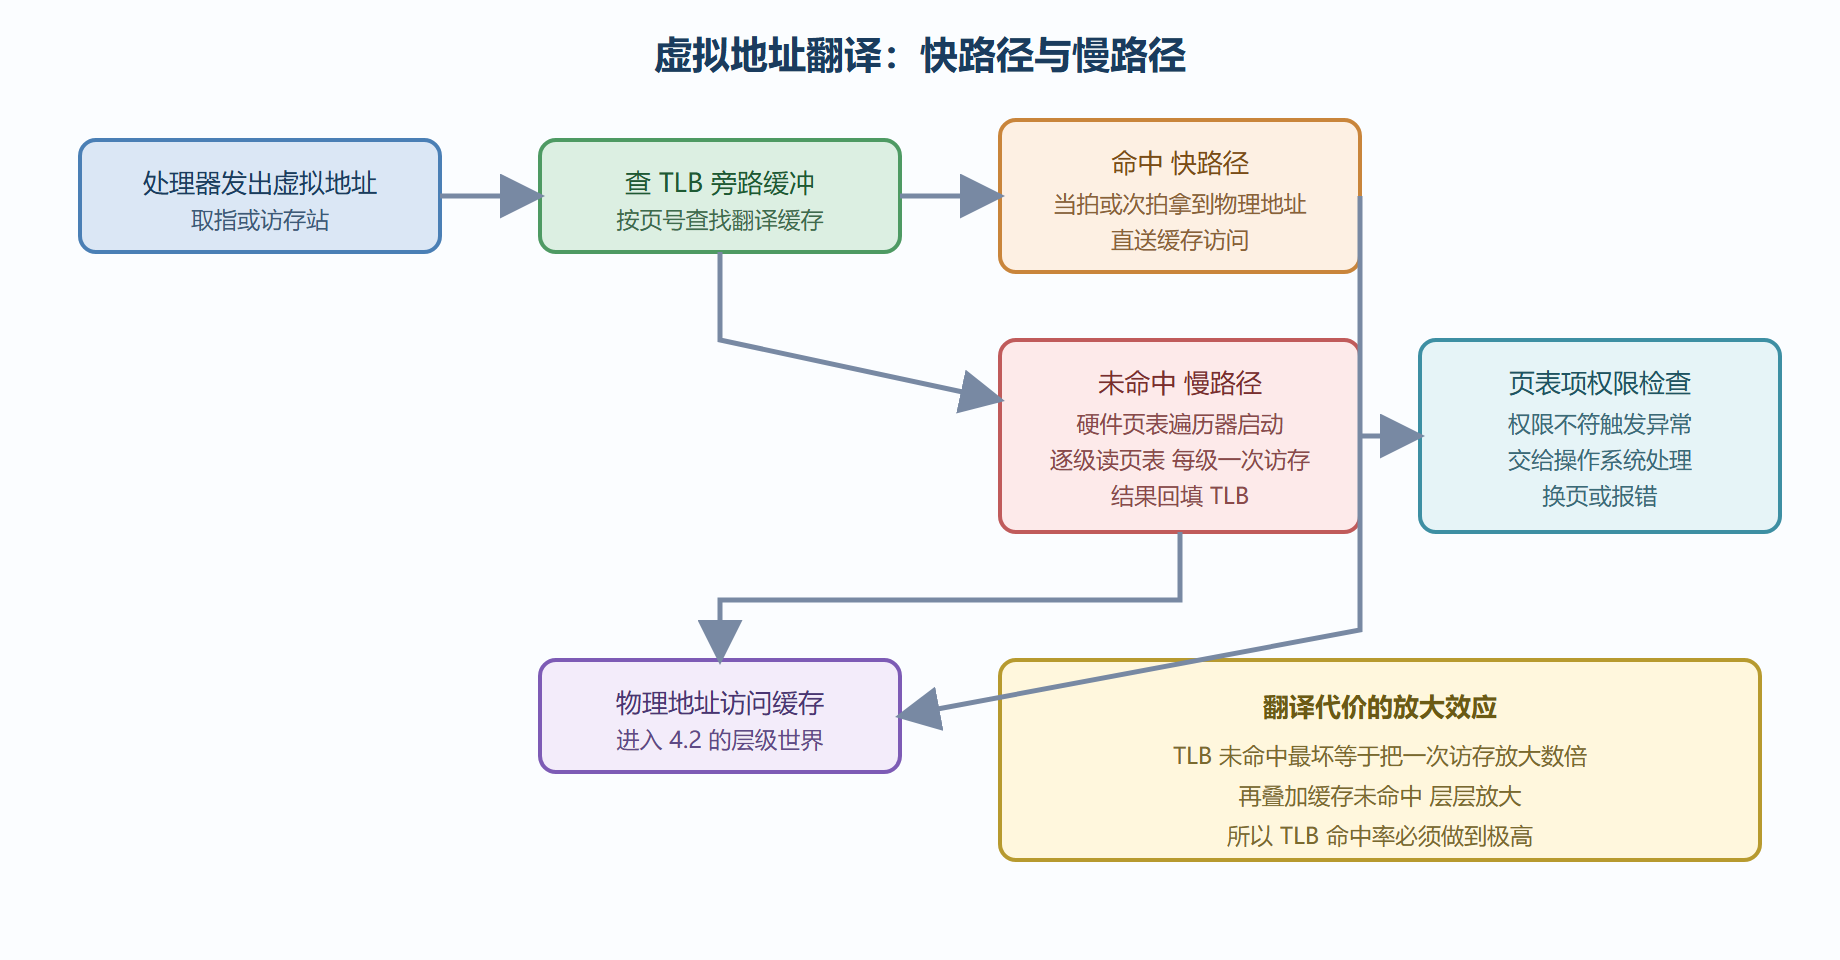
RISC-V 的分页方案采用多级页表。以常见的三十九位虚拟地址方案为例:虚拟地址被切成若干段,高位段逐级索引页表,每一级查出一个下一级页表的物理地址,最后一级页表项里躺着真正的物理页帧号,拼上页内偏移得到物理地址。多级结构的好处是页表本身不必连续存放、未使用的区域不必分配页表页——用稀疏存储换来了大地址空间的可行性;代价是最坏情况要串行访问多次内存才能完成一次翻译。
一次访存的完整翻译路径
旁路缓冲:把翻译摊薄到近似免费
旁路缓冲(翻译后备缓冲,业内更常叫它的英文缩写)是专门缓存"页号到页帧号"翻译结果的小存储。命中时,翻译在流水线里几乎不占时间;未命中才启动慢路径。关键数字感:它的条目数通常只有几十到几百条,但每条覆盖一整页(常见页大小按方案从四千字节到更大不等)——几十条翻译就能覆盖相当可观的工作集。它是全芯片面积收益比最高的部件之一,一小块存储换掉整条慢路径。
设计者手里关于它的几张牌,逐一报价:
容量与相联度。条目越多、相联度越高,命中率越高;但它是按内容查找的存储,比较器数量随相联度线性涨、访问延迟随容量涨。常见做法是拆成指令与数据两个独立小缓冲(访问模式不同,互不挤占),再做共享的下级缓冲兜底。
页大小。页越大,单条翻译覆盖的地址范围越大,同样的条目数覆盖更多内存——大页是提升覆盖率的廉价手段。代价是内存碎片化风险(分配粒度变粗)与换页单位变大。操作系统按负载混用多种页大小,是软硬协同的典型好案例。
预取与替换。页表遍历器完成一次慢路径后,可以顺手把相邻页的翻译一起 prefetch 进来(空间局部性);替换策略则偏向保留高频页。这些都是低成本补丁,收益依赖负载特征。
翻译与缓存的配合:一个精妙的合作
一级数据缓存有个时序难题:翻译(查旁路缓冲)和缓存查找(查数据)如果串行做,两段延迟叠加在访存关键路径上。解法是用虚拟索引、物理标号的缓存组织:缓存的索引位取自页内偏移(虚拟与物理地址的页内偏移相同),缓存查找与地址翻译并行进行;等翻译结果到位时,缓存行也已经读出,用物理页帧号比对标签即可确认命中。这个设计让两个本该串行的步骤免费并行——代价是缓存容量受页内偏移位数的间接约束。微架构里这类"用对齐换并行"的手法反复出现,值得专门记一笔。
⚠️ 常见坑:把翻译当成免费。性能剖析里如果看到大量页表遍历类事件,多半是工作集的页面分布过于稀疏,或旁路缓冲容量与负载不匹配——优化方向在数据布局与页大小配置,而不是换更快的内存。
切换地址空间:翻译状态的大扫除
进程切换时,新进程有一套自己的页表,旧进程在旁路缓冲里的翻译全部作废——最简单的做法是整体冲刷,代价是切换后的首批访存全部走慢路径。优化手段是地址空间标识:每条翻译带着进程编号,切换时旧条目不删、查询时按当前进程的编号过滤——两个进程交替跑时各自的翻译都还在缓存里,切换开销近乎归零。这个细节对调度频繁的系统(微内核、容器密度高的服务器)影响可观,是"软件行为影响硬件设计参数"的又一事例:进程切换频率不同,旁路缓冲的组织策略就该不同。
巨页的工程现场。大内存工作集的程序(数据库、大模型推理的权重存取)用巨页能把翻译覆盖率拉上一个台阶——同样条目数覆盖的内存大几个数量级。操作系统的透明巨页机制自动把连续区域合并成大页,代价是后台整理线程的处理器占用与偶尔的"先拆后合"抖动。运维视角的取舍:内存碎片严重的长跑进程受益明显,短命进程收益有限——先量碎片率,再开开关。
常见问题快答
问:旁路缓冲未命中率和缓存未命中率,哪个更伤? 同为未命中,前者通常更伤——一次页表遍历是串行多次访存,且这些访存自己也可能未命中缓存(页表数据不在缓存里)。好消息是它的绝对数量小得多。剖析时两个计数都要看,别让后者掩盖前者。
问:为什么不让操作系统直接管理翻译缓存? 慢。每次缺页后的填表若都要陷入内核显式操作,中断路径会拖长。硬件自动遍历加自动回填,内核只在真正缺页(页表里就没有映射)时出场——软硬件分工的原则又一次出现:高频自动化、低频软件兜底。
设计师视角小结:翻译机制的三个可调参数——旁路缓冲的容量与组织、页大小策略、遍历器的并发度——构成一张小价目表。容量加条目、页加大、遍历器并行发起多级访问,都是花钱买命中;预算紧的小核则一切从简,用最浅的表加最小缓冲起步,靠剖析数据决定要不要升级。先量再买,在内存子系统的每一层都成立。
本节要点回顾
- 虚拟内存买三样:隔离、灵活、保护;代价是每次访存前的翻译手续;
- 多级页表用稀疏存储支撑大地址空间,最坏情况的遍历是串行多次访存;
- 旁路缓冲是面积收益比之王:几十条翻译覆盖可观工作集,拆指令数据两份再加下级兜底是标准动作;
- 大页提升覆盖率但有碎片代价,混用页大小是软硬协同的常规解;
- 虚拟索引物理标号:让翻译与缓存查找并行,用对齐结构换关键路径。
地址翻好了,接下来看数据到底放在离处理器多近的地方——缓存层级登场。