3.1 五级流水线逐站拆解
3.1 五级流水线逐站拆解:取指到写回
本节摘要:五级流水线把一条指令的旅程切成取指、译码、执行、访存、写回五站,多条指令同时在不同站里推进,稳态下每周期有一条指令完成。本节逐站讲清职责与硬件组成,解释站间寄存器作为"节拍器"的作用、吞吐与延迟的本质区别,以及为什么设计者的核心任务是配平各站延迟而不是单纯加深流水线。
把自己想象成一条指令
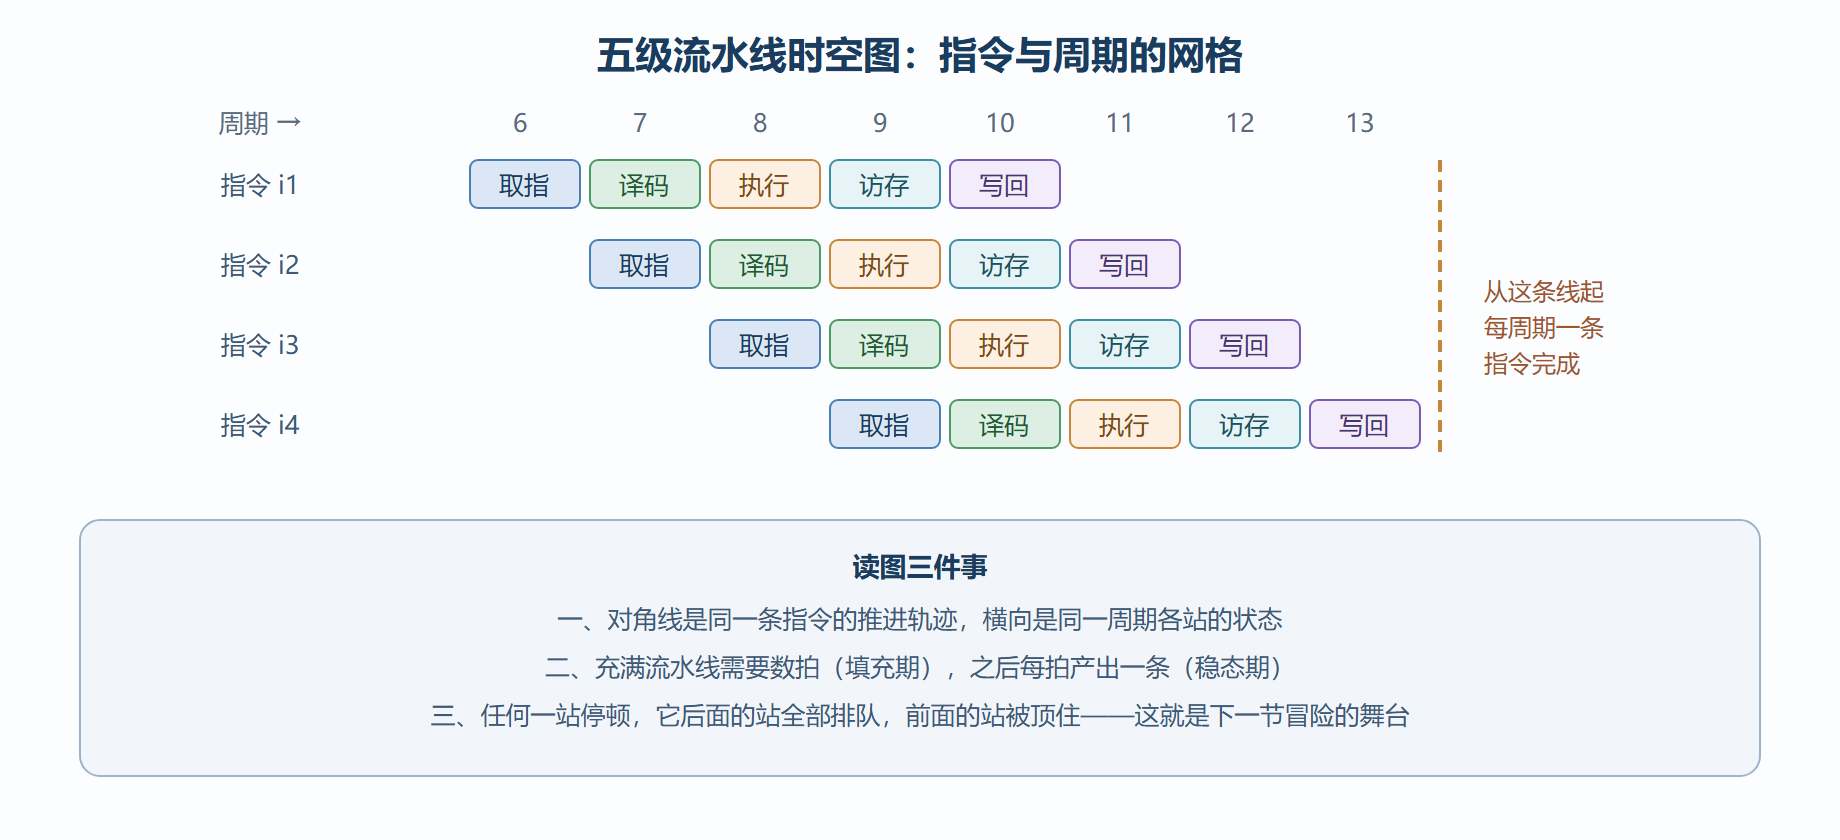
你是一条加法指令,此刻正躺在指令存储器里。时钟一响,取指站把你捞出来,连同你的四位同伴——你们五条指令将在接下来几个周期里排成一列纵队,各自间隔一个周期进入流水线。第一拍你被取出,第二拍译码站认出你是加法并读出两个源寄存器号,第三拍执行站的加法器算出结果,第四拍访存站对你毫无用处、直接放行,第五拍写回站把结果写回寄存器堆。单看你这条指令,耗时没有变短;变的是整条队列的出队速度——从第六拍起,每个周期都有一条指令走完全程。这就是流水线的全部秘密:它不加速个体,它加速队伍。
流水线时空图
逐站的职责与硬件
取指站。用程序计数器的值去指令存储器取一条指令,同时算出下一个计数器值——顺序执行就是加四(定长指令的一个字宽),遇到跳转则等执行站回头纠正。RISC-V 的定长编码在这一站兑现红利:取指宽度按字对齐切分即可,不需要探测指令边界。取指站的时序压力来自指令存储器访问延迟,实际核几乎都要靠取指缓存来喂饱它,那是第四章的话题。
译码站。识别指令类型、读寄存器堆、生成控制信号。第二章提过,各指令格式的寄存器字段位置高度对齐,所以读操作数不必等完整译码结束,可以并行进行——译码站因此能切得很薄。恒零寄存器在这里兑现:读它直接返回零,不需要特殊处理逻辑。
执行站。算术逻辑单元真正干活的地方:加减、比较、地址计算、分支条件判定都发生在这里。执行站通常是组合逻辑最深的一站,是最容易卡时序收敛的部位——第八章的排错复盘里,关键路径十有八九指向执行站或访存站。设计师的常见手段是把执行站一分为二(比如独立的加法与移位通路)或加深流水,但每加一级,冒险处理的复杂度就涨一截。
访存站。只有装载与存储两类指令在这一站干活(装入存储型架构的红利再次兑现:其他指令空手通过)。访存站面对的是缓存层级——命中当拍通过,失速就要等几十上百拍。它也是总线接口的入口,多核环境下还要过一致性协议的关卡。
写回站。把结果写回寄存器堆。一拍写回、下拍可读,构成了下一节数据冒险分析的基本节奏。
站间寄存器:流水线的节拍器
每个周期结束时,每站把自己的全部中间状态——指令本身、已读出的操作数、控制信号、结果——锁存进站与站之间的寄存器组。这些寄存器是流水线的真正骨架:它们把"一整条长组合逻辑"切成"五段短逻辑",让时钟可以显著提高。代价也在这里:每级寄存器有本身的建立时间开销,站切得越多,这个固定开销占比越大——这正是"流水线不是越深越好"的算术根源。
设计者的核心任务是配平:理想流水线每一站的延迟相等,最慢的站决定全局节拍。如果执行站延迟是其他站的两倍,整个流水线就被迫按两倍周期运行,其他四站白白闲置一半时间。配平的手段包括搬逻辑(把译码站的一部分活挪给取指站预先做)、拆长站(执行站一分为二)、合短站(小核常见把访存与写回合并)。
💡 关键直觉:流水线设计的三个动词——切(分段)、配(平衡)、锁(站间寄存)。所有后续复杂机制,都是在这三个动词留下的缝隙里打补丁。
吞吐、延迟与一个常见误读
流水线提高的是吞吐(单位时间完成的指令数),单条指令的延迟(从进入到离开的总时间)从不减少,反而因站间寄存器开销略微增加。营销材料爱把主频当性能,但真实性能等于主频乘以每周期指令数再除以指令总数需求——加深流水线抬高主频的同时,通常因冒险与预测失败的惩罚加重而压低每周期指令数。这场"主频对每周期指令数"的谈判,在 3.3 和 3.4 会反复上桌,第八章对比三代开源核时你会看到三种不同的成交价。
站深与主频的粗算
把"切、配、锁"量化一下。假设一段逻辑总延迟为T,寄存器开销为常数c。切成 n 站后,周期约为 T 除以 n 加 c,主频是它的倒数。n 增大,T 除以 n 递减但 c 占比上升——当 T 除以 n 逼近 c 时,再切站几乎不再提升主频,反而每站的手续(冒险检测、前递选择器、冲刷逻辑)开始指数式膨胀。这就是深流水线的收益递减点,也是真实设计里五到八级成为甜点区、十几级只在特定目标下才划算的算术根源。教学核选五级不是偷懒,是这个粗算的自然结论。
从这个粗算还能读出:工艺越好(门更快、c 相对变小),可切的站数越多——同一份架构在不同工艺代际上的最优实现形态不同,这正呼应了第一章"合约不绑微架构"的价值:规范中立,每一代工艺重新谈判最优站数。
常见问题快答
问:五级流水线的每周期指令数真的能到一吗? 稳态、无冒险、命中缓存时能;真实代码里有冒险与未命中,通常落在零点几区间。这正是后续两节(治冒险)与第四章(治未命中)存在的意义——五级是骨架,后两章的机制才是让它跑满的肌肉。
问:为什么很多教学实现把访存和写回合成一站? 面积与复杂度考量——合并后少一级寄存器与一整套站间逻辑,代价是装载结果晚一拍可用、前递网络稍复杂。小面积教学核与微控制器常用这种"四站半"形态,工业核很少这样做。规模不同,甜点不同。
五级的现代变体一眼。真实产品里"五级"很少是纯正的五级:有把译码拆成"预译码加读寄存器"两拍的,有给执行加第二级凑深流水的,有把访存拆"地址发出加数据回来"的。拆法不同,名字里的级数就不同——比较两颗核的"级数"时先对齐口径:数站间寄存器的层数,别数宣传页的名词。这也是读架构文档的基本功:术语是别人的,寄存器层数是自己的。
本节要点回顾
- 流水线加速队伍不加速个体:吞吐上升、单条延迟基本不变;
- 五站职责:取指喂指令、译码读操作数、执行算、访存管装载存储、写回收尾;
- 站间寄存器是节拍器:切短组合逻辑换高主频,但每级寄存器是固定开销;
- 配平重于加深:最慢的站决定全局节拍,设计动词是切、配、锁;
- 主频不等于性能:真实指标是主频与每周期指令数的乘积谈判。
流水线一转起来,麻烦立刻出现:后一条指令要用的数据,前一条还没写回。下一节处理这些冒险。