6.1 向量扩展的微架构设计
6.1 向量扩展的微架构设计
本节摘要:向量扩展是 RISC-V 处理数据级并行的主力扩展,它的核心设计是"寄存器组织与元素宽度在运行时可配置"——同一套向量寄存器组与多车道执行单元,既能按窄元素多路并行,也能按宽元素少路深算。本节从寄存器组的组织讲起,拆解车道化的执行单元、让指令序列流水起来的链接机制,以及三种访存形态的硬件代价,最后回到"要不要开这个扩展"的选型判断。
先看一张布局图:寄存器组怎么长
理解向量扩展,先看清它的地基——向量寄存器组。下图是核心组织:
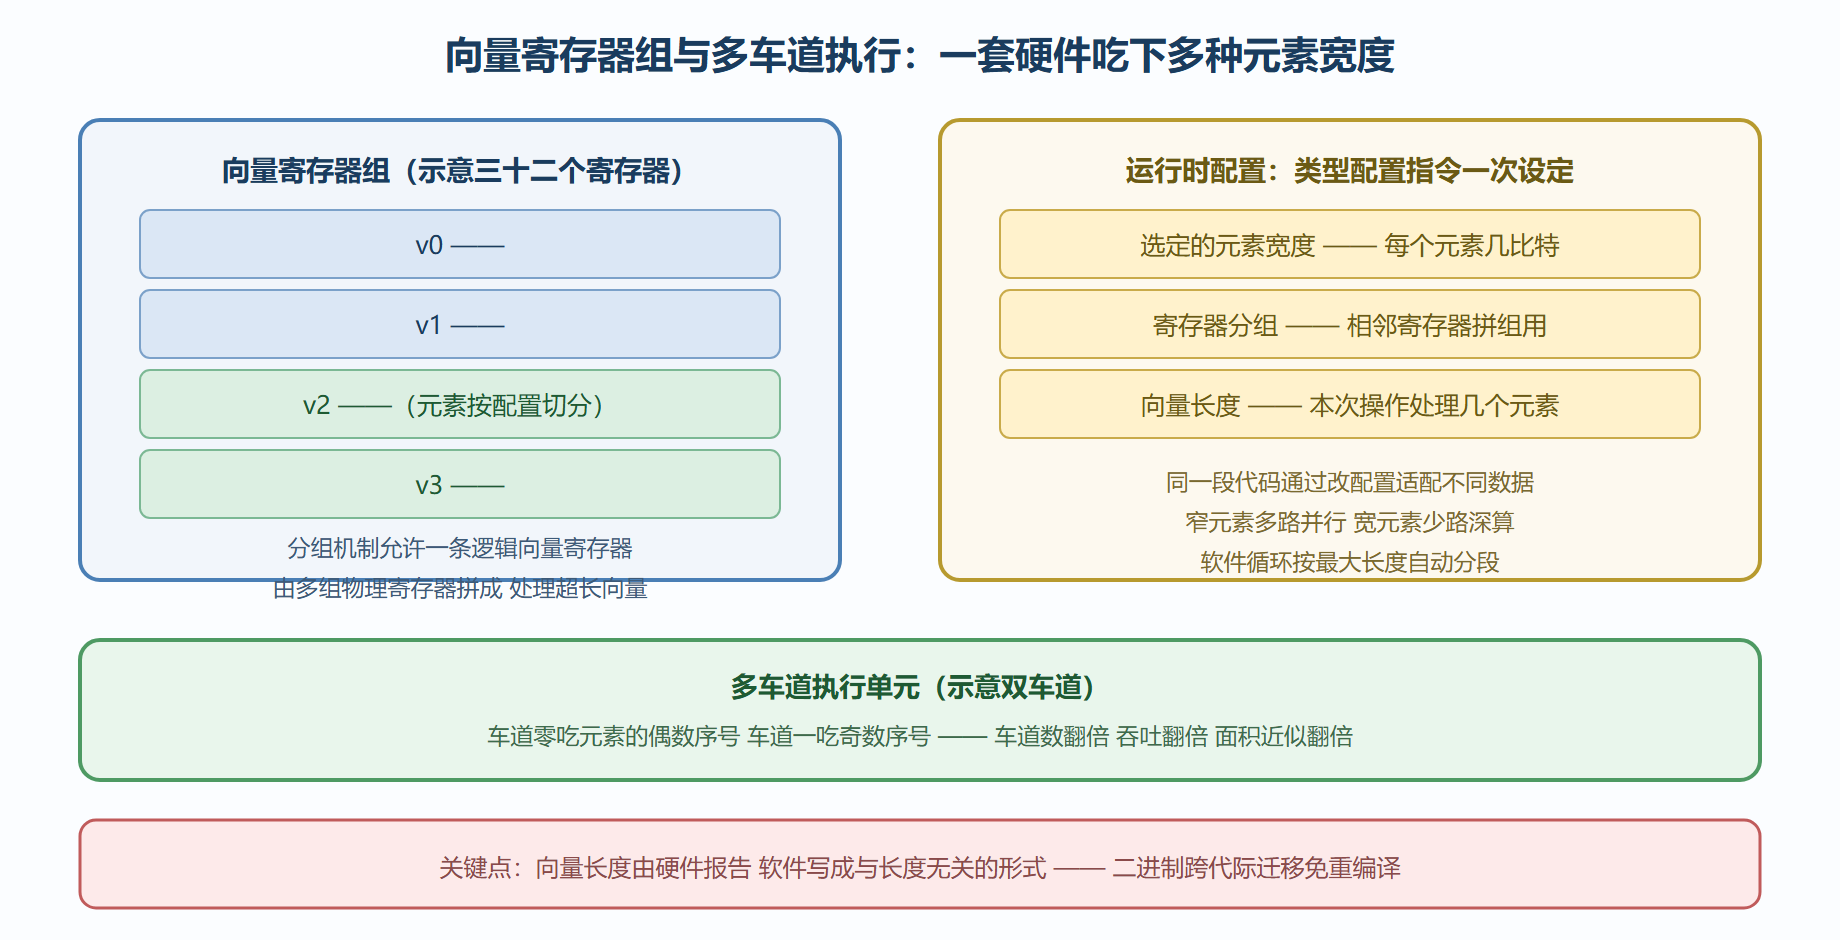
这张图里藏着向量扩展与老一代固定宽度方案的根本分歧。固定宽度方案把元素宽度烧死在指令编码里——指令集升级一次宽度,软件全部重编;向量扩展把宽度做成运行时配置,一段与长度无关的循环代码,在窄车道的边缘芯片上按窄配置跑,在宽车道的服务器芯片上按宽配置跑,同一份二进制自动吃满各自的并行度。这是"合约对实现中立"哲学在数据并行领域的又一次胜利。
车道与链接:让向量指令流水起来
车道是执行侧的并行单位:双车道单元每周期处理两个元素,四车道四个。车道化的代价线性——面积、功耗近似按车道数翻倍,收益也近似线性——直到访存带宽跟不上。所以向量核的设计谈判其实是"车道数对访存带宽"的谈判:算力堆上去,数据喂不饱,车道空转白付电费。
链接是向量指令间的流水衔接:当后一条向量指令的源正好是前一条的目的,且前一条的车道已产出首批结果时,后一条不必等前一条全部完成即可开跑——结果像流水线一样从一条指令"链"进下一条。链接让一段乘加序列的实际吞吐接近背靠背,代价是执行单元间要架旁路网络,控制复杂度明显上升。开源向量核的实现里,链接支持的深浅是拉开档次的常见分水岭。
三种访存形态的账单
向量访存比标量访存多出两种形态,各自的硬件代价差异很大:
| 形态 | 地址模式 | 硬件代价 | 典型负载 |
|---|---|---|---|
| 连续访存 | 逐元素顺序排布 | 最低,可整块搬运 | 数组逐元素运算 |
| 跨步访存 | 固定间隔取元素 | 地址生成器每车道一套 | 按行列扫描图像通道 |
| 索引访存 | 按索引向量 gather-scatter | 最高,逐元素独立事务 | 稀疏数据、指针数组 |
工程上的经验:索引访存每提高一档,缓存命中率与总线效率就掉一截。数据布局优化(把索引访存改造成连续访存)对向量性能的贡献,常常大于车道数升级——这与 4.4 伪共享的教训同源:硬件给了机制,性能的钥匙仍在数据布局手里。
选型判断:什么时候开这个扩展
回到第二章的账单框架。开向量扩展值得,当且仅当:负载里有可向量化的热点(剖析确认占比),数据能重排成连续或跨步形态(布局可改造),并且产品定位吃得下这块面积与功耗。反之,负载是标量控制流为主的场景,向量单元就是一块昂贵的闲置地产。第八章的开源核对比里,带向量与不带向量是区分"应用处理器"与"控制核"的显著分界线,选型时先看负载画像,再看那张账单。
💡 关键直觉:向量扩展买的是"每条指令搬动更多数据"的批发折扣,折扣兑现的前提是数据本来就排队整齐。先整队形,再上车队。
向量核与标量核的接口事务
向量单元不活在真空里,它与标量流水线的日常事务有三类,理解它们才算真正看懂一颗向量核。标量喂向量:循环的地址计算、长度控制、分支判断由标量侧完成,向量单元只接"算这一段"的指令——所以向量核的标量性能同样重要,喂不动就饿。尾部处理:元素总数不是车道数整数倍时,最后一段只有部分车道有活——硬件按向量长度寄存器自动屏蔽尾部空转,软件不必手写收尾分支,这是"与长度无关编程"体验的来源。异常与上下文:向量寄存器组很大,上下文切换的保存成本可观——操作系统按需保存(用了向量扩展的任务才存)、或用惰性保存(切换时只标记,真再用时才陷入补存)是常规优化。这三件事里任何一件做糟,向量扩展的纸面算力都会在真实负载里漏光。
验证要点一段话:向量单元的验证头号难点是配置组合爆炸——元素宽度、分组、向量长度、访存形态的合法组合成千上万,每种组合下的掩码行为、尾部处理、异常位置都要对。工业实现的通行做法是把配置参数当随机维度跑差异测试(7.3 的参考模型对照),再把关键配置(编译器最常生成的几种)做定向全覆盖。评估一颗带向量的核,问一句"向量测试覆盖了多少种配置组合",答案的专业度立刻见分晓。
常见问题快答
问:向量扩展和图形处理器是一回事吗? 不是。向量扩展是"一颗核里的宽执行单元",按向量指令办事;图形处理器是"一整颗众核芯片",靠海量线程掩盖延迟。前者适合规则的数据级并行,后者还能吃下不规则并行——但向量核的实现成本低一个数量级,嵌入式与中等吞吐场景是它的主场。
问:自动向量化靠谱吗? 对规整循环(连续访存、无分支、无别名歧义)相当可靠;指针别名是最大杀手——编译器不确定两个指针是否指向同一块数据,就不敢重排。约束指针别名、保持连续布局、循环内不调用外部函数,这三件事做齐,自动向量化的命中率会有质的改善。
从纸面到负载:向量收益的估算流程
把选型判断落成可操作的流程,四步走。第一步,剖析热点:确认目标代码里规整循环的占比——占比太小,向量化的天花板就低。第二步,查访存形态:热点循环的访问是连续、跨步还是索引?索引式负载要先把布局改造到跨步以内,否则向量单元喂不饱。第三步,估算车道数:按热点的计算访存比定车道——算得多吃得少,车道往多配;反之访存先行,车道多也是空转,先把带宽预算给足。第四步,原型验证:用开发板的向量支持(或仿真器的向量模型)跑改造前后的对照,实测收益对齐估算。四步走完,"要不要向量、要多少车道"就不再是拍脑袋,而是一份有数据的采购单。
本节要点回顾
- 运行时可配是灵魂:元素宽度、分组、向量长度一次配置,同一二进制适配不同硬件并行度;
- 车道数对访存带宽是主谈判:算力翻倍的前提是数据喂得饱;
- 链接让指令链流水:旁路网络换背靠背吞吐,实现深浅拉开档次;
- 三种访存形态三级账单:连续最廉、跨步中等、索引最贵,布局改造优先于车道升级;
- 选型看负载画像:没有可向量化热点,向量单元就是闲置地产。
下一节看另一种哲学的扩展实现——不为峰值,为确定性与能效。