1.1 起源与发展历程
1.1 起源与发展历程:一场被真实负载逼出来的改造
本节摘要:RocksDB 不是 LevelDB 的「增强版」这么轻巧——它是对一个理想模型在四个具体失灵点上的系统性重造。本节从 Facebook 2012 年的写放大困局讲起,复盘 LevelDB 单线程压缩、无统计钩子、全硬编码三大缺陷如何逼出一个工业级引擎,再沿三次跃迁梳理十余年的演进脉络,最后给出 LevelDB、RocksDB、WiredTiger、Badger 的对比表与选型判断。
从一张工单说起
先摆一个真实的排查场景。2012 年前后,Facebook 的社交图谱服务 TAO 跑在传统存储之上,用户关系数据量涨得比缓存扩容快。工程团队的工单里反复出现同一组症状:写入延迟在每天的峰值时段规律性恶化;SSD 的磨损消耗远超容量规划模型;从库同步延迟长期压不下去。逐层排查后,锅落在了底层键值引擎身上——当时他们试用的是 Google 2011 年开源的 LevelDB。
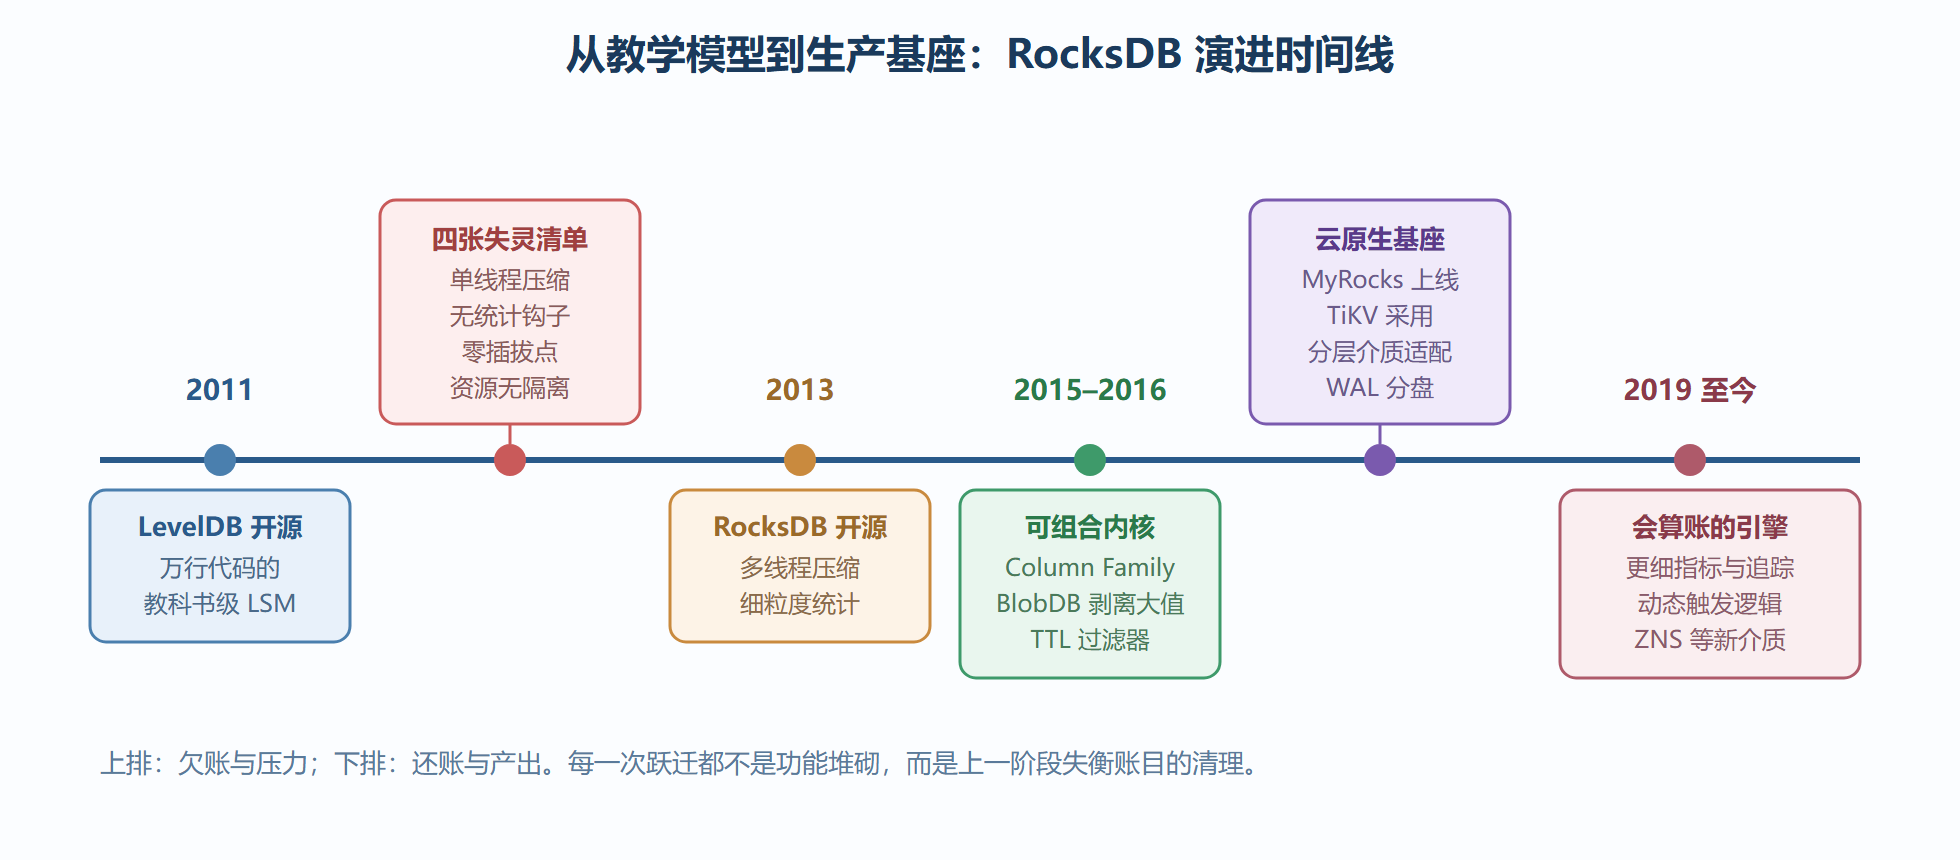
这个结果让很多人意外。LevelDB 出自 Jeff Dean 与 Sanjay Ghemawat 之手,核心实现只有一万行上下的 C++:内存里一个跳表 MemTable,磁盘上分层的 SST 文件,后台 Compaction 负责归并与淘汰。代码干净、语义完备、极易验证,是教科书级的 LSM 实现。问题在于,教科书不处理凌晨三点的告警。工程团队逐项核对后列出了一张失灵清单,这四条清单后来几乎逐字变成了 RocksDB 的需求文档:
- 单线程 Compaction。写入量一大,后台合并跟不上前台 flush,L0 文件堆积,写入被迫周期性停顿数十秒。停顿不可控、不可预估,这是写放大账目上最刺眼的一笔坏账。
- 没有细粒度统计。延迟毛刺出现时,无法回答「这一次读到底是卡在 L0 的文件数量上,还是卡在某一层的布隆过滤器误判上」。看不到账本,就没法对账。
- 可插拔点为零。压缩算法固定、内存分配器固定、文件系统接口固定。换一块不同特性的存储介质,等于 fork 一份代码自己养。
- 内存与资源无隔离。多个业务挤在一个实例里,一支突发写入流就能挤占掉另一个业务的缓存,互相拖累。
注意这四条的共性:没有一条是「算法不先进」,全部是「不可控、不可观测、不可替换」。LevelDB 为可验证的正确性而生,而生产环境需要的是可调控的可靠性。这个分野决定了后来 RocksDB 的全部性格。
三次跃迁:从能用、敢用到会算账
2012 年底,Dhruba Borthakut 牵头的团队以 LevelDB 为起点开工,2013 年 RocksDB 正式开源。十余年下来,它的演进可以切成三段,每一段都在补上一段留下的账。
第一跃迁(2012–2015):从单体引擎到可组合内核
这一阶段解决的是上面清单里的第 1 和第 4 条。两件标志性的事:一是引入 Column Family(列族),让一个实例内部可以划出多个独立的逻辑域,每个域有自己的 MemTable、层级与压缩策略——隔离的问题从此有了官方答案;二是把 Compaction 拆成可调度、可观测、可中断的阶段,后台任务从「一旦开始必须做完」的黑盒,变成可以参与资源博弈的一等公民。多线程 Compaction 与细粒度统计也在这一时期补齐。这一阶段的标志性成果,是 RocksDB 成为 MySQL 存储引擎 MyRocks 的底座——一个嵌入式引擎第一次证明自己扛得住 OLTP 级别的事务负载。
第二跃迁(2016–2019):从本地引擎到云原生基座
引擎稳了,硬件环境却开始变得五花八门:NVMe、大内存、对象存储、混合介质。RocksDB 的应对是把「介质差异」翻译成配置项。BlobDB 把大 Value 从 SST 里剥离出去单独存放,SST 里只留句柄,缓解大值场景下 SST 的膨胀与频繁重写;TTL 过滤器让过期数据在 Compaction 时自动清退,时序场景从此不用自己写清理任务;WAL 与数据文件可以分开指定介质,日志上低延迟盘、数据走高吞吐盘。这一阶段的关键词是「接受不均匀」:引擎不再假设一块均匀的磁盘,而是接受由不同介质拼成的存储拓扑,并让数据生命周期与介质特性绑定。
第三跃迁(2019 至今):从配置驱动走向会算账的引擎
规模问题解决后,新问题变成「配置组合爆炸」:两百余个配置项,普通团队根本无从下手。近年的演进集中在让引擎自己参与算账——更细的统计与追踪接口、按负载动态调整的触发逻辑、以及对 ZNS 分区介质这类新硬件的原生适配。社区里关于自动调参、学习型压缩策略的讨论从未停止。要强调的是,这一跃迁远未完成,生产环境的主流仍是「人工设定参数、指标验证效果」,这也是本教程第 8 章花整整一章讲调优方法论的原因:在引擎学会自己记账之前,账还得人来算。
演进时间线
下面这张图把十余年的关键节点放在一条线上,方便对照每笔「欠账」与「还账」的先后。
图1-1 RocksDB 演进时间线
引擎选型:把四本账摆上桌
出处讲完,直接回答一个工程问题:什么时候选 RocksDB,什么时候不选。下面把四个常被放在一起比较的引擎按统一口径过一遍。InnoDB 是 B+ 树阵营的代表,放进来是为了看清「LSM 与 B+ 树」这条最大的分界线。
| 维度 | LevelDB | RocksDB | WiredTiger(MongoDB) | InnoDB(MySQL) | Badger(Go) |
|---|---|---|---|---|---|
| 核心结构 | 单一 LSM | 多列族 LSM | B+ 树为主、日志混 LSM | B+ 树 | LSM 加独立值日志 |
| 写放大 | 高且不可控 | 可调,逐层可控 | 较低,日志有额外开销 | 中,随机写页 | 低,值不重写 |
| 读放大 | L0 堆积时陡增 | 布隆加多层索引压制 | 稳定,树查找 | 稳定,树查找 | 需两次查找 |
| 空间放大 | 无预算概念 | 可预算可监控 | 中 | 中,碎片与页空洞 | 依赖值日志回收 |
| 可观测性 | 几乎为零 | 数百项指标 | 关键路径统计 | 较完善 | 基础统计 |
| 适用场景 | 学习与原型 | 写密集、大吞吐、嵌入式底座 | 文档型混合负载 | 读密集事务 | Go 生态、写密集轻场景 |
这张表的用法比结论重要:先问自己的负载在哪一列敏感。写入吞吐压倒一切、读取可以容忍多层查找——LSM 阵营;点读延迟与复杂查询压倒一切、写入量温和——B+ 树阵营;两边都要——要么接受 RocksDB 加多层缓存的组合拳,要么重新审视需求。几个被广泛验证的选型结论:写占比高、数据量上 TB 的场景,RocksDB 对 InnoDB 常有数倍的写入吞吐优势,这就是 MyRocks 能在用户资料库场景大规模落地的原因;而重事务、重 JOIN 的场景,InnoDB 的成熟度仍然难以替代。
动手核对一笔账
用一个小实验建立体感。在同一台机器上分别用 LevelDB 与 RocksDB 各跑一轮持续随机写入,打开 RocksDB 的统计后你会看到两个引擎「物理写入字节」与「逻辑写入字节」的比值差异:LevelDB 的数字不受你控制,RocksDB 的数字随参数平滑变化。这一步不需要写代码,两侧都提供现成的基准工具。当你在第 5 章看到写放大的正式定义时,回过头看这组数字,会理解得比只读定义深一层。
本节要点
- RocksDB 的起点是四张失灵清单:单线程压缩、无统计、零插拔、无隔离——全部指向可控性而非算法先进性;
- 三次跃迁的主线依次是:可组合内核(列族与并行压缩)、云原生基座(介质适配与大值分离)、会算账的引擎(指标与自适应);
- 选型的第一问不是「谁快」,而是你的负载在哪本放大账上最敏感;
- 引擎对比要看结构、四本放大账、可观测性三个层面,单一吞吐数字不构成选型依据。
下一节把全书通用的词汇表一次立起来:LSM-Tree 的三句话纲领,以及 MemTable、SSTable、序列号这些将伴随你读完本书的概念。