1.2 核心概念与术语
1.2 核心概念与术语:LSM 的公理与全书词汇表
本节摘要:LSM-Tree 不是 B+ 树的替代品,而是对存储介质物理特性的另一套回应。本节用「写入即追加、分层即调度、读取即聚合」三句话立起 LSM 的公理,随后逐个讲清 MemTable、Immutable MemTable、SSTable、墓碑、序列号、列族、快照七个贯穿全书的概念,并说明它们各自在哪本放大账上记账。读完本节,后续章节出现的任何术语都不再是新词。
先把物理账算清
理解 LSM 之前,得先接受一个硬件事实:存储介质对「顺序写」和「随机写」的态度天差地别。机械盘的顺序写带宽可以是随机写的成百上千倍;SSD 虽然随机读极快,但随机小写会引发垃圾回收与写放大,寿命和稳态性能都受影响。B+ 树的成长土壤是「就地更新」:为了保持树的有序,每次插入都可能改动磁盘上的页,写入天然带随机性。这套假设在机械盘时代靠缓存与预读勉强维持,到了 SSD 与更新的介质上,随机写就成了性能与寿命的双重出血点。
LSM-Tree 的回应是把问题倒过来:不追求写得多整洁,先追求写得快——把所有随机写驯化成顺序写,把整理工作推迟到后台慢慢做。 这就是那句被引用了无数遍的「以顺序换随机」。它不是免费午餐:推迟的整理工作变成了读放大与空间放大的来源。所以 LSM 的所有设计,本质上都是在三本账之间挪动数字。
三句话公理如下,后面所有机制都能从这三句推出来:
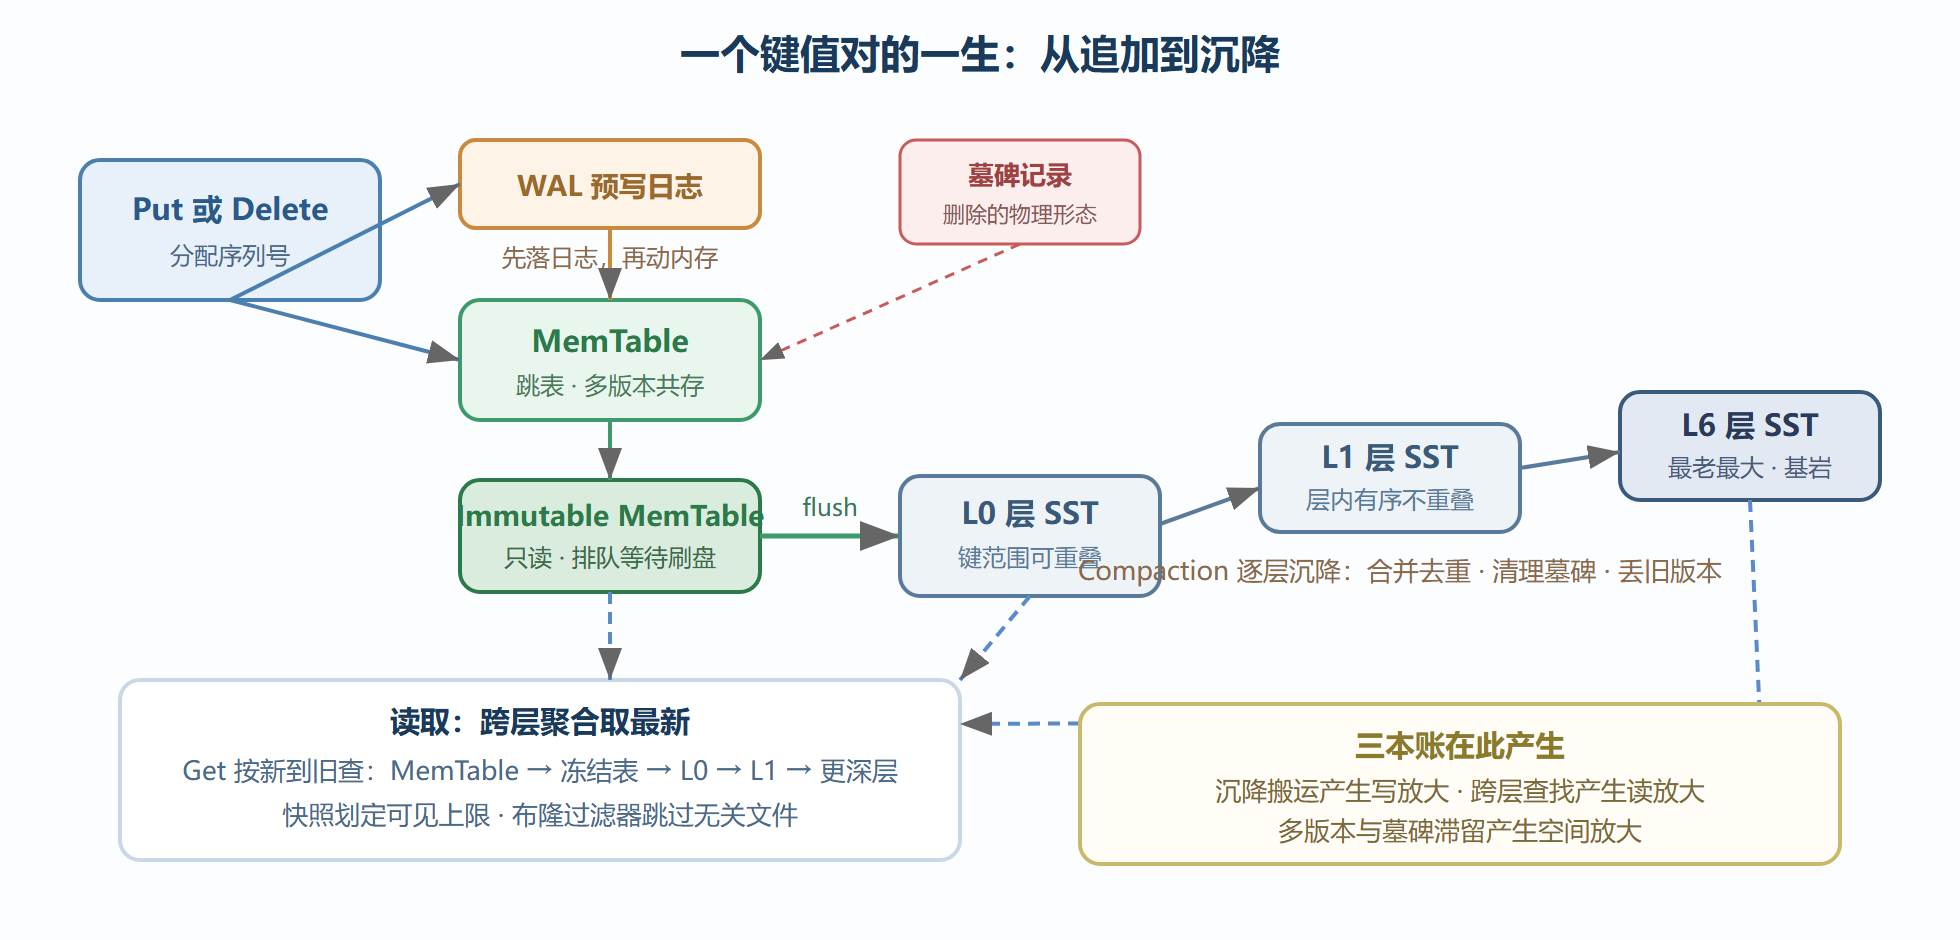
- 写入即追加:任何写入(新增、修改、删除)都不就地改数据,而是追加到内存的有序结构 MemTable 里,同时写一份预写日志 WAL 兜底。删除也只是一条特殊的追加记录——「墓碑」。
- 分层即调度:MemTable 写满后冻结为只读的 Immutable MemTable,后台把它刷成磁盘上第一层的 SST 文件;再由后台 Compaction 一层层往下合并。越深的层越老、越大、越有序。
- 读取即聚合:读一个键,要同时查内存的 MemTable 和磁盘各层的 SST,按版本新旧取最新的那条。各层的布隆过滤器与索引用来剪枝,避免真的翻遍所有文件。
概念清单:七个词贯穿全书
MemTable(内存表)。写入的第一站,默认用跳表实现:无锁并发插入、天然有序、支持范围遍历。它按内部键排序,同一个键的多个版本共存于此。MemTable 是易失的,所以每次追加都要先写 WAL——这两者的先后顺序是崩溃安全的地基,第 2 章会展开。
Immutable MemTable(冻结内存表)。MemTable 达到容量阈值后不改数据、只改状态:旧的表被冻结为只读,新写入切到新开的表。冻结是瞬时的,刷盘是异步的,这个「内存里的排队区」让写入洪峰不至于直接顶到磁盘。引擎允许同时存在多个冻结表排队,个数受配置约束。
SSTable(有序字符串表,SST 文件)。磁盘数据的组织形式。一个 SST 内部按键有序,切成固定大小的数据块,附带三类辅助结构:数据块索引(按键定位块)、布隆过滤器(快速否定不存在的键)、元数据(键范围、条数、校验和)。L0 的文件由冻结表直接刷出、键范围互相重叠;更深的层由 Compaction 产出、层内键范围互不重叠。
墓碑(Tombstone)。删除操作的物理形态:一条带着删除标记的记录,与普通数据一样参与排序与沉降。它保证删除能在多版本世界里压住所有旧值,但也意味着「删了的数据」在物理上还要活到 Compaction 把它与旧值一起清掉为止——这是空间放大的重要来源,第 5 章细算。
序列号(Sequence Number)。全局单调递增的 64 位整数,每次写入分配一个。它是多版本的裁决者:同一键的多个版本靠它排出新旧,快照靠它划定可见范围,Compaction 靠它判断哪些旧版本可以物理清除。它不依赖墙钟,不受时钟回拨干扰,是引擎内部唯一的时间度量。
列族(Column Family)。实例内部的逻辑分区。每个列族有独立的 MemTable、层级、压缩策略、缓存配置,但共享 WAL 与全局序列号空间。它解决的是「多种访问模式混住一个实例」的干扰问题——这在多租户与多形态数据(配置、索引、正文)场景里是刚需。
快照(Snapshot)。一个被固定下来的序列号。拿着快照去读,就只能看到序列号不大于它的版本,从而无视快照之后的并发写入。创建快照几乎零成本(只是记一个数字),但长期持有会阻止旧版本被 Compaction 清理——便利与空间账单总是同时到达。
一张图看懂数据的一生
下面这张图把七个概念放进同一条数据流。一个键值对从写入进入,最终要么留在深层被读取,要么被墓碑清退出局。全书十章,讲的都是这条流水线上的某一站。
图1-2 键值对在 LSM 中的生命周期
用一段代码把概念串起来
概念是否真的立住了,测一下就知道。下面这段伪代码风格的会话把本节大部分词汇用了一遍,配合注释自己走一遍逻辑:
// 打开数据库:默认列族自动存在 DB* db; Options opts; opts.create_if_missing = true; // 库不存在则新建 Status s = DB::Open(opts, "/tmp/rocksdb_demo", &db); // 三个写操作,各自分配递增的序列号 db->Put(WriteOptions(), "user:1001", "Alice"); // seq = 100,kTypeValue db->Put(WriteOptions(), "user:1001", "Amy"); // seq = 101,新版本压住旧版本 db->Delete(WriteOptions(), "user:1001"); // seq = 102,写入的是墓碑 // 不带快照的读:拿到空——墓碑 seq=102 压住了前面所有版本 std::string v; db->Get(ReadOptions(), "user:1001", &v); // v 为空,状态 NotFound // 带快照的读:把可见性上限钉在 101,看到的是 Amy 而不是空 const Snapshot* snap = db->GetSnapshot(); // 捕获当前最大序列号 ReadOptions ropts; ropts.snapshot = snap; db->Get(ropts, "user:1001", &v); // v == "Amy"(在删除前建快照的情形) db->ReleaseSnapshot(snap); // 不释放会阻止旧版本被清理
三个细节值得停下来想:第一,两次 Put 并没有覆盖彼此,它们作为两个版本共存,靠序列号分胜负——这就是「追加」公理的直观体现;第二,Delete 之后数据并没有消失,磁盘账面上它还要占地方直到 Compaction 收网;第三,快照没有复制任何数据,它只是一个数字,却让读取有了「时间机器」的能力。这三点在后面的写路径、Compaction、事务章节里都会反复出现。
常见误区:三个高频误会
⚠️ 「LSM 的树」不是树。LSM-Tree 这个名字有误导性,它更像一个动态的分层状态机:每层是某段时间窗口内写入的快照,层与层靠 Compaction 收敛。把它想成树,会误解 L0 为什么允许重叠、删除为什么不是立刻生效。
「删除很快」的误会。Delete 的成本被推迟了:调用立刻返回,但墓碑要参与后续每一次沉降,直到与它压住的所有旧版本一起被物理清除。删除密集的负载,空间放大往往先于写放大报警。
「快照免费」的误会。创建快照确实是零拷贝、零锁的,但每个活跃快照都是 Compaction 的「赦免名单」:它引用的旧版本不能清。几百个忘释放的快照,等于给整库的旧版本发了永久居留证。
本节要点
- LSM 三公理:写入即追加、分层即调度、读取即聚合——后续所有机制与参数都是这三句的展开;
- 七个核心概念各司其职:MemTable 承接写入、冻结表缓冲洪峰、SST 承载持久化、墓碑标记删除、序列号裁决新旧、列族隔离负载、快照定格历史;
- 三本放大账在数据沉降与聚合读取的过程中天然产生,不是缺陷而是这套范式的固定成本;
- 概念即契约:冻结、递增、清退都是引擎对使用者的承诺,理解承诺才知道调整参数时动的是什么。
词汇表立稳了。下一节看这套范式被塑造成了什么样的产品性格——四个设计锚点,以及它和同类引擎的正面比较。