4.1 写路径详解
4.1 写路径详解:一次写入的时序流水线
本节摘要:一次 Put 在引擎内部不是单个动作,而是一段被严格编排的时序:排队、领号、落日志、入内存表、确认返回,随后是异步的冻结与刷盘。本节按这条流水线逐站走一遍,讲清同步写的两种模式、批量写的合并机制、写停顿的分级行为,最后给出写入侧的常见坑与参数抓手。
先看一次慢写入的现场
一条值得复盘的工单:某业务把批量导入的写入延迟从个位毫秒恶化到数百毫秒,团队第一反应是磁盘写满或者压缩太猛。抓取指标后发现两个细节:日志同步写入的耗时只占延迟的一小部分;真正的大头是「写入在队列里的等待时间」。再往深挖,是同一批并发写入里混着「要求立刻落盘」的同步写——每个同步写都在等日志刷盘,把排它写队列堵成了单行道。
这个现场浓缩了写路径的全部要点:写入延迟 = 排队 + 领号 + 日志落盘 + 内存插入,四段里任何一段都可能成为瓶颈,而病因各不相同。本节按流水线顺序拆解每一站,最后回头把这个案例的解法讲透。
流水线五站
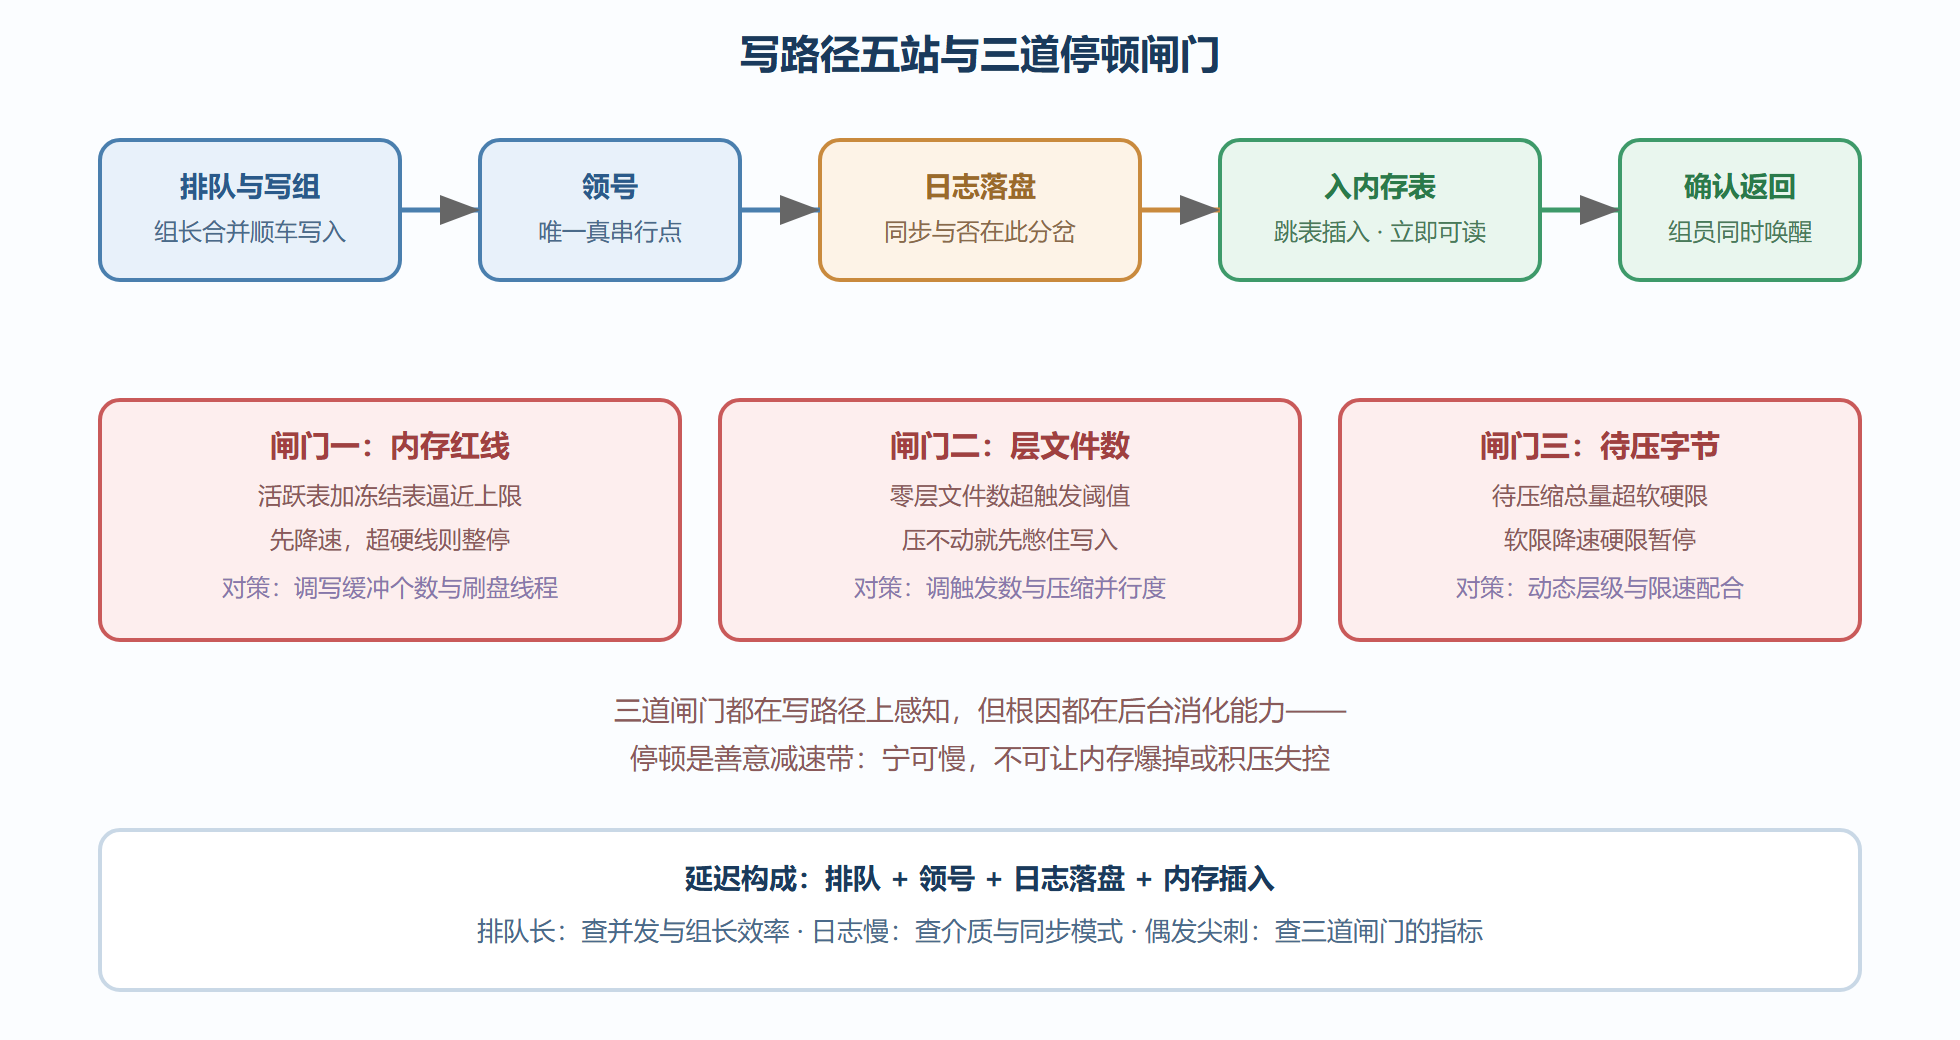
第一站:排队与写组。 所有写入先进一个先进先出的写队列。队列的第一个线程成为「组长」:它趁着排队的时间窗,把后续赶到的、选项兼容的写入合并成一组,然后代表全组走完日志落盘的流程,组员们坐享其成。这个「顺车机制」是写入吞吐的隐形功臣——并发越高,一次日志刷盘分摊的写入越多,单条写入的均摊成本越低。副作用是队头阻塞:组长的日志慢,全组跟着慢,这正是上面工单的病灶之一。
第二站:领号。 组长为代表整组的写入领取连续的序列号。领号环节极快,但它是全引擎唯一的真串行点——所有版本的先后关系都由这里定。它的存在保证了「写入顺序」这个概念在并发下依然有唯一解。
第三站:落日志。 组长把整组操作序列化成日志记录追加进 WAL。这里出现了写路径最重要的分岔:
| 写模式 | 行为 | 换来什么 | 付出什么 |
|---|---|---|---|
| 完全异步 | 写入内核缓存即返回 | 最低延迟 | 宕机可能丢最近几毫秒的写 |
| 同步落盘 | 等日志刷到存储介质再返回 | 断电不丢已确认写 | 每次写多付一次刷盘延迟 |
| 手动同步 | 批次结束后统一刷一次 | 折中 | 需要上层自己界定批次 |
三种模式没有对错,只有与业务承诺的对齐。「最近的写入可以丢」的业务(缓存类、可重建数据)用异步能白赚延迟;金融类场景必须同步;而大多数业务真正的答案是中间态——按事务批次手动控制刷盘点,把「持久」的粒度交给上层定义。
第四站:入内存表。 日志落定后,记录插进活跃内存表的跳表。这一步几乎总是微秒级,但它是内存水位相关停顿的感知点:内存表和冻结表占用逼近红线时,写入在这里被要求等待。
第五站:确认返回。 全组写完内存表,组长唤醒组员,各自返回成功。此刻这笔写入已同时存在于日志和内存表,磁盘上的 SST 里还没有它——这就是第 2 章说的「持久性载体尚未换手」的阶段。
图4-1 写路径时序与停顿闸门
写停顿:善意的减速带
三道闸门值得专门一节里的专门一段,因为它是写入侧报警的头号来源。逻辑一句话就能说清:前台写入的速度上限,由后台消化的速度决定;后台跟不上时,与其让内存爆掉、积压失控,不如让前台先慢下来。
三道闸门的次序是设计好的从软到硬:内存水位先「降速」后「硬停」;零层文件数到达触发线意味着「零层已经压不动了」;待压缩字节先过软限(写入被故意拖慢给后台争取时间)再过硬限(写入暂停)。运维视角的读法:停顿指标不是故障信号,是欠账信号——它出现说明后台消化能力已经被写速超越,要修的是消化端(压缩策略、并行度、介质带宽)或生产端(写入速率、批次大小),而不是把闸门阈值调大假装没看见。把阈值调大等于把减速带换成悬崖,第 5.4 节的排错实录会完整走一遍这个误区的纠正过程。
批量写:一次确认买多笔写入
批量写接口是写路径的吞吐放大器:一批操作打包成一次日志落盘、一次领号区间、一次内存表批量插入。它的账目收益按「均摊」计算——批次越大,单笔操作分摊的日志成本越低。两个纪律随之而来:批次要有上限(太大占用内存、拉长组长的持锁时间、放大失败重试的成本),批次内保持选项一致(同步属性不同的写入合不进一组)。
回到工单现场
现在可以给开头的案例开处方了。症状:批量导入时写入延迟数百毫秒;病灶:导入流里混入了零星的同步写,它们做组长时把全组拖进日志刷盘的等待;处方三步:导入流统一改为「批次结束手动刷一次」,把同步点从随机散布收敛到批次边界;导入期间临时调大写缓冲,减少闸门一误触发;导入完成后恢复常规写选项。整改后延迟回落到个位毫秒。这个案例的通用教训值得加粗:写入延迟问题,一半以上出在「谁在什么时候要求落盘」,而不是磁盘本身。
一段同步写延迟的分解实测
流水线的价值在测量里兑现。对一个同步写为主的实例做延迟分解,把一段三毫秒的典型写入拆开看:排队等待约零点二毫秒——写组机制在并发下基本顺手;领号忽略不计;日志落盘约二点四毫秒,占八成——这是同步写为持久承诺付的介质价;内存表插入约零点一毫秒;剩余是框架开销。分解的结论直接指向治理优先级:这段延迟的治理就是日志落盘的治理——介质选型、刷盘策略、写组合并效率三件事,其他环节调出花来也动不了大局。
异步写的分解则给出另一面的账:总延迟降到零点三毫秒,日志落盘缩成「写入内核缓冲」的一次内存级操作——省下的两毫秒就是「确认」卖掉的价格,崩溃窗口内的数据暴露由此产生。两个数字放在一起,就是第 2 章那句「持久性载体换手」的标价单。
再补一个变式:同步写场景下,把业务批次从单笔改成二十笔一组,组内一次刷盘,均摊后的单笔落盘成本降到原来的几分之一——这是写组机制给「愿意攒批」的业务的折扣。三个实测拼出的结论与本章开头的工单殊途同归:写入延迟治理的钥匙,大半挂在「谁在什么时候要求落盘」这一问上。
本节要点
- 写入延迟由四段构成:排队、领号、日志落盘、内存插入,分段定位才不误诊;
- 写组机制让并发成为吞吐的朋友——均摊日志成本;但组长慢则全组慢;
- 三种日志模式对应三种持久承诺,按业务丢失容忍度选择,别一律同步;
- 写停顿是欠账信号不是故障信号,修消化端或生产端,别调大阈值掩耳盗铃;
- 批量写是吞吐放大器,纪律是批次有上限、选项保持一致。
写入的立法程序走完了。下一节换到司法席:一次读取如何穿过层层版本裁决出唯一答案。