4.2 读路径详解
4.2 读路径详解:一次读取的多层裁决
本节摘要:读取是 LSM 引擎里唯一「先花钱、后知道结果」的动作:一次点查可能只碰内存,也可能穿透七个层级、打开数个磁盘文件。本节把 Get 的多层裁决拆成一张账单——每一层的查找成本、剪枝手段、终止条件逐一核算,再讲范围扫描的堆式归并与快照读的时间锚定,最后给出一组能直接落地的读放大控制手段。
给一次读取记账
上一节的写入流水线有个让人安心的性质:成本在写入前就大致确定。读取恰恰相反——同样是 Get 一个键,运气好时百纳秒从内存表返回,运气差时要在磁盘上翻好几个文件。这笔账的不确定性,就是「读放大」:一次逻辑读取,实际付出的物理访问次数。审计读路径,就是把每一次 Get 拆成逐层的账目,弄清钱花在哪层、哪层有打折券、哪层会失控。
先立一条总规矩,它是后面所有机制的根:数据越新,住得越靠上;查找自上而下,首次命中即最终答案。 内存表里的版本一定比冻结表新,冻结表一定比零层文件新,零层一定比更深层级新。这个顺序由写入时的序列号保证,于是查找可以大胆地「见好就收」——在某层命中后立即返回,绝不下探。省下的不止是时间,更是后面所有层的磁盘访问。
点查的四站裁决
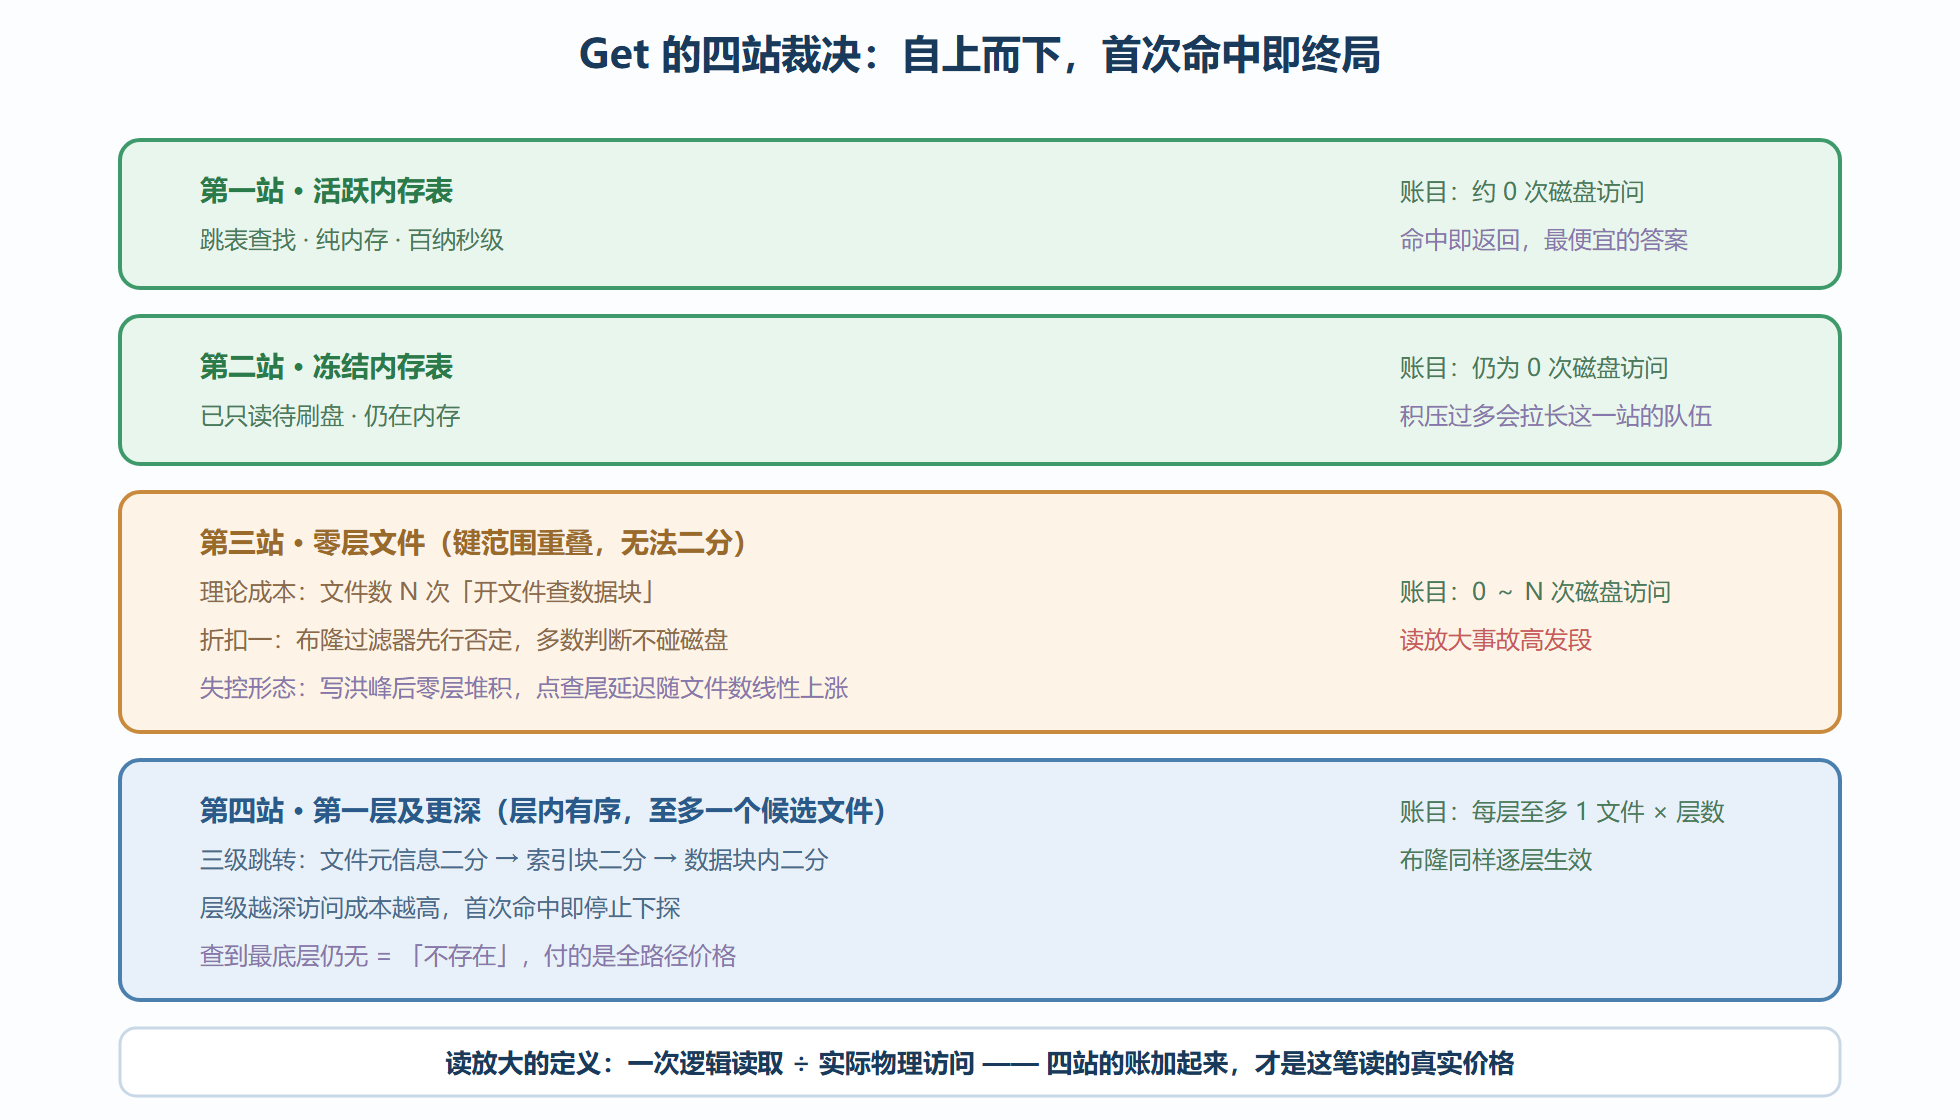
一次 Get 自上而下经过四站。第一站是活跃内存表,跳表查找,纯内存指针操作,百纳秒量级,这是全路径最便宜的一站。第二站是冻结内存表——已经只读、等待刷盘的那批数据,同样在内存里,成本与第一站同量级。这两站查完没有结果,才真正开始花钱。
第三站是零层文件,读放大最常见的失控点。零层文件由刷盘直接生成,键范围彼此重叠,同一个键可能出现在任何一个文件里,无法二分定位,理论上要逐个文件查。如果不加治理,零层堆积二十个文件时,一次点查最坏要做二十次「打开文件—定位数据块」的动作。引擎在这里安了两道折扣:其一是每个文件自带的布隆过滤器,先做一次「可能包含吗」的判断,绝大多数「不在这个文件」的判断在内存里就完成了,根本不碰磁盘;其二是文件级统计——很多场景下连过滤器的位图都常驻缓存,零磁盘访问完成否定。
第四站是第一层及更深的层级,这里才体现「有序红利」。层内文件键范围互不重叠,给定一个键,先在内存里的文件元信息上做二分,至多锁定一个候选文件;再在文件索引块里二分定位数据块;最后在数据块内部二分找到键。三级跳转,每一级都把搜索空间砍掉一个量级。若该层也没有,继续下一层,直到最底层仍无结果,返回「不存在」——注意这个「不存在」同样花掉了全路径的钱,查无此键是读放大最贵的情形之一。
图4-2 一次点查的四站账目
两张打折券:布隆过滤器与缓存
把账单压下来,靠的是两样东西,都在第 6 章还会细讲,这里先记账目上的角色。
第一张券是布隆过滤器。每个 SST 文件都可以带一个位图结构的过滤器,它的承诺是「说不在就一定不在」:对一次点查,先问过滤器,若回答「不含此键」,这个文件直接跳过,一次磁盘访问都省下。代价是两笔:内存里要养着这些位图(默认每键十个比特上下的开销),以及极小概率的误判——说「可能在」,实际查了却没有。调参的空间在于过滤器的粒度:整键过滤器对点查友好,前缀过滤器对前缀扫描友好,选错了券就作废。
第二张券是块缓存。索引块、过滤器位图、热点数据块都缓在内存里,命中后连磁盘访问都免了。读路径的指标要分层看:内存命中率高的系统,账单大头只剩 CPU;命中率一跌,磁盘访问次数立刻在延迟上显形。所以读放大排查的第一步永远是看两件事——零层文件数、缓存命中率,它们分别对应第三站失控和第四站打折券失效。
范围扫描:堆式归并的账法
点查之外,另一种读取形态是迭代器扫描。它不逐键重复四站裁决,而是开局一次定位、之后顺流而下:引擎为每一层数据各建一个子迭代器——内存表一个、冻结表各一个、零层每个文件一个、更深每层一个候选——全部挂进一个小顶堆。堆顶永远是被允许看到的最大序列号约束下的全局最小键;每次 Next 弹出堆顶、推进该子迭代器、重新入堆,对数复杂度换来全局有序。
这套归并省掉了重复定位,但引入了另一种成本:迭代器活着一天,它引用的每一层数据就不能被后台清理。一个忘了关闭的迭代器,会让本该被压缩归并掉的旧文件一直留在磁盘上——这是空间放大的一种隐蔽来源,账记在读取侧,症状却出现在存储侧。工程纪律由此而来:迭代器随用随关;长扫描放进后台批处理并限时;给迭代器设置超时与监控,看到「活跃迭代器数」长期不归零就该查代码了。
快照读:把时间锚在序列号上
读路径的第三根支柱是快照。它的实现便宜得令人意外:不拷贝任何数据,只记下创建时刻的全局序列号。此后基于这个快照的所有读取,都只允许看到序列号不大于该刻度的版本——内存表里更新的版本被遮住,磁盘文件靠元数据里的序列号区间快速过滤。写入与压缩照常进行,读取拿着一个静止的时间切片各查各的,互不阻塞。
快照的账目代价在清理侧。压缩在归并时必须保住「仍有快照引用的旧版本」,于是最底层的旧数据迟迟清不出去。快照用得越久、攒得越多,空间放大的账越难平。纪律同样是三条:用完立刻释放;给快照加生命周期管理(超时自动作废的包装层);监控「最老快照年龄」,它和最底层旧数据量强相关。
一条读放大工单的完整复盘
把三个机制串成一个案例。某画像服务的点查 P99 从两毫秒爬到十五毫秒,QPS 没变、数据量没变。按本章的账法排查:第一步看零层文件数,指标显示长期维持在十几二十个——第三站失控,写入洪峰超过了后台压缩的消化速度;第二步看缓存命中率,从九成六跌到七成——零层堆积挤占了缓存,第四站打折券也跟着失效,两个病灶互相加重。处方分三步:临时把压缩后台线程加一档,让积压消化掉;把刷盘触发的写缓冲调小一档,让零层文件来得更勤、更小、更快被压走;对业务的批量写入加节流,削掉洪峰尖刺。一周后 P99 回落到三毫秒以内。这个案例的通用教训:读延迟恶化,先查读取的账单花在哪一站,再回头查是谁把那一站挤爆的——直接去调读取参数,多半是开错药方。
本节要点
- 读取自上而下四站裁决:活跃表、冻结表、零层文件、有序层级,首次命中即终局,越层不回头;
- 读放大的账单按站计价:零层失控与缓存失效是点查恶化的两大惯犯;
- 布隆过滤器与块缓存是两张打折券,一个省磁盘访问、一个省重复访问,粒度选错等于作废;
- 迭代器是堆式归并,省了重复定位,但活着就锁住底层数据,忘了关会把账记到空间放大上;
- 快照只是一个序列号刻度,读取便宜、清理昂贵,释放纪律决定空间账的成色。
读取的三种形态讲完了。下一节把镜头拉远:当读写同时涌来,引擎靠什么维持秩序——并发控制与多线程模型的记账规则。