6.1 缓存系统
6.1 缓存系统:三本内存折扣账
本节摘要:缓存是读路径账单上折扣力度最大的一张券:命中时一次内存访问,未命中时一次完整磁盘读,差价是两三个数量级。本节把引擎里的三本缓存账分开盘点——数据块缓存、文件元数据缓存、持久化缓存介质,讲清各自的管辖范围、容量怎么定、哪些块值得特殊保护,最后给一套命中率跳水时的标准取证流程。
先算一笔命中差价
给折扣券定价,先看原价有多贵。一次块缓存命中:哈希查找加指针返回,百纳秒级。一次未命中:定位文件、读索引、读数据块、解压、拷贝给调用方,在最深的层级上这是一次毫秒级的磁盘往返。同一个键,命中与未命中的差价上万倍——这就是为什么命中率从九成九掉到九成,用户感知到的延迟不是涨百分之一,而是可能翻倍:那百分之一的请求,每一个都在付上万倍的价格。
所以缓存的账不能只看平均值,要看分位数。命中率九成九的系统,P99 由那百分之一决定;命中率抖动的系统,P999 会先于任何告警信号恶化。读路径的延迟治理,一半以上就是缓存账目的治理。
三本缓存账
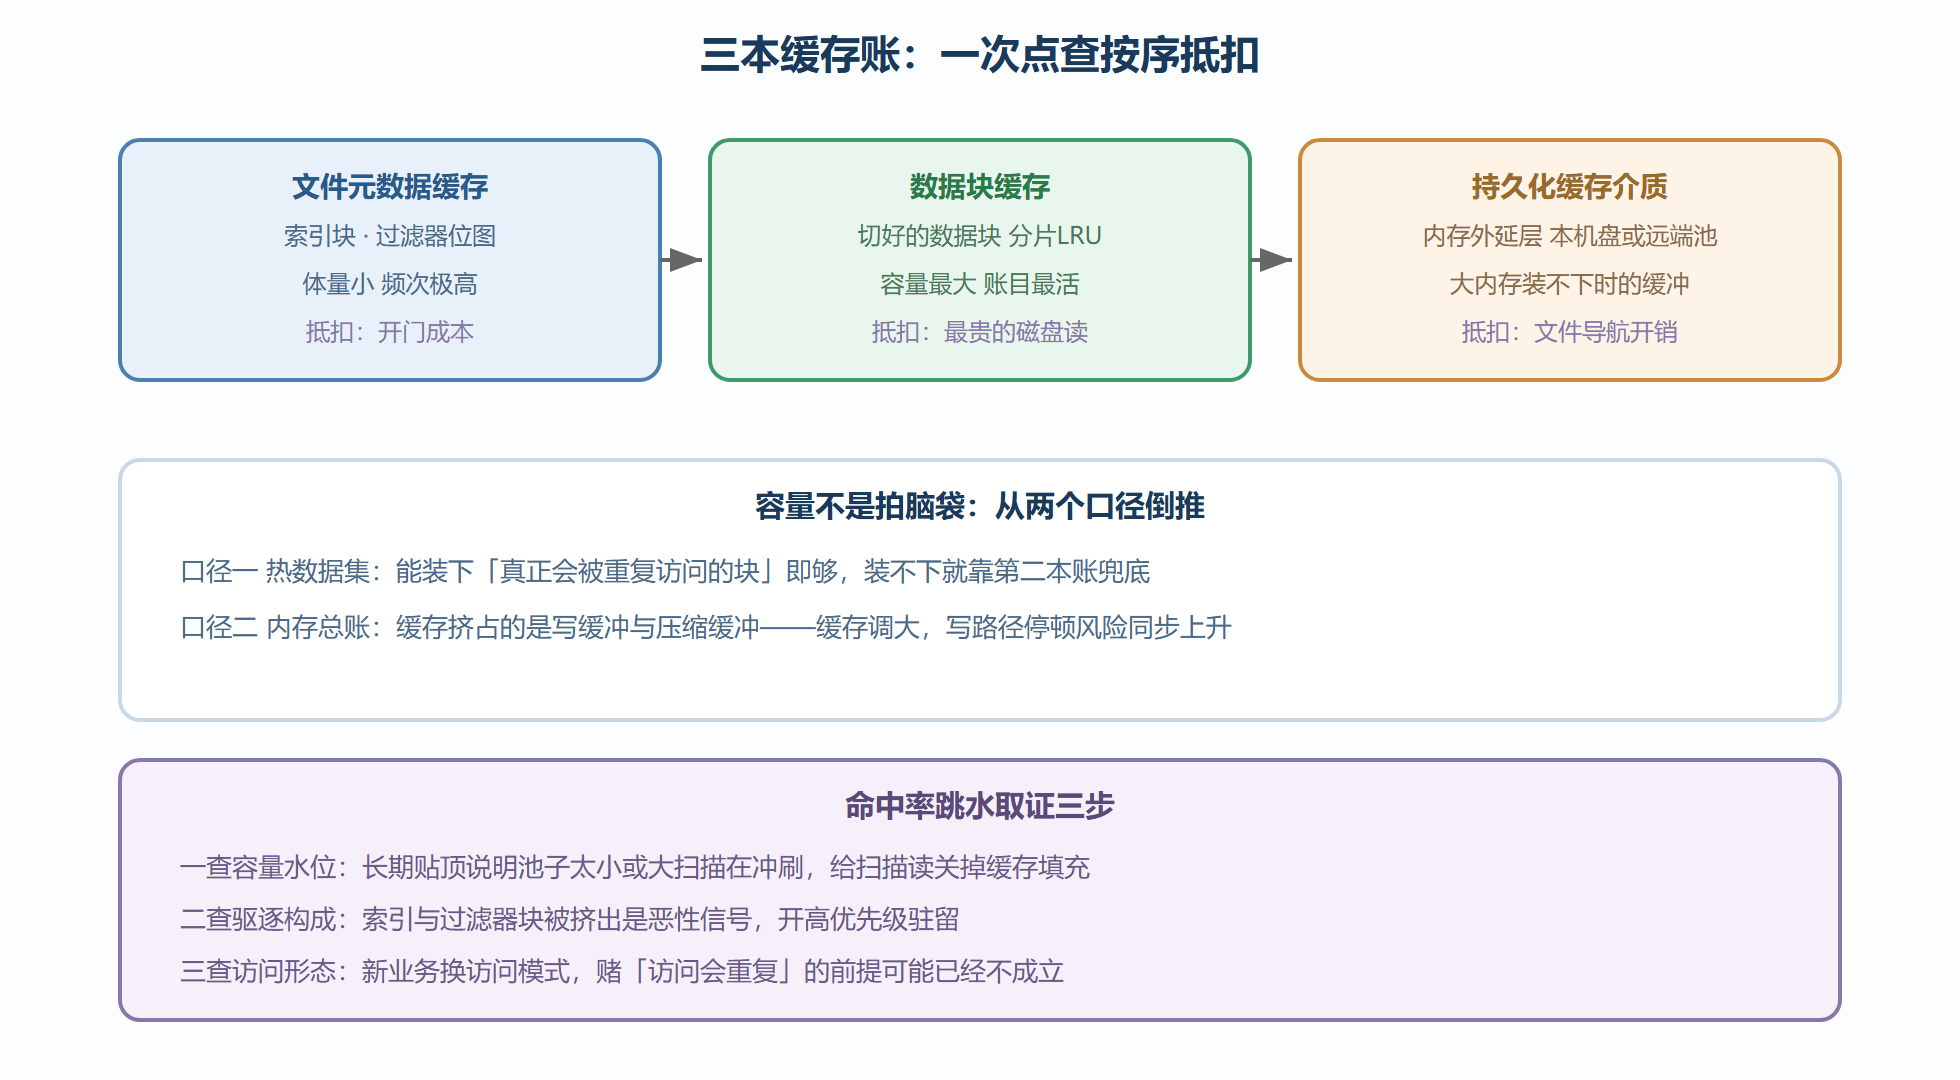
引擎的缓存不是一个池子,是三本分工明确的账。
第一本,数据块缓存,管最贵的那次磁盘读。文件按固定大小切成数据块,读过的块缓在内存里,下次同块的访问直接命中。它是三本账里容量最大、账目最活的一本,默认用分片式的最近最少使用淘汰:整个池子切成上百个独立分片,各管各的链表,读请求按块哈希落到固定分片——这样多线程访问不挤同一把锁,并发吞吐随核数扩展。代价是全局最优性略降,但实测命中率损失通常不足一个百分点,换来的并发收益是实打实的。
第二本,文件元数据缓存,管开门成本。打开一个文件要先读它的索引块、过滤器块,才能定位数据。这些元数据块体量小、访问频次极高——每一次点查都要用到沿途所有文件的导航图。它们混在数据块缓存里有个隐患:一次大扫描能把导航图冲出去,随后所有点查统统退化成「先读元数据再读数据」的双倍磁盘访问。所以配置里有专门的选项把索引块与过滤器块标成高优先级驻留,零层的这两类块甚至可以直接钉在内存里不参与淘汰。这是小内存买大稳定的典型交易,读密集负载基本必开。
第三本,持久化缓存介质,管内存之外的延伸。内存装不下的热块,可以落到一层持久化介质上——本机 NVMe 或者远端内存池——命中它的代价比真正的文件读便宜,因为它按块组织、免去了文件导航的开销。这本账在大内存装不下、又不甘心全部回磁盘的场景有用;小规模实例可以不碰。
图6-1 三本缓存账与一次点查的抵扣顺序
容量怎么定:两笔账一起算
缓存容量的配置是最常被拍脑袋、也最不该拍脑袋的决策。正确算法是两笔账一起算。
第一笔是收益账:热数据集有多大。缓存要装下的是「会被重复访问的块」,不是全部数据——多数负载的访问高度集中,真正反复被读的块可能只占数据总量的几个百分点。用访问日志估算工作集,按块大小折算,得到容量下限;预算宽裕就往上加,让更多温热数据进来。
第二笔是机会成本账:这块内存不给了缓存,能给谁。同进程里写缓冲要内存、压缩过程要内存、客户端自身要内存。缓存无限膨胀的实例,往往死法不是读变慢,而是某天写入突然开始停顿——内存压力传导到写缓冲,刷盘变慢,闸门刹车。稳妥的分配原则是给缓存定显式上限而不是放任它吃满余量,实例的总内存规划里给压缩与写路径留出配额。
一次命中率跳水的复盘
用案例收账。某推荐服务的实例,块缓存命中率长期九成七,某天跌到八成二,点查 P99 同步翻倍。取证按三步走。第一步看容量水位:缓存占用贴着上限,驱逐速率翻倍——池子没有变,是进来的东西变了。第二步看驱逐构成:日志显示大量顺序大区间的扫描读在灌块,热数据块被成批冲出——业务的离线特征回刷任务改成了在线库直扫。第三步做修复:扫描专用的读取选项关掉缓存填充(一次性读的数据不该污染要重复读的池子),回刷任务错峰到低峰期,扫描区间切小。两天后命中率回到九成六。
这个案例的通用教训值得单独一行:缓存是给「重复」准备的,一切一次性、大批量的读取都该自觉绕开它——读取选项里关掉缓存填充这一行代码,是性价比最高的缓存保护措施。
持久化缓存介质的适用边界
第三本缓存账值得单独一页,因为它的账目结构最容易算错。持久化介质上的缓存块与内存缓存最大的差别是「命中也有成本」:内存命中是纯 CPU,介质命中仍是一次设备访问,只是省掉了文件导航与解压的开销。它的折扣率因此介于两者之间——折扣的对象是「导航开销」而不是「读取本身」。
由此推出它的适用边界:导航开销占比越高的负载,收益越明显——文件多、层级深、元数据装不下内存的实例;反之,文件少、缓存能装下导航图的小实例,介质层省不下几个钱,白养一层。另一个适用场景是进程重启后的预热:内存缓存清零的冷启动期,持久层的热块还在,能把「重启后命中率爬坡」的曲线削平——对重启频繁的容器化部署,这一项就值回票价。不适用的是写密集实例:缓存介质本身也有写入开销,别为读折扣引入新的写账单。
一次命中差价的实测记录
给本章开头的「差价」一个实测注脚。某实例在压测下同时记录两组数字:块缓存命中时的点查平均延迟零点零四毫秒,未命中时落到一点八毫秒——四十五倍。按分位看差距更刺眼:命中路径的分位与未命中路径的中位几乎重合,也就是说命中率每跌一个百分点,跌进来的那部分请求整体换到了另一条延迟曲线上。这正是「缓存账要看分位数」的定量依据:均值被命中率平滑,分位才暴露换道的瞬间。把两组延迟分别接进监控,比单一命中率多一个维度;命中率乘以两组差价,就是缓存每小时替你省下的时间——这笔账在容量评审时比任何直觉都有说服力。
最后一笔是容量:介质层的容量给到「装下冷热分界的温层」即可——它追不上纯内存的命中率,也不必追,它的账目角色是让「内存装不下但也不该直接回文件」的那一层有个便宜去处。容量超过温层厚度,多出来的部分几乎永不命中,纯属浪费。
本节要点
- 命中与未命中差价上万倍,缓存账要看分位数,不是平均值;
- 三本账分工:数据块缓存抵磁盘读、元数据缓存抵开门成本、持久化介质做内存外延;
- 索引块与过滤器块体量小价值高,高优先级驻留是小内存买大稳定,读密集负载必开;
- 容量两笔账合算:工作集定下限,内存总账定上限——缓存膨胀的账单会寄到写路径上;
- 一次性大扫描自觉关缓存填充,这是命中率跳水案例里最值钱的一行配置。