6.2 索引与过滤:从布隆到前缀布隆
6.2 索引与过滤:从布隆到前缀布隆
本节摘要:缓存解决「重复访问」的折扣,索引与过滤解决「白跑一趟」的折扣。本节先拆文件内部的两级导航图,再讲布隆过滤器那道「说不在就一定不在」的判断题,然后把折扣券从整键升级到前缀——前缀布隆如何让范围扫描也吃到过滤红利,最后用一个迭代器选项踩坑的实战案例,把前缀扫描的正确姿势一次讲全。
一道只答否的判断题
先立一条本章最反直觉的性质:布隆过滤器是一个只答「否」的判断题。对每个待查文件,它做一次内存里的位图检查:若干个哈希位置只要有一位是零,就断言「此键绝对不在这个文件里」——这个否定永远正确,因为写入时所有键都把自己的哈希位置涂成了一;若几位全是一,它只说「可能在」,这一侧会出错,但出错的代价只是多读一个文件,数据正确性毫发无损。
这个不对称就是敢用概率结构的底气:最坏情况是多花一次磁盘访问,绝不会返回错误答案。 于是读路径的账可以这样改写——没有过滤器时,每个可能含键的文件都要打开核实;有了过滤器,绝大多数「不在」在内存里就被否决,磁盘访问只留给真正含键的文件。默认配置下每键十个比特上下的位图开销,换来百分之一量级的误判率——对照第 4 章的读路径账单,这是整张账单上折扣率最高的一笔交易。
文件内部的两级导航
过滤器负责否决整个文件,索引负责在文件内部定位。导航图有两级,对应第 4 章讲过的三级跳转里的后两级。
第一级,索引块:记录每个数据块的边界键与位置,点查时在它上面二分,定位至多一个目标数据块。它常驻缓存,是元数据缓存账里最重要的住客。第二级,块内定位:数据块内部的键有序存放,按组设立重启点,组间二分、组内直查。
大文件有一个痛点:几百 GB 的文件,索引块本身可能涨到几 MB,整个驻留内存不划算,按需加载又会导致每次查找都要重新读导航图。分区索引的解法是把导航图切成一段段小板子,只驻留一张总目录,查到哪个键区间才加载对应的小板子;分区过滤器同理。这是大容量层级(几个 TB 的最深层)的标准配置,小层级用不上也不必用。
从整键折扣到前缀折扣
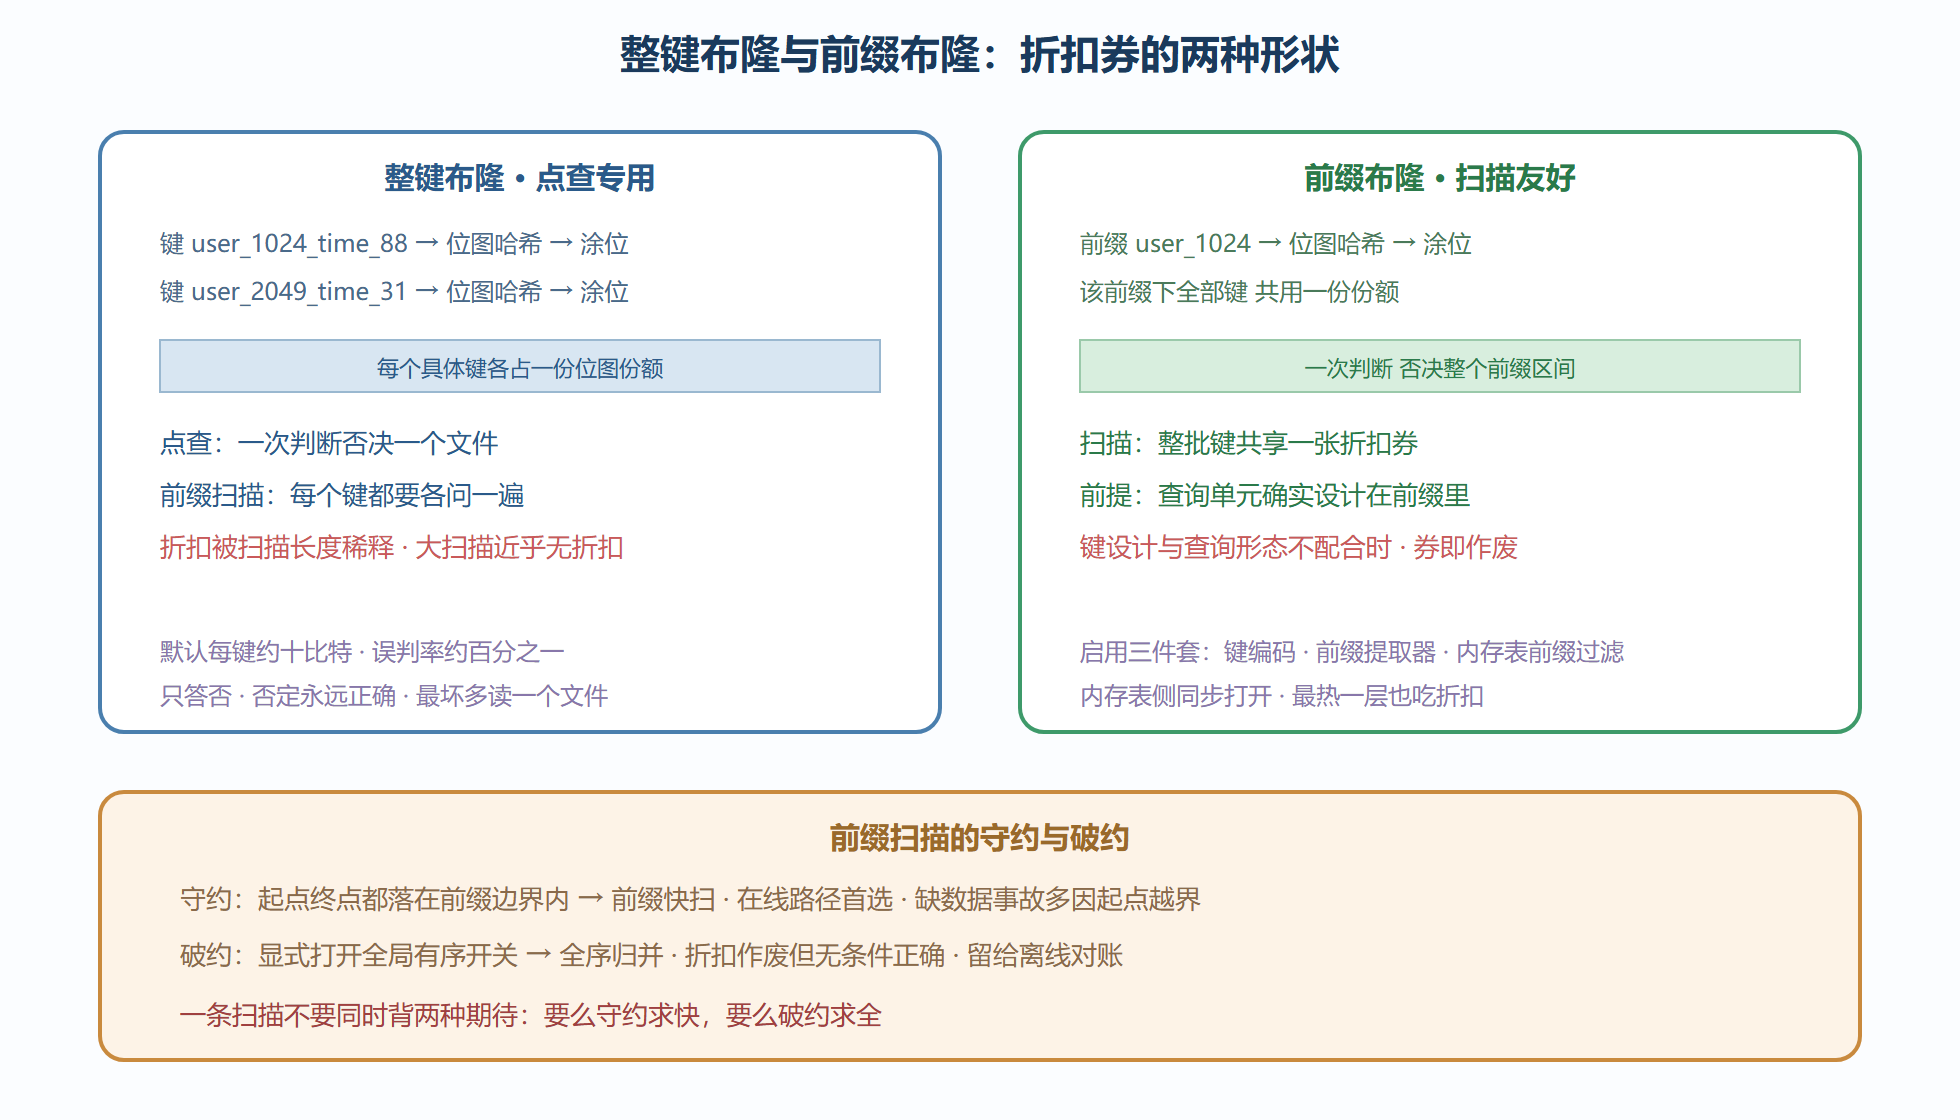
默认的布隆过滤器按完整键构建,对点查是完美折扣,对前缀扫描却使不上劲——扫描一批共享前缀的键,每个具体键都要各自问一遍过滤器,折扣被稀释。
前缀布隆换了一个建模角度:写入时只对键的前缀部分建过滤器位图,查询时同样只问前缀。效果是整批共享前缀的键共用一张折扣券——一次过滤器判断就能否决整个前缀区间。它的适用前提写在名字里:你的读取形态以前缀为单元(用户的所有记录、某会话的所有消息),且键的设计把查询单元放在了前缀里。键设计不配合——查询单元不在前缀上——这张券就是废纸。
前缀布隆的启用是一个链条上的三件事,缺一不可:键编码时把查询单元设计成前缀;配置前缀提取器,告诉引擎从键里截取哪一段参与哈希;内存表侧同步打开前缀过滤,让最热的一层也吃到折扣。第 3 章讲键设计时提过「编码方案参与读放大定价」,这里就是兑现处。
前缀扫描踩坑实录
过滤器与迭代器的交界处,藏着一个出镜率极高的坑,值得用完整案例讲一遍。某消息服务的会话列表页,按会话标识做前缀扫描,取每个用户最近五十条消息。上线后偶发性出现「扫描结果缺失」的工单——不是报错,是结果集少了几条,而且集中发生在「刚发了新消息」的会话上。
排查过程。第一步看数据:缺失的消息都在内存表里,磁盘上有、内存里也有,唯独迭代器没扫到。第二步看配置:该实例开了前缀提取器与前缀布隆,迭代器以「上一个会话的末尾」作为起点向后扫描。第三步定位根因:前缀模式下,迭代器的可见范围被约定在前缀边界内,起点落在前缀边界之外时,引擎的短路逻辑会把一部分本该可见的条目挡在窗外——前缀迭代是「快但有约定」的,约定没守住,缺数据是符合实现逻辑的结果。
修复分两层。业务层,把扫描起点改到目标前缀的边界键上,保证起点与终点都在同一个前缀区间内——这是对约定的尊重。引擎层,确实需要跨前缀的全局有序扫描时(例如对账任务),在读取选项里显式打开全局有序开关,让迭代器放弃前缀短路、老老实实做全序归并——代价是过滤折扣作废,扫描变慢,但它换来的是无条件的正确性。两层的分工一句话说清:在线路径守约定用前缀快扫,离线路径保正确用全序慢扫,不要让一条扫描同时背两种期待。
图6-2 过滤折扣的两级形状
误判率的账怎么算
最后补一笔预算账。过滤器不是免费精准:每键比特数决定误判率,十个比特约百分之一,翻到十四个比特约千分之一——精度翻一个量级,内存预算接近翻倍。预算的定法回到负载:点查主力且文件数多,误判的绝对次数就多,值得多给比特;文件少或读稀疏,默认值足够。观测侧有两个现成的计数器值得接进监控:过滤器否决次数(折扣兑现量)与过滤器误判次数(白跑量),两者之比就是这张券的实时性价比,比值恶化通常意味着键分布变了或文件尺寸变了。
过滤器预算的三个常见问句
预算评审时,过滤器相关的问询集中在三问,把答案备好能省一半会。
一问:误判率要不要调到万分之一?先算绝对量再回答——误判的代价是「多读一个文件」,每秒十万次点查、百分之一误判意味着每秒一千次多读;若缓存能接住这些重复读中的大多数,实际代价可控,默认档足够;若点查打在深层冷数据上,多读就是实打实的磁盘往返,加比特值回票价。误判率不是美德,是要与负载核对的账。
二问:开了前缀布隆,点查还受保护吗?受——前缀布隆改的是位图的建模粒度,不是开关的互斥关系;但点查与扫描形态差异极大的列族,分开配、分开测,两种建模混在一个负载里往往两头不讨好。
三问:怎么知道过滤器在干活?看两个计数器的比值——否决量说明折扣在兑现,误判量说明白跑在发生,比值恶化先查键分布变化再查文件尺寸漂移。没有这两个数的实例,过滤器等于没接线的保险丝:不知道有没有用,只期待它有用。
本节要点
- 布隆过滤器只答否:否定永远正确,最坏多读一个文件——概率结构的正确性边界在此;
- 文件内导航两级:索引块定位数据块,块内重启点定位键;大层级用分区索引与分区过滤器省内存;
- 整键布隆服务点查,前缀布隆让扫描共享折扣券,启用是键编码、前缀提取器、内存表前缀过滤三件套;
- 前缀迭代是快但有约定的扫描,起点越界会缺数据;要全序正确就显式打开全局有序开关并接受变慢;
- 过滤器预算按负载定比特数,用否决与误判两个计数器的比值监控券的性价比。