2.1 标量、向量与矩阵:GLSL 的类型体系
2.1 标量、向量与矩阵:GLSL 的类型体系
本节摘要:GLSL 的类型系统围绕 GPU 硬件量身定做:四通道浮点向量
vec4是原生公民,矩阵是原生类型,标量反而像"退化的一维向量"。本节过一遍完整类型谱系,把 swizzle、构造器、逐分量运算这些高频操作练熟,并说清移动端必须面对的精度限定符。
学习目标
读完本节,你应当能够:为任意图形数据选择正确的类型;熟练使用向量构造器与 swizzle 重排;完成矩阵与向量的乘法并理解其在坐标变换中的角色;在移动端着色器里正确声明精度。
从一个 vec4 开始
打开任何一份着色器代码,出现频率最高的类型一定是 vec4。为什么偏偏是四通道?因为 GPU 的浮点运算单元按四通道打包设计——一条指令同时算完四个乘加,硬件把 x、y、z、w 四个数当成一组干活。语言层面让 vec4 成为原生类型,等于让代码结构与硬件结构对齐:写 a + b(两个 vec4 相加),驱动翻译出来就是一条四通道加法指令,零浪费。
Graphics 领域恰好到处是四元组:颜色是 RGBA,齐次坐标是 xyzw,纹理坐标 padded 之后也常塞进 vec4。类型与需求严丝合缝。
构造方式有三种写法必须练熟:
vec4 color = vec4(1.0, 0.6, 0.3, 1.0); // 全分量显式给出 vec4 gray = vec4(0.5); // 单标量填充所有通道 vec4 mixed = vec4(someVec3, 1.0); // 向量 + 标量拼接,w 常填 1.0 vec3 pos = vec3(color); // 取 vec4 的 xyz 构造 vec3 vec2 uv = pos.xy; // 取前两个分量
标量在 GLSL 里只有 float、int、bool、uint 四种。有一个反直觉的事实值得单独强调:着色器里 float 的使用频率远高于 int,连循环计数器都经常用 float——因为 GPU 的四通道单元天生吃浮点,整数运算要走旁路,除取模等场景外没必要坚持整数。
图:GLSL 类型体系与访问通道
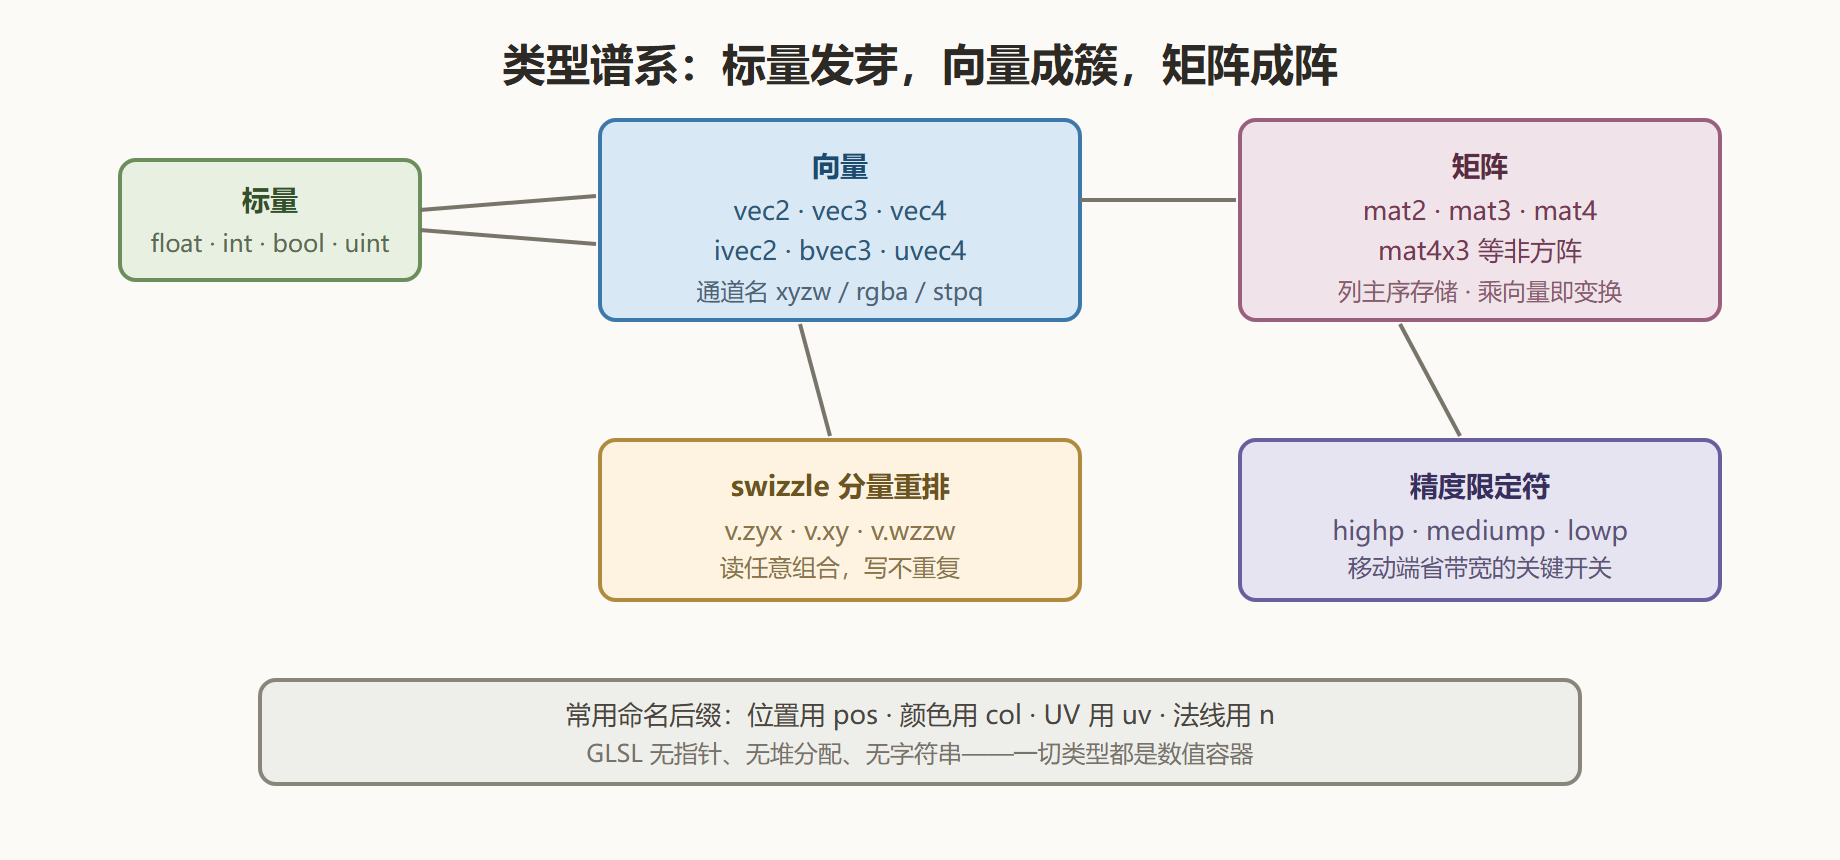
向量运算与 swizzle 实操
向量运算分两层:整体运算(加、减、数乘、点积)与分量操作(swizzle)。前者对应硬件的四通道指令,随便用;后者是 GLSL 最有辨识度的语法糖。
vec3 a = vec3(1.0, 2.0, 3.0); vec3 b = vec3(0.0, 1.0, 1.0); vec3 s = a + b; // 逐分量相加,得到 1, 3, 4 float dist = length(a); // 向量长度 vec3 dir = normalize(b); // 归一化:方向不变,长度归一 float dotp = dot(a, b); // 点积:光照计算的绝对主角 vec3 crossp = cross(a, b); // 叉积:仅限 vec3,求正交向量 // swizzle:把分量当字母重排 vec4 v = vec4(1.0, 2.0, 3.0, 4.0); vec3 rev = v.zxy; // 3, 1, 2 —— 任意顺序任意长度 v.xw = vec2(0.0, 9.0); // 写入也支持 swizzle
写入方向的规矩只有一条:等号左边的 swizzle 不得重复同一通道。v.xy = v.yx; 合法,v.xx = vec2(1.0); 直接编译报错——同一个通道被写入两次,硬件没法执行。初学阶段另一类高频错误是把整数和浮点混进同一表达式,vec4(1, 0, 0, 1) 在严格的驱动上会拒绝隐式转换,请养成所有浮点字面量带小数点的习惯:vec4(1.0, 0.0, 0.0, 1.0)。
⚠️ 常见坑:swizzle 是"值拷贝"不是"引用别名"。
vec3 p = v.xyz;之后修改p不影响v。想改原向量必须写回v.xyz = p;。
矩阵:先当黑盒函数用
矩阵在入门阶段不必啃数学推导,把它当成"输入向量、输出向量的函数"即可用起来。mat4 乘 vec4,得到变换后的 vec4:
mat4 model = mat4(1.0); // 单位阵:什么都不变 mat4 rotY = mat4( cos(a), 0.0, -sin(a), 0.0, 0.0, 1.0, 0.0, 0.0, sin(a), 0.0, cos(a), 0.0, 0.0, 0.0, 0.0, 1.0 ); vec4 worldPos = rotY * vec4(0.0, 0.0, -5.0, 1.0); // 绕纵轴旋转一个点
三件事必须知道。其一,矩阵构造按列填——上面代码的每一行其实是矩阵的一列,这是 GLSL 列主序存储的直接体现,HLSL 恰好相反,第 8 章会对照。其二,乘法顺序有意义,model * view * proj 与 proj * view * model 是两个不同的函数,习惯写法是"先模型后观察再投影",即 proj * view * model * v。其三,mat3(model) 能从 mat4 抠出左上角的三阶部分,法线变换常用它。
// 实战里最常见的写法:三个矩阵合成一个,每顶点只做一次乘法 uniform mat4 uModel; uniform mat4 uView; uniform mat4 uProj; // uMVP = uProj * uView * uModel; 在 CPU 侧预先算好再上传更省 vec4 clipPos = uMVP * vec4(aPos, 1.0);
矩阵乘法本身在 GPU 上不便宜,能在外面合并就别在着色器里现算——这也是第 9 章优化思路的预演。
精度限定符:移动端的隐形开关
桌面平台上 float 就是单精度浮点,没什么可选。移动端(OpenGL ES 与 WebGL 的移动实现)却提供三档精度:highp 全精度、mediump 半精度、lowp 更低。片元着色器里省下的每一次带宽与寄存器都会直接兑换成功耗与帧率,所以移动项目默认在片元头部声明:
precision mediump float; // 本着色器内未标注的 float 均为半精度 // 个别关键计算单独升精度: highp vec4 clipPos = uMVP * vec4(aPos, 1.0);
经验法则:位置与矩阵相关计算用 highp,颜色与 UV 这类视觉容忍度高的数据用 mediump 就够,lowp 留给颜色这类值域窄的场合。精度不足的典型症状是 UV 在大纹理上出现色带与抖动——遇到时先怀疑精度档位。
本节要点回顾
- 类型即硬件:
vec4原生对应四通道运算单元,标量反而少用,float是绝对主力; - 构造三式:全分量、单标量填充、向量拼接,字面量永远带小数点;
- swizzle 规矩:读任意重排、写不重复,且是值拷贝语义;
- 矩阵黑盒用法:列主序、乘法有序、能合并先合并,
mat3(model)抠法线矩阵; - 精度分档:移动端片元默认
mediump,位置计算升highp。
类型就绪,下一节补齐程序结构的另一半:控制流、函数,以及决定数据去向的存储限定符。