1.1 渲染管线全景:一个三角形怎么被画出来
1.1 渲染管线全景:一个三角形怎么被画出来
本节摘要:渲染管线是 GPU 把三维顶点数据加工成屏幕像素的固定流程。本节跟着一个三角形走完整条流水线,弄清每个加工站的输入输出,并跑通一对最小的顶点与片元着色器——它们分别接管流水线中"算位置"和"算颜色"的两站。
学习目标
读完本节,你应当能够:按顺序说出渲染管线的主要阶段及各自职责;解释顶点着色器与片元着色器在其中的位置;看懂一段最小着色器代码并知道它何时被 GPU 执行;区分"每顶点执行"与"每片元执行"这两种完全不同的粒度。
先跟一次完整的旅程
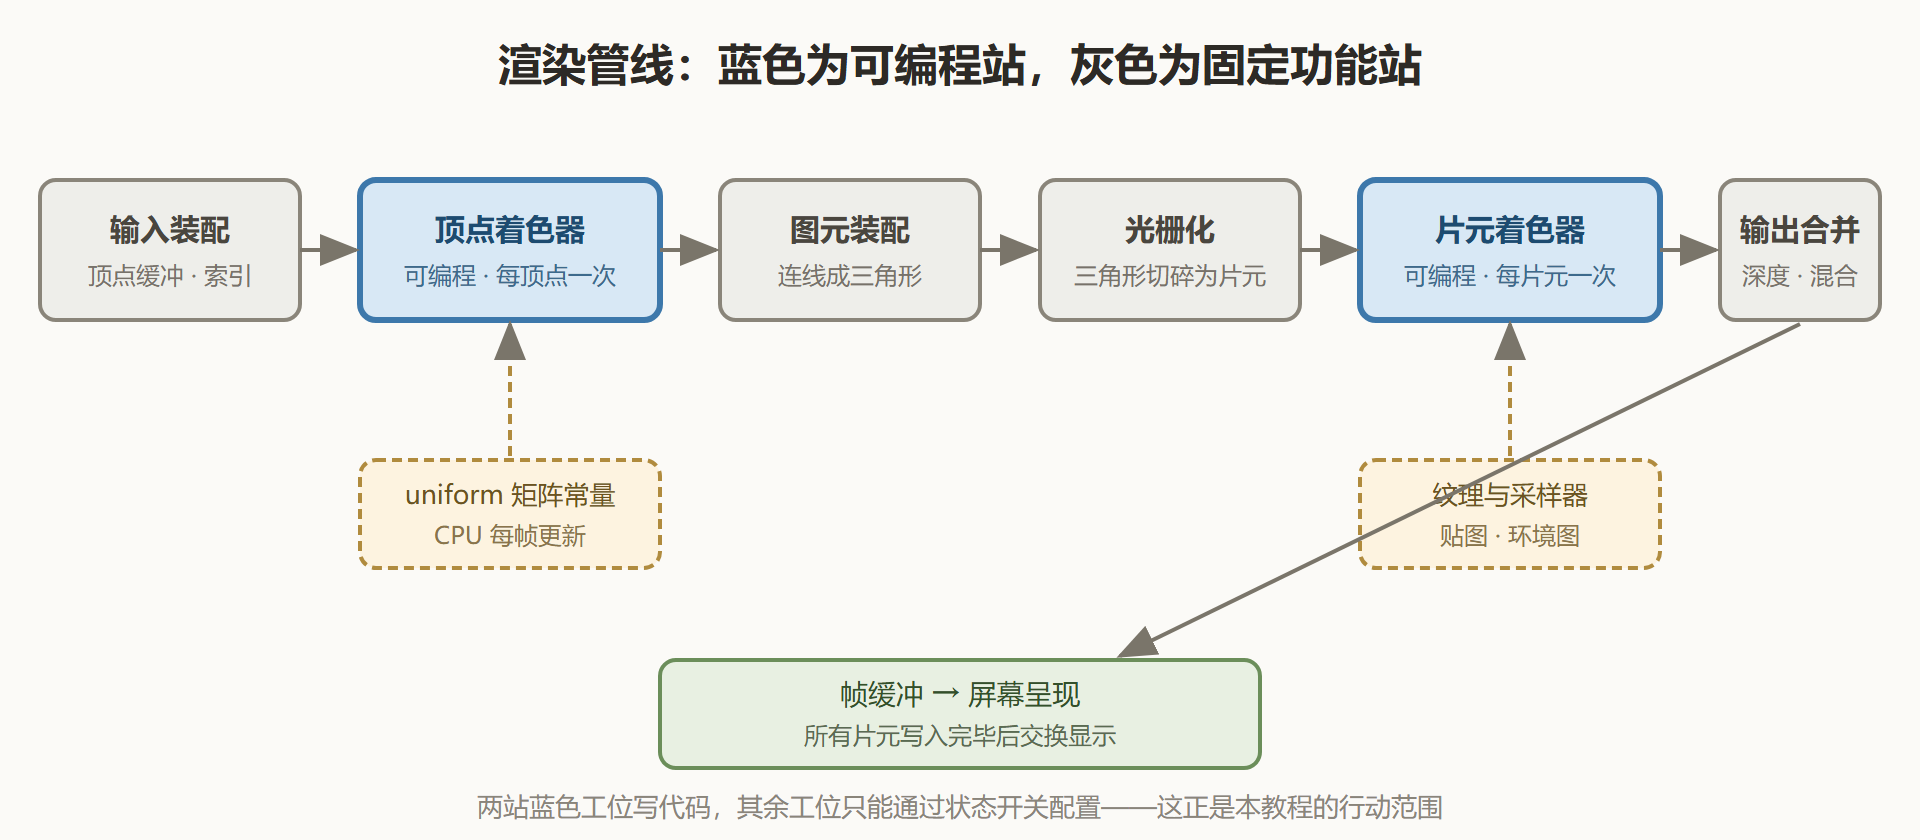
假设 CPU 内存里躺着这样的数据:三个顶点,每个带一个三维坐标。现在要把它们画成屏幕上一枚实心三角形。整个过程由渲染管线接管,数据依次经过以下加工站。
输入装配。CPU 事先把顶点数据塞进 GPU 可见的缓冲区,并告诉 GPU"每顶点 读几个 float、偏移多少"。这一步像把原料摆上传送带,本身不做计算。
顶点着色器。流水线上第一个可编程站。GPU 为每个顶点启动一次你写的程序——三个顶点就是三次并行执行。它的工作是把模型局部坐标乘上矩阵,变换到裁剪空间,顺便把 UV、法线等属性打包传递。注意它的视野:每次执行只能看到当前这一个顶点,看不见邻居。
图元装配。固定功能站。按照 CPU 下发的图元拓扑(三角形列表、三角形带等),把变换后的顶点组装成完整图元。三个顶点在此刻才真正"连成"一个三角形。
光栅化。固定功能站,也是整条流水线的分水岭。它把三角形覆盖的每个像素格子找出来,为每个格子生成一个"片元"——可以理解为候选像素,携带插值后的坐标与属性。屏幕上一百个像素被这个三角形盖住,片元着色器就要跑一百次。顶点阶段与片元阶段的执行次数相差如此悬殊,根子就在这里。
片元着色器。第二个可编程站,也是效果创作的主战场。每个片元独立执行一次程序,输出一个颜色。法线贴图、光照、程序化图案全在这一站发生。它同样看不见邻居——每个片元只知道自己的插值属性。
输出合并。固定功能站。片元的颜色并不直接上屏:先过深度测试(被更近的几何体挡住的片元在此丢弃),再做透明混合,最后写入帧缓冲。所有图元处理完,帧缓冲被送到屏幕。
图:渲染管线阶段与可编程边界
最小可跑的着色器对
概念落地的最好方式是代码。下面这对 GLSL 程序什么都不做花活,只把一个带颜色的三角形画出来,但管线两端的可编程站各占一个。先看顶点着色器:
// 最小顶点着色器:每个顶点执行一次 #version 330 core layout (location = 0) in vec3 aPos; // 输入装配站送来的顶点坐标 uniform mat4 uMVP; // CPU 每帧传入的变换矩阵 void main() { gl_Position = uMVP * vec4(aPos, 1.0); // 变换到裁剪空间,交给图元装配 }
逐行对应到管线:aPos 的值来自输入装配站摆好的顶点缓冲;gl_Position 是内置输出,写完它,这个顶点的使命就结束了,结果流向图元装配。uMVP 不随顶点变化,属于"旁路补给",由 CPU 在绘制前上传。再看片元着色器:
// 最小片元着色器:被三角形覆盖的每个片元执行一次 #version 330 core out vec4 FragColor; // 输出:一个 RGBA 颜色 uniform vec4 uColor; // 整个三角形共用的颜色 void main() { FragColor = uColor; // 直接输出,交给输出合并 }
GLSL 的长相接近 C,但关注点完全不同:没有 malloc、没有文件读写、没有循环依赖外部的状态——它是一段"纯函数",输入确定的属性,输出确定的位置或颜色。把它接进渲染环境的大致步骤是:编译两段源码、链接着色器程序、填充顶点缓冲、上传矩阵与颜色、发起绘制调用。在桌面 OpenGL 里这几步对应 glGenBuffers、glShaderSource 等接口;在引擎里则被模板封装掉,你只需要粘贴这两段代码。
⚠️ 常见坑:
#version必须是着色器源码的第一行,前面连空行都不能有,否则驱动按旧版本语法解析,报出的错误往往指不到真正的病灶。
CPU 与 GPU 在一次绘制里的分工
draw call 的真实含义值得单独说清。CPU 侧调用绘制接口,并不是"命令 GPU 立刻画完",而是把命令写进一个队列;驱动与 GPU 异步消化这个队列。所以 CPU 提交一千次绘制可能只花微秒级时间,GPU 是否来得及画完是另一回事——这也解释了为什么性能问题分"CPU 受限"与"GPU 受限"两类,第 9 章会专门展开。
另一个隐含约定:着色器程序在绘制前必须处于"已链接"状态,uniform 值在上传后保持不变直到下次修改。也就是说,着色器代码本身没有"何时执行"的概念——执行时机完全由管线调度,你写的只是"每次执行时做什么"。
三个高频疑问
问:光栅化这么关键,为什么偏偏它不可编程? 因为它是纯几何搬运:判断哪些像素被三角形覆盖、按面积权重分摊属性。这件事高度规则、毫无变化,做成专用电路比通用计算快几个数量级。可编程的价值在"因需求而异"的计算上——管线设计者把规则的留给硬件、多变的留给程序员,是性能与表达力的精确切分。
问:顶点着色器执行时能看到整个三角形吗? 看不到,也正因如此它才能疯狂并行。每次执行只见一个顶点的属性,三角形的存在感要等图元装配站才出现。这个约束反过来是保证:既然顶点之间零依赖,GPU 就能任意的乱序、并行地处理百万顶点。想在顶点间共享信息,要么靠 CPU 预计算,要么靠计算着色器另起炉灶。
问:片元着色器一定比顶点着色器重要吗? 教程篇幅确实偏向片元侧,但"重要"取决于瓶颈在哪。极端例子:粒子系统里每个粒子只有几个像素,顶点着色器反而执行得更频繁;CAD 类应用里几何量巨大,顶点侧经常先饱和。判断谁重要永远回到 9.1 章的方法——测量,而不是感觉。
本节要点回顾
- 流水线视角:输入装配、顶点着色器、图元装配、光栅化、片元着色器、输出合并,顺序不可颠倒;
- 两种可编程站:顶点着色器每顶点一次、片元着色器每片元一次,执行数量由几何在屏幕上的覆盖面积决定;
- 最小代码对应关系:
gl_Position通向图元装配,片元的out vec4通向输出合并; - 旁路资源:uniform 与纹理不随顶点或片元变化,是 CPU 注入管线的另一条通道;
- 异步执行:draw call 只是入队,CPU 与 GPU 的进度彼此独立。
下一节把这幅全景图切开来,仔细划分"你写代码的地方"与"你只能拧旋钮的地方"。