1.1 起源与演化:从MPP一体机到云原生数仓
1.1 起源与演化:从MPP一体机到云原生数仓
本节摘要:数仓架构的每次换代,都是被上一代的资源瓶颈逼出来的。本节沿着 shared-everything、shared-nothing MPP、云原生存算分离三个阶段梳理演化脉络,指出 MPP 一体机的三道天花板——扩容要搬数据、存储计算同生共死、运维成本随规模陡增。这三道天花板正是 Snowflake 在 2012 年前后成立时瞄准的靶心,也是理解后续所有章节的前提。
从一台机器的极限说起
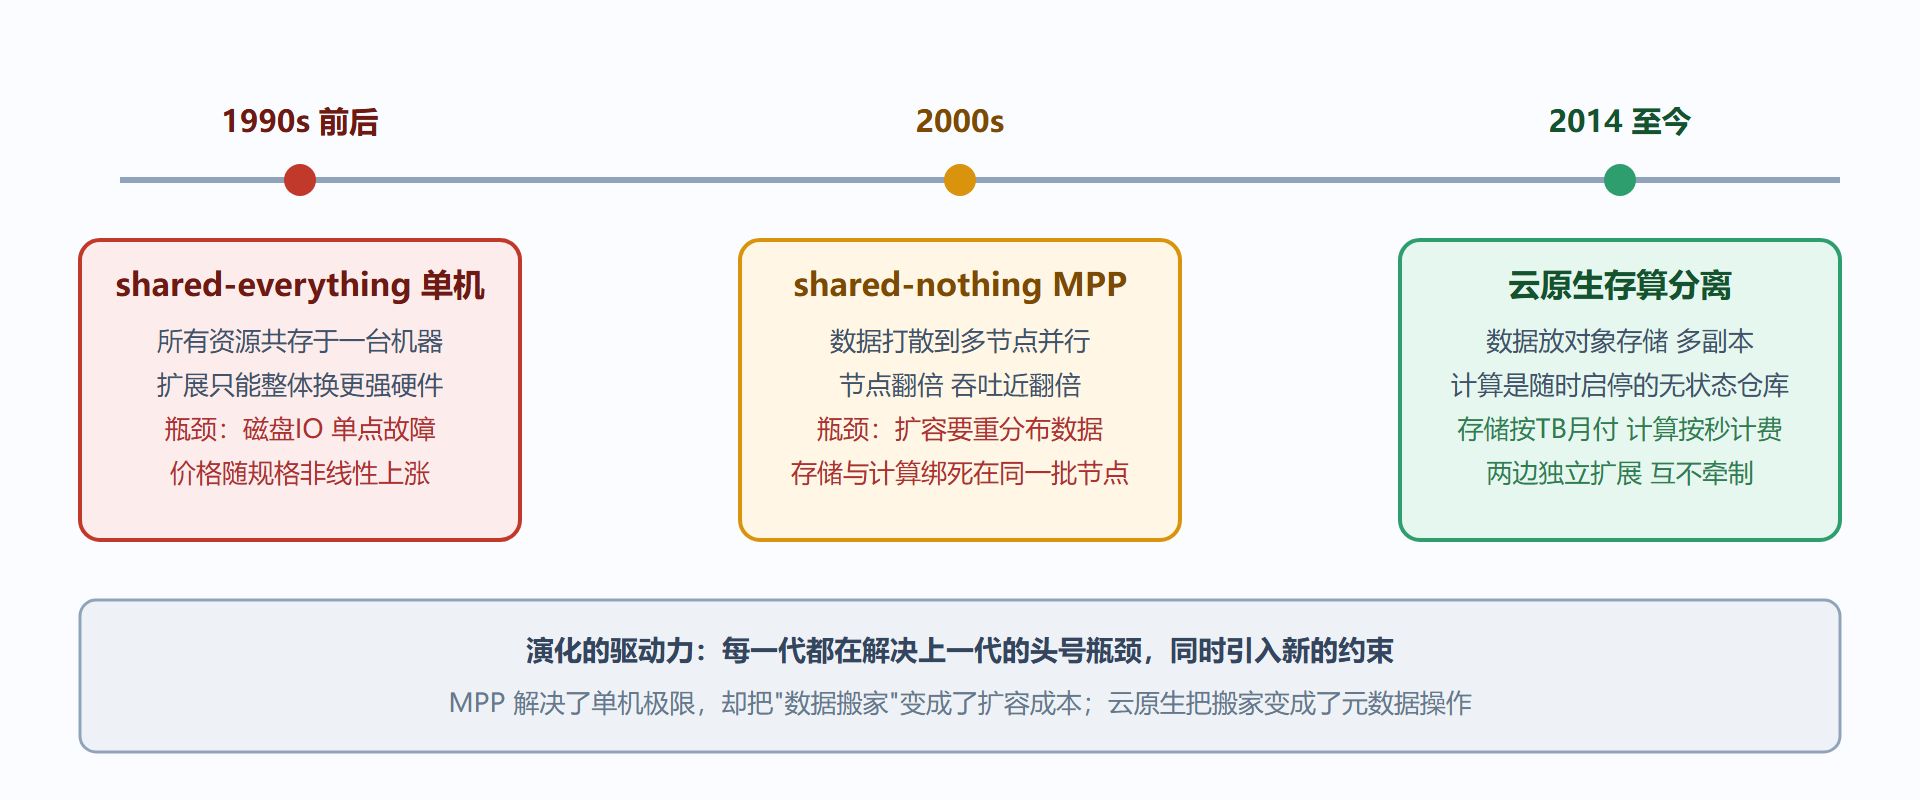
全册的故事起点在第1章,而本章的起点是这个判断:瓶颈换了,架构才会换。 上世纪九十年代的分析场景,单机数据库加几个报表就够了;数据量上了 TB,单机的磁盘 IO 和 CPU 先后见顶,第一代方案是把机器造得更大更贵——这就是 shared-everything:所有资源在一台机器里共享,扩展只能整体升级(Scale Up)。
这台"更大的机器"很快撞上新墙:高端小型机的价格随规格呈非线性上涨,而且单点故障足以让全公司分析停摆。厂商的应对是把数据打散到多台廉价节点上并行处理,每个节点只负责自己那份磁盘上的数据——这就是 shared-nothing MPP(大规模并行处理)架构,Teradata、Netezza、Greenplum 都属于这一脉。MPP 把线性扩展第一次带进了分析领域:节点翻倍,吞吐大致翻倍。
放到演化时间线上看,三代架构的接力关系是这样的:
图:数据仓库架构演化时间线
MPP 一体机的三道天花板
MPP 在其时代是巨大进步,但把镜头拉到云前夜的 2010 年前后,三道结构性天花板显形了。理解它们比记住 Snowflake 的卖点重要得多——因为 Snowflake 的每条特性几乎都是对着这三道墙凿的。
第一道:扩容等于数据重分布。 shared-nothing 要求每份数据有唯一归属节点。集群从 10 个节点扩到 12 个,哈希函数变了,海量数据要在节点间重新洗牌;这一过程通常伴随停机或降速,规划以周计。反过来缩容同样痛苦。数据仓库的容量规划因此变成赌博:为年末峰值按上限采购,其余十个月让机器空转。
第二道:存储与计算同生共死。 计算节点自带磁盘,意味着想加算力就得连带买存储,想留更多历史数据就得连带养算力。而分析负载的真实曲线是错峰的:加载集中在夜里,查询集中在白天,月末全高。两种资源绑定采购,注定有一边长期浪费。
第三道:运维专业度水涨船高。 分区策略、分布键、索引、统计信息,每一样都需要专人调优;调错的代价是全表扫描或数据倾斜。MPP 的"并行"红利,相当一部分被专职 DBA 团队的工资吃掉了。
云原生条件成熟:Snowflake 的选择
2012 年,三位来自 Oracle 的工程师创办 Snowflake 时,云基础设施恰好凑齐了三块积木:对象存储(如 Amazon S3)提供了近乎无限、按量计费、多副本免运维的存储;虚拟机提供了分钟级启动的算力;多租户与虚拟化技术让"每个客户一套独立资源"变得可行。他们的选择在当年颇为激进:不再模仿一体机在云上复刻 shared-nothing,而是彻底拥抱存算分离——数据全部落在对象存储,计算节点做成无状态、随时启停的虚拟仓库,两者之间只靠网络与元数据连接。
这个决定当时被质疑"对象存储延迟太高,做不了交互式分析"。后来的事实证明,列式微分区 + 多级缓存 + 惰性元数据(第4章、第6章展开)足以把热点查询压回秒级。2014 年 Snowflake 正式商用,2015 年起陆续补上数据共享、Time Travel 等能力,2020 年上市时"云数仓"已经从异端变成品类名。
💡 关键直觉:判断一个"云数仓"是不是真云原生,看它扩容时搬不搬数据。搬数据的,只是把一体机搬进了机房;不搬的,才是把数据真正放进了共享存储。
对照表:三代架构速查
| 维度 | shared-everything | shared-nothing MPP | 云原生存算分离 |
|---|---|---|---|
| 数据存放 | 本机磁盘 | 各节点本地磁盘 | 对象存储,多副本 |
| 扩容方式 | 整机升级 | 加节点并重分布数据 | 存储自动增长,仓库即时增减 |
| 存储与计算 | 绑定 | 绑定 | 解耦,独立计费 |
| 峰谷应对 | 无法应对 | 预留峰值容量 | 临时开仓库,用完挂起 |
| 典型运维量 | 中 | 高(分布键、重分布) | 低(免索引、免分区调优) |
| 故障域 | 整机 | 单节点 | 计算无状态,存储多副本 |
表里"免索引"三个字值得停留一下:传统数仓用索引换扫描速度,Snowflake 干脆不做索引,改为把扫描本身做到足够快(列存 + 微分区剪枝 + 缓存)。这个取舍在第6章会完整展开,这里先记结论。
易错点:三个流传很广的误读
⚠️ 误读一:Snowflake 是"云上的 MySQL"。 不是。它面向分析负载(OLAP),行级点查、高频小事务不是它的主场——这类负载请留在 OLTP 数据库。
⚠️ 误读二:存算分离等于"分布式数据库上云"。 区别在存储介质与状态归属:很多"云化"产品只是把本地盘换成云盘,数据仍归属计算节点;Snowflake 的数据归属对象存储,计算节点死了数据毫发无伤,换一批节点继续算。
⚠️ 误读三:MPP 已经过时。 也没有。对数据规模稳定、延迟要求极苛刻的自建场景,MPP 依然是选项;云原生赢在弹性与运维成本,不在单点性能极限。选型永远看负载,不看潮流。
本节要点回顾
- 演化驱动力:shared-everything 死于单机极限,shared-nothing 死于弹性,云原生赢在把"扩容"变成"元数据操作"。
- 三道天花板:扩容重分布、存储计算绑定、运维成本陡增——后续所有 Snowflake 特性都可以对应回这三条。
- 成立前提:对象存储、虚拟机、多租户三块积木在 2012 年前后同时成熟,缺一不可。
- 判断标准:真云原生的试金石是"扩容搬不搬数据"。
下一节我们拿着这张痛点清单,逐条对照 Snowflake 的特性与价值主张,看看每道墙是怎么被翻过去的。
问题:shared-nothing 与存算分离的判断标准到底是什么?
看数据的"归属权"。数据文件归属计算节点的本地盘,就是 shared-nothing;归属独立共享存储、计算节点只是无状态访客,才是存算分离。有些产品把云盘挂在虚拟机下自称分离,但云盘生命周期与虚拟机绑定,节点释放即数据消失,这不叫分离,只是把本地盘换了个放置位置。
问题:为什么 MPP 时代没有直接演进到云原生?
因为前提不成立。没有廉价、多副本、按量计费的共享存储,"分离"就无处安放数据;没有秒级虚拟机,计算的弹性无从谈起。技术形态从来不是单独进化的,是整个基础设施水位抬升后的重新组合。