1.2 独特特性与价值主张
1.2 独特特性与价值主张
本节摘要:上一节立起旧架构的痛点清单,本节逐条对照 Snowflake 的特性:多仓库共享同一份数据、按秒计费的弹性单元、免索引的自动数据组织、半结构化原生支持、跨账户零拷贝共享。每条特性都追一句"它替你省掉了什么",最后给出场景取舍表——哪些负载值得迁移,哪些留在原地更好。本节是全册特性的总目录,每一项都会在后续章节单独兑现。
拆解特性清单:每一条对应一个旧痛点
先补一句体系定位:1.1 讲的是"为什么要有 Snowflake",本节讲"它到底给了什么";第2章起这些特性会被逐一拆到机制层。特性清单很长,但抓主干只有五条。
特性一:多个仓库共享同一份数据。 传统数仓里,报表、即席查询、数据科学团队挤同一个实例,互相抢资源,或者提前切分多个副本系统。Snowflake 里同一份数据可以同时挂任意多个虚拟仓库:报表仓库、ETL 仓库、探索仓库各自独立伸缩、独立计费、互不阻塞。数据只有一份,不存在副本不一致的问题。这是"存算分离"在并发层面的直接兑现。
特性二:按使用付费,而不是按拥有付费。 仓库不用时自动挂起(auto-suspend),来了查询自动恢复(auto-resume);计费精确到秒(有最小计费时长)。对比一体机"买了就用不坏、闲着也折旧"的模式,这是成本模型的根本换轨。第3章会展开档位与多集群,第8章算总账。
特性三:免索引、免手工分区。 没有索引要建,没有分布键要选,没有分区函数要写。数据写入时自动切成约 16MB 的列式微分区,每个分区的 min/max 统计自动维护,查询时靠统计剪枝。代价是"扫描极快"代替"定位极快"——对绝大多数分析查询这是划算的交易,第4章与第6章给出机理与边界。
特性四:半结构化数据一等公民。 JSON、Avro、Parquet、XML 可以直接装进 VARIANT 列,无需预先定义模式;查询时用路径语法取值。ETL 里的"先建宽表再清洗"被压缩成"先落地、后建模"。第4章末节专门拆 VARIANT。
特性五:数据共享不用搬数据。 两个 Snowflake 账户之间共享一张表,底层文件一个字节都不复制——消费方读的就是提供方的元数据指针。第5章展开这套协议。
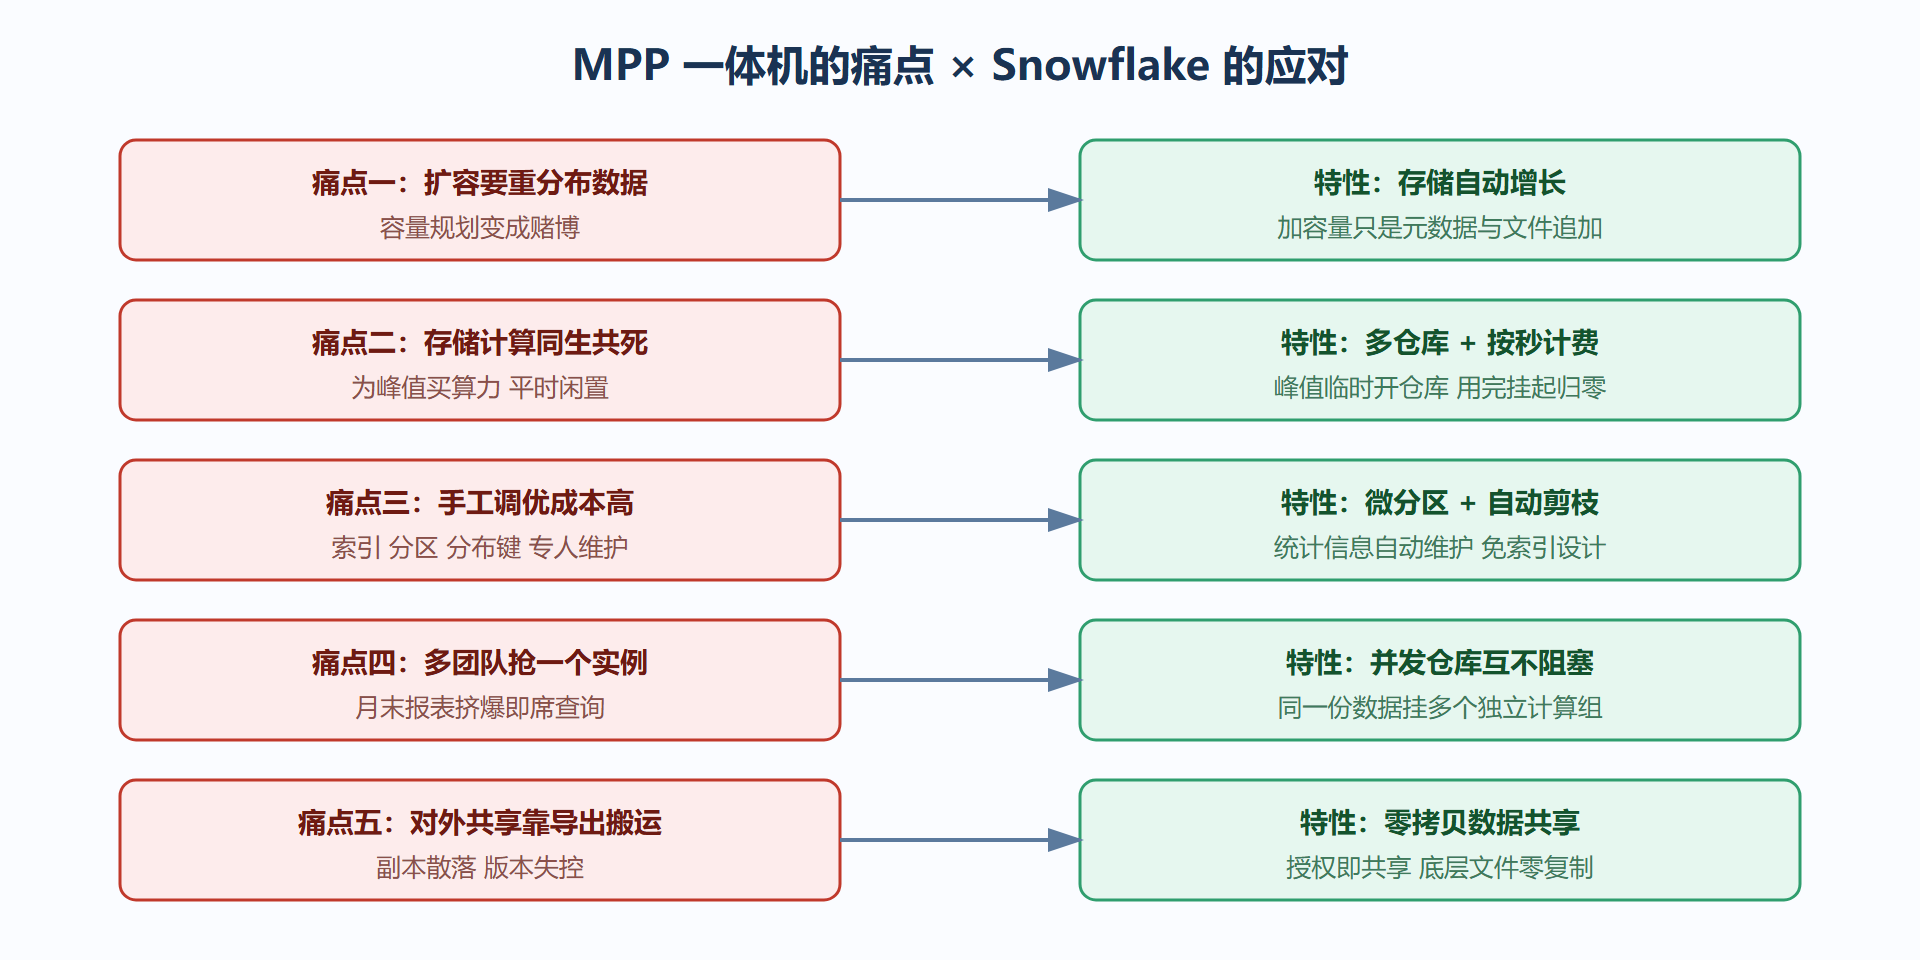
五条特性与 1.1 痛点的对应关系画成矩阵更直观:
图:旧痛点与Snowflake特性的对应矩阵
动手验证:体验"按使用付费"
特性读起来抽象,跑一条 SQL 就具体了。在试用账户里建一个最小仓库,观察它的计费状态变化:
-- 建一个最小的 XS 仓库(每小时 1 个 credit,按秒计费,有最小计费时长) CREATE WAREHOUSE demo_wh WAREHOUSE_SIZE = XSMALL AUTO_SUSPEND = 60 -- 空闲 60 秒自动挂起(秒数可自定) AUTO_RESUME = TRUE -- 有查询进来自动恢复 INITIALLY_SUSPENDED = TRUE;-- 创建时先不启动,不烧钱 -- 跑一条查询,仓库被自动唤醒 SELECT COUNT(*) FROM SNOWFLAKE_SAMPLE_DATA.TPCDS_SF10TCL.CUSTOMER; -- 查看这个仓库刚才消耗了多少 credit(ACCOUNT_USAGE 视图有几十分钟延迟) SELECT WAREHOUSE_NAME, START_TIME, CREDITS_USED FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_METERING_HISTORY WHERE WAREHOUSE_NAME = 'DEMO_WH' ORDER BY START_TIME DESC;
三个观察点:一是挂起状态下 CREDITS_USED 停止增长——闲置不烧钱,这在一体机时代不可想象;二是查询结束后大约 60 秒仓库自动挂起,无需任何人工操作;三是查询结果本身会被缓存 24 小时,同样的查询再跑一遍命中结果缓存,既不耗时也不计费(第6章细讲)。这一组行为合起来,就是"卖用量不卖机器"的具象化。
场景取舍:什么活适合交给它
特性清单看完了,价值判断才是选型的核心。下面这张表是无数迁移项目沉淀下来的经验边界:
| 工作负载 | 适合度 | 理由与注意点 |
|---|---|---|
| 企业级报表与月末结算 | 很适合 | 并发波动大,恰好吃弹性红利;配合多集群扛峰 |
| 即席探索与数据科学 | 很适合 | 免索引、直接查 JSON,试错成本极低 |
| ELT 转换管道 | 很适合 | SQL 表达转换 + 仓库按需扩档,吞吐可线性加码 |
| 日志与事件半结构化分析 | 适合 | VARIANT 原生支持;高频字段建议拉平成列(第4章) |
| 数据产品对外发布 | 适合 | 零拷贝共享天然适合数据变现(第5章) |
| 高频行级点查(OLTP) | 不适合 | 微分区扫描模型不擅长毫秒级单行检索 |
| 毫秒级缓存查询 | 不适合 | 走专门的缓存或 KV 服务更便宜 |
| 强约束高频小事务 | 不适合 | 它不是交易数据库,别错位使用 |
一句话归纳:读多写少、批量进出、并发波动、模式多变的分析负载,是它的主场;点查、事务、超低延迟缓存,是它的客场。 判断不了的时候,回到 1.1 的金句——它卖的是"用量",你的负载能不能在"用量"上占便宜,答案就在那。
⚠️ 常见坑:把 Snowflake 当 MySQL 用,是新手成本事故的高发源头。曾有团队把用户会话表放进 VARIANT 表高频点查,结果每个请求都触发全微分区扫描,账单与延迟双双失控。后来他们把会话迁去 KV 存储、只把分析快照留在 Snowflake,两边各归其位。
本节要点回顾
- 五条主干特性:多仓库共享数据、按秒计费、免索引自动微分区、半结构化一等公民、零拷贝共享——每条都对着旧架构的具体痛点。
- 价值主张的本质:把"拥有资源的成本"换成"使用资源的成本",架构与商业模式互为因果。
- 场景边界:分析负载是主场,OLTP 式负载是客场;错位使用既慢又贵。
特性清单已经铺开,但"多仓库共享数据"背后一定有个东西在协调它们——下一章我们拆开三层架构,看看这套系统到底由哪几块组成。
问题:特性这么多,最该先吃透哪一条?
多仓库共享数据。它是存算分离最直观的落地,也是与旧世界差异最大的使用习惯——拆分仓库、按负载配置档位、互不阻塞,这些动作在传统数仓里要么做不到、要么代价高昂。后面三章的成本与性能优化,几乎都建立在"仓库是独立单元"这个事实上。
问题:"按使用付费"有没有隐藏的坑?
有:使用的是谁要看得清。自动唤醒的仓库、无服务器功能、跨区复制都在"使用"的范畴里,失控的定时任务与频繁唤醒会把弹性红利吃回去。第8章的资源监控器与归因方法就是为这个准备的。