2.1 架构分层与逻辑模型
2.1 架构分层与逻辑模型
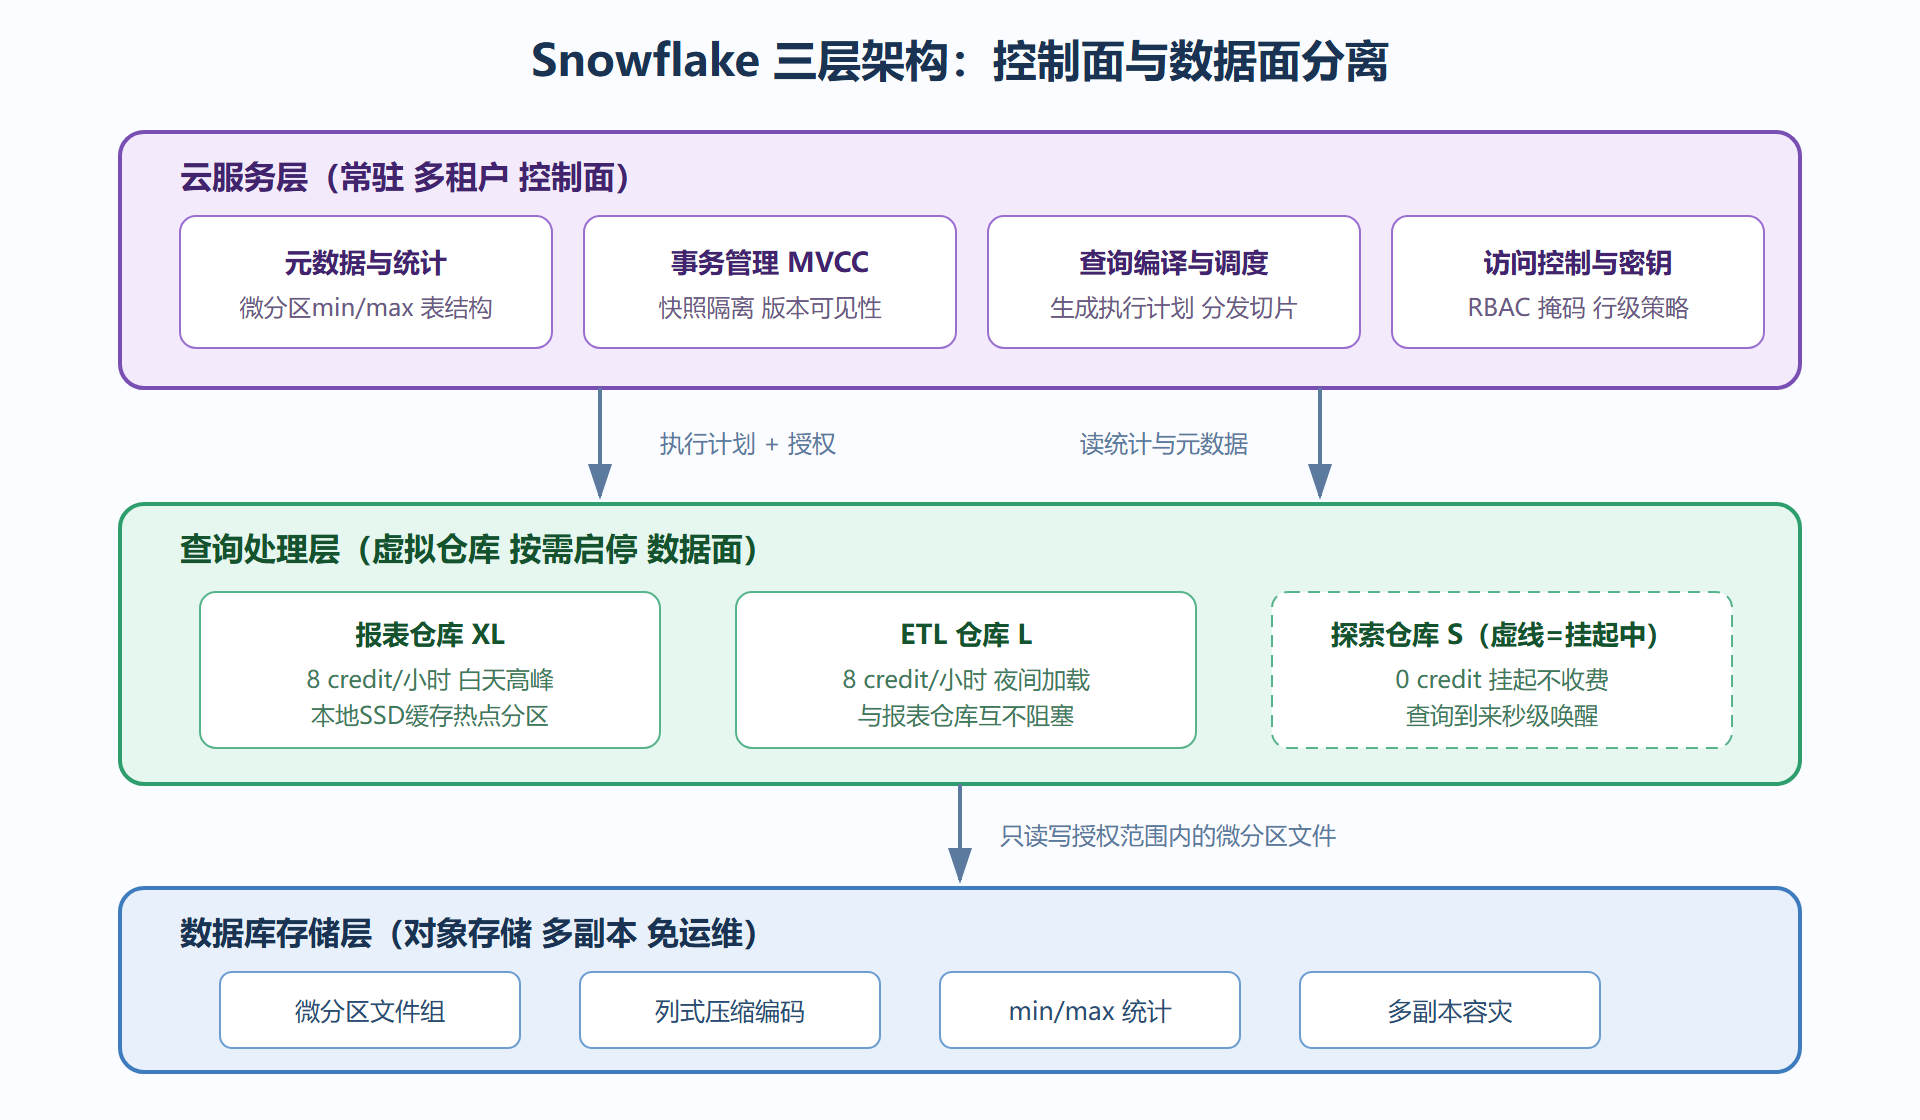
本节摘要:本节给出全册最重要的一张图——存储、计算、云服务三层架构的逻辑模型。要点有三个:数据以微分区文件形式落在对象存储,没有任何计算单元真正"拥有"它;计算是按需启停的无状态虚拟仓库;云服务层作为常驻控制面,把元数据、事务、调度、安全收敛为一组共享服务。分层不是画图好看,它直接决定了故障域、计费边界与运维边界。
三层各管什么
先把分层逻辑接上 1.1 的结尾:既然数据归属共享存储、计算做成无状态,那总要有个"中间人"知道数据在哪、谁能访问、事务推进到哪——这个中间人被单独拎出来成为第三层。于是 Snowflake 的架构比"两层"多长出了一层:
- 数据库存储层(Database Storage):负责把数据变成对象存储里的微分区文件,并维护其多副本与生命周期。它只管"存得下、丢不了、读得出",不懂 SQL。
- 查询处理层(Query Processing / Compute):由虚拟仓库组成的无状态计算集群,负责真正执行扫描、连接、聚合。它只管"算得快",不保存任何持久状态。
- 云服务层(Cloud Services):一组常驻多租户服务,管理元数据、事务、查询编译与调度、访问控制、优化统计。它是大脑,也是"免运维"体验的来源。
图:存算分离三层架构总览
用一次查询把三层串起来
分层模型最怕背完就忘,我们用一条具体查询把它走一遍:
SELECT region, SUM(amount) AS total FROM orders WHERE order_date >= '2024-01-01' GROUP BY region;
这条 SQL 进入系统后的旅程分三段。第一段在云服务层:语法解析与语义检查(表是否存在、你有没有权限)、从元数据服务拿到 orders 表的分区清单与 min/max 统计、结合 order_date 的过滤条件生成"只需读哪些微分区"的执行计划。这一段不占用任何仓库资源,因此不烧 credit。第二段在查询处理层:执行计划被切成并行切片发给报表仓库的计算节点,各节点从对象存储拉取自己负责的微分区(命中本地 SSD 缓存则免网络),完成扫描、过滤、聚合,最后汇总结果。第三段回到云服务层:结果集缓存 24 小时,供完全相同的查询直接复用。
三个值得咀嚼的细节。其一,第一段与第三段发生在常驻的云服务层,这就是为什么"不跑查询也有元数据操作"的少量开销,以及为什么元数据操作按秒计费但费用可忽略。其二,计算节点不持久保存任何东西——节点故障,云服务层把它承担的切片重新派给别的节点即可。其三,同一份数据可以被 ETL 仓库与报表仓库同时读取而互不知晓,因为"谁在读"的仲裁在云服务层,不在存储层。
控制面与数据面:一个通用的复述框架
如果你需要向没有 Snowflake 背景的同事解释这套架构,可以借用"控制面/数据面"的通用框架:控制面决定"做什么、谁可以做、数据在哪",数据面负责"把它算出来"。云服务层是控制面,虚拟仓库是数据面,对象存储是两边共同引用的事实源。
这个框架能顺带解释很多现象:
| 现象 | 控制面/数据面解释 |
|---|---|
| 挂起的仓库不收费 | 数据面停机,控制面与存储仍在(后两者本就不按仓库计费) |
| 仓库重建极快 | 数据面无状态,"新仓库"只是新的计算资源组,无数据迁移 |
| 权限变更立即生效 | 授权在控制面检查,与数据面无关 |
| 查询卡住先看执行计划 | 编译与调度都出自控制面,问题常在计划或统计质量 |
| 克隆表瞬间完成 | 只复制元数据引用,底层文件共享(第4章展开) |
易错点与边界
⚠️ 分层不是物理隔离。 三层是逻辑职责划分;云服务层与查询处理层都运行在云厂商的虚拟机之上。别把"层"理解成机房里的三排机柜。
⚠️ 对象存储慢的问题确实存在,答案在缓存。 直接从对象存储拉数据的延迟毫秒到几十毫秒不等,热点数据靠仓库节点的本地 SSD 缓存兜住。这也是为什么"刚跑完的查询再跑一遍特别快"——数据缓存还热着(第6章讲缓存的三级结构)。
⚠️ 云服务层不是无限免费。 大部分云服务用量包含在 credit 价格里不单独收费,但元数据操作类的无服务器功能(如部分后台维护任务)会单独计费。日常分析几乎感知不到,大规模自动化作业时要留意。
本节要点回顾
- 三层职责:存储层管"存",计算层管"算",云服务层管"协调"——免运维体验来自第三层。
- 无状态计算:节点可随时启停与替换,是弹性与高可用的共同根源。
- 控制面/数据面:向任何人复述这套架构的最短框架。
- 计费边界:仓库按启停计费;云服务大部分包含在单价内,存储按容量月费。
下一章我们专攻中间那层:虚拟仓库的档位、多集群与弹性伸缩机制。
分层视角的三个追问
问题:既然分层了,三层可以独立扩容吗?
可以,而且这正是分层的红利。存储随数据自动增长,计算随仓库档位与集群数伸缩,云服务层由平台按负载调度——三层各自面对不同的增长曲线,互不牵制。容量规划从"预估整机规格"变成"只预估每层的增长"。
问题:同一份数据同时被多个仓库读写,会不会读到中间状态?
不会。可见性由云服务层的事务管理裁定(本节末尾与 2.2 展开 MVCC),每个语句基于一致的快照读取;多仓库并发读到的都是"某个时刻的正确状态",不存在半新半旧的行。
问题:跨层调用都走网络,延迟怎么控?
靠统计驱动的"少读"而不是"读快"。执行计划先在元数据层完成剪枝,只把必要分区送进计算;热点分区由仓库本地缓存兜住。网络延迟没有消失,但被"读得少、读得热"摊薄了——这也是第6章性能方法论的物理起点。
分层模型的一次实战复述
向团队转述架构最有效的办法,是让每个人用自己的话把一次查询过一遍三层。给出一段验收用的复述模板:这条查询先到云服务层做权限判定与计划编译,依据的是元数据里的分区统计;计划派给哪个仓库、占多少并发槽位,决定了它排队还是立即执行;执行时计算节点只读被授权且被剪枝后的分区文件;结果回云服务层进缓存。复述里如果出现"数据库把数据发给计算节点再汇总"这类 shared-nothing 时代的表述,说明分层模型还没立起来——数据没有"主节点",每个计算节点都是对等的数据访客。
这个练习的价值超出培训:排障时的沟通效率取决于团队是否共享同一张架构图。当有人报告"库慢了",第一反问应该是"慢在哪一层"——编译、排队还是执行,而不是对着单一指标猜测。分层模型因此不只是一页架构图,它是这个平台一切协作语言的地基,也是后续三章各自展开的挂靠点:计算层走向第3章,存储层走向第4章,控制面的鉴权走向第7章。