2.2 云服务层:元数据、事务与查询调度
2.2 云服务层:元数据、事务与查询调度
本节摘要:云服务层是三层架构中最常被忽略、却承担"数据库感"的一层:没有它,对象存储只是文件堆,虚拟仓库只是裸算力。本节拆解它的四个岗位——元数据与统计管理、事务(MVCC)、查询编译调度、访问控制,并回答两个实操问题:为什么"免运维"不是宣传话术;云服务层什么时候才会单独收钱。
云服务层为什么存在
接着 2.1 的分层往下钻。存算分离之后,系统面对一个新问题:数据在对象存储里是一堆无意义的文件,谁来赋予它们"表"的身份?答案是云服务层——一个常驻的、多租户共享的服务集合。你可以把它理解成这家数据库的"总部机关":一线仓库负责干活,总部负责登记造册、排班调度、审批权限。
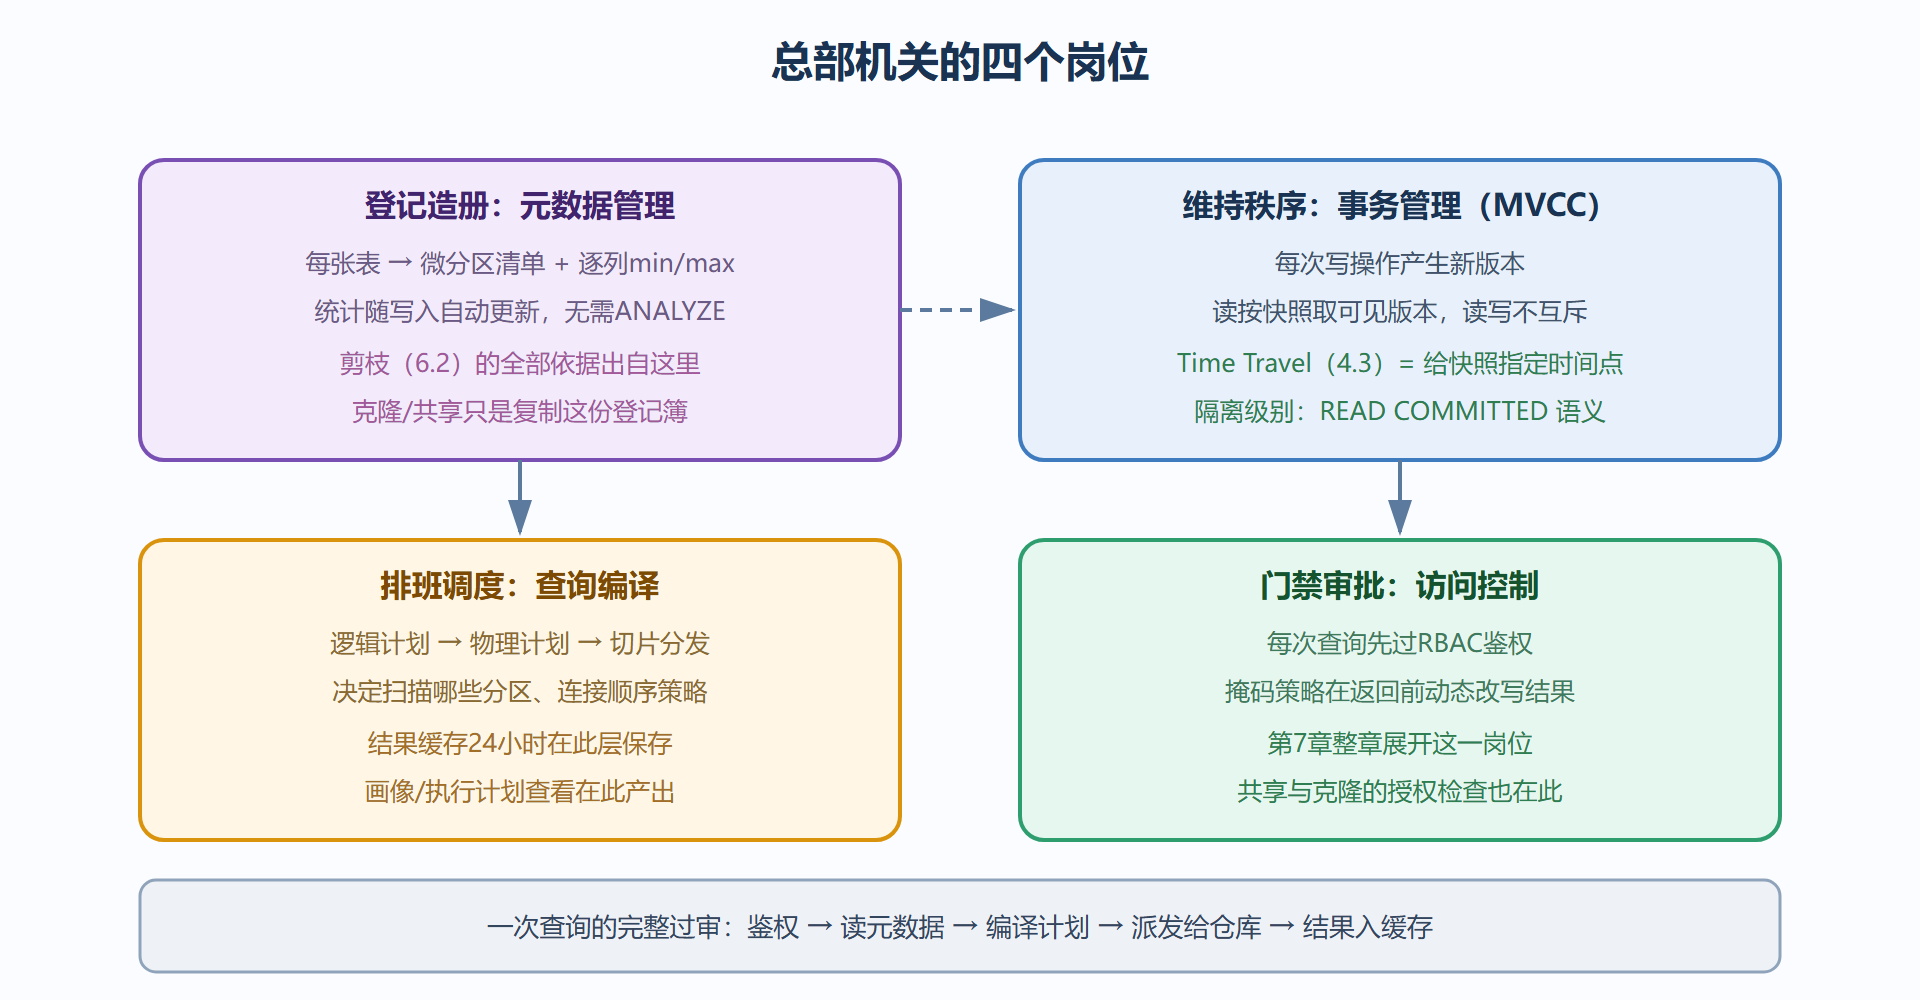
四个岗位的分工如下表:
| 岗位 | 职责 | 你能感知到的行为 |
|---|---|---|
| 元数据管理 | 表结构、微分区清单与 min/max 统计 | 建表秒级完成;剪枝决策的依据来源 |
| 事务管理 | MVCC 版本链、快照隔离 | 读写互不阻塞;Time Travel 可回溯 |
| 查询编译调度 | 计划生成、切片分发、结果缓存 | 相同查询秒回;执行计划可视化 |
| 访问控制 | RBAC 鉴权、掩码与行级策略 | 权限即时生效;敏感列自动脱敏 |
图:云服务层四大岗位与一次查询的交互
"免运维"的机理:三个被吸收的运维岗位
宣传里说 Snowflake 免运维,机理恰恰在云服务层。对照传统数据库三位 DBA 的日常工作:
第一位:调统计的。 传统库要定期跑 ANALYZE 收集统计信息,统计过期则查询计划劣化。云服务层的元数据服务随每次写入同步更新微分区统计——没有"统计过期"这个状态存在。
第一位之外:管事务日志与恢复的。 MVCC 版本链、崩溃恢复、检查点,全部由事务管理服务自动处理;用户视角里不存在"实例崩溃后回放日志"这件事——仓库无状态,挂了重开即可。
第三位:分区与索引的。 4.2 讲过:分区自动切、统计自动记。人工操作被压缩到只剩聚簇键这一项可选配置。
所以"免运维"的准确含义是:运维职责从"你的团队"转移到了"平台的服务",不是运维凭空消失了。你的团队保留的运维项是:权限模型设计(第7章)、仓库与成本管理(第3、8章)、数据建模本身。
事务模型:MVCC 的一分钟版本
云服务层的事务管理使用多版本并发控制(MVCC),三个要点够用了:
- 写不覆盖旧版本:与 4.2 的微分区不可变性互为表里,每次 UPDATE 产生新版本行;
- 读看快照:语句开始时确定一个版本基线,执行期间别人提交的修改不影响本语句的可见性(READ COMMITTED 隔离级别下的语句级快照);
- 读写不互斥:报表长查询读旧版本,ETL 同时写新版本,谁也不等谁——传统数仓"加载窗口必须避开查询高峰"的约束在这里不存在。
这解释了一个此前没有解释的现象:为什么 4.1 里 Snowpipe 可以在 BI 查询高峰时持续载入数据而不影响报表——加载生成新版本,报表读的是各自一致的快照。
云服务层什么时候收钱
日常感知不到,不代表不存在。计费规则分三档:
- 绝大多数用量免费:查询编译、元数据管理、访问控制判定、结果缓存,费用已折算进 credit 单价;
- 元数据操作小额计费:DDL 类操作(建表、克隆、共享授权)按资源消耗以秒计费,金额通常小到可以忽略,但高频率的自动化脚本要留意累计值;
- 无服务器功能单独计费:自动聚类、物化视图维护、部分 Task(未绑定仓库时)、Search Optimization 构建——它们消耗的是平台的算力,账单单列,第8章的资源监控器对这类费用同样有效。
一个实用习惯:月末对账时把"计算、存储、数据传输"之外的小额项归到"平台服务"一类单独观察,一旦它超过总账单的几个百分点,通常意味着某个自动化脚本在疯狂做元数据操作——比如循环里反复 CREATE OR REPLACE 表。
本节要点回顾
- 四大岗位:元数据、事务、编译调度、访问控制——"数据库感"的全部来源。
- 免运维机理:统计收集、事务恢复、分区索引三类运维被服务化吸收;你的团队剩权限、成本、建模。
- MVCC 三要点:写不覆盖、读看快照、读写不互斥;Time Travel 是它的直接衍生品。
- 计费三档:编译鉴权免费;DDL 按秒小额;无服务器功能单列账单。
三层的地图与最特殊的一层都讲透了。下一章进入计算侧的主角:虚拟仓库的档位、集群与弹性。
多租户下的隔离问题
云服务层是共享的,读者自然会问:我的查询计划、我的元数据会不会被邻居看见或拖慢?平台的答案是"逻辑隔离加资源配额":每个账户的元数据与缓存空间相互隔离,查询编译由多租户服务池承载并按负载弹性扩容。日常负载下邻居效应几乎不可感知;极端情况下平台会做负载保护。理解这一点的实用意义是:云服务层的抖动不需要你调参,你该管的仍是仓库侧与查询侧。
云服务层与存储层的一致性
元数据是存储层文件的事实登记簿,两者的一致性由服务层保证:新微分区写入成功后才在元数据可见,删除是先改元数据再后台回收文件。这解释了两个现象:其一,"提交成功"的加载立刻可查——可见性以元数据为准,不等文件整理;其二,删除空间回收有滞后——元数据先行,物理文件的后台清理在其后,账单上的容量下降因此有几天延迟,不必当作异常。
云服务层故障会怎样
这是分层架构的经典压力测试问题。查询处理层挂掉,损失的是算力,重开仓库即恢复;云服务层如果不可用,所有查询无法编译与鉴权,整个账户暂停读写——所以它是平台可用性承诺的核心部件,由多副本服务集群承载。你能做的对应预案与 3.2 相同:跨区复制与故障转移组,把"控制面也不可用"的区域性风险转移出去。
统计信息的"新鲜度"问题
传统数据库调优的第一课是"统计要新鲜",云服务层把这门课取消了还是改写了?答案是改写了:微分区统计随写入同步登记,不存在"批量统计过期"的窗口。但仍有一种劣化路径存在——数据的分布形态随时间漂移,比如按月到达的数据在表里逐渐失去时间局部性,每个分区的统计区间越拉越宽,剪枝效率缓慢下滑。这不是统计过期,是物理布局劣化,对应的药方是聚簇键(6.2)而不是重新分析。分清"统计过期"与"布局劣化",能避免在错误的方向上跑维护作业。
编译服务与计划复用
查询编译是 CPU 密集的活,云服务层对相同形态的查询有编译结果的复用机制:同样的参数化语句只需重编译参数部分。这对应用的启示与结果缓存类似但更宽松——结果缓存要求"数据也没变",编译复用只要求"语句形态相同"。因此把报表 SQL 写成参数化形态,即使数据每分钟都在变,编译开销也能摊薄。高频调用的应用侧查询尤其受益,这是 5.4 接入纪律在性能侧的注脚。