4.1 数据摄取与加载:COPY INTO与Snowpipe
4.1 数据摄取与加载:COPY INTO与Snowpipe
本节摘要:数据进入 Snowflake 有两条正门:COPY INTO 批量加载,由人或调度器触发,仓库计费;Snowpipe 持续加载,由对象存储事件自动触发,按实际用量计费,延迟约一分钟。本节先补齐"暂存区(Stage)"这块概念跳板,再对照两条路径的语法、计费与选型标准,最后给出一个混合加载的完整案例。
别以为加载只是"导入数据"
承接上一章:仓库解决了"算力从哪来",存储解决了"数据放哪",但数据怎么从外面进来仍是一个独立问题。传统数仓的导入是重工程——写 ETL 脚本、配调度、盯失败重跑;Snowflake 把它简化成两个动词:把文件放到暂存区,然后 COPY。先认识暂存区。
暂存区(Stage)是文件的"候车厅"。 任何要进入表的数据先以文件形式停在这里:
- 表暂存区:每张表自带,存单表小批量文件,无需建任何对象;
- 用户暂存区:每个用户自带,存个人临时文件;
- 命名暂存区:显式创建的数据库对象,可授权给他人、可挂通知集成,是生产环境的标配。
-- 创建一个指向外部对象存储的命名暂存区 CREATE STAGE my_s3_stage URL = 's3://my-company-bucket/orders/' STORAGE_INTEGRATION = my_s3_int; -- 预先授权的存储集成,避免把密钥写进 DDL
路径一:COPY INTO 批量加载
COPY INTO 是最常用的加载语句,形态是"从暂存区把文件倒进表里":
-- 基本形态:从命名暂存区加载 CSV COPY INTO orders FROM @my_s3_stage FILE_FORMAT = ( TYPE = CSV FIELD_OPTIONALLY_ENCLOSED_BY = '"' SKIP_HEADER = 1 NULL_IF = ('', 'NULL') ) PATTERN = '.*orders_2024.*[.]csv' -- 只挑匹配的文件 ON_ERROR = 'ABORT_STATEMENT'; -- 出错整体中止,便于重跑
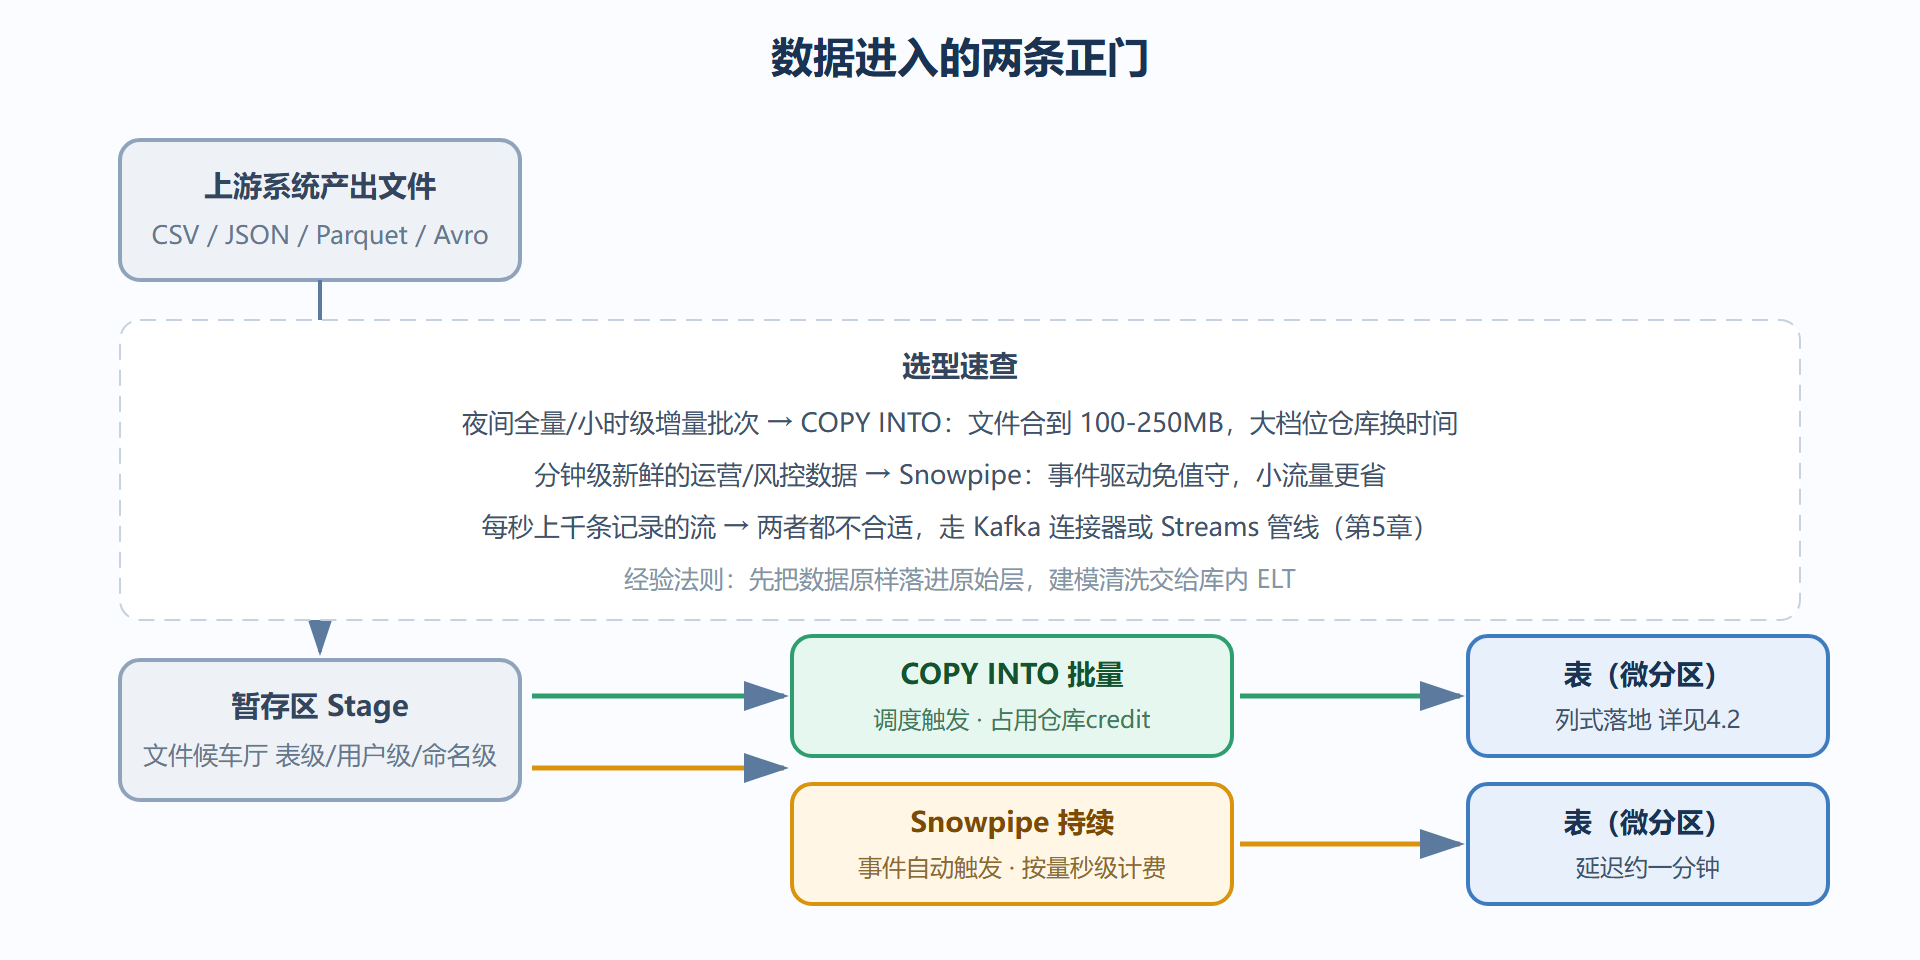
三个工程要点。文件大小要调:加载是并行扫描文件的,太碎的文件(几 KB 一个)会让并行度浪费在调度上,官方建议 100 到 250 MB 一个文件为宜;导出端合并小文件往往比调加载参数更有效。ON_ERROR 决定容错策略:ABORT_STATEMENT 遇错即停(适合强一致性要求),SKIP_FILE 跳过坏文件继续(适合日志类数据),配合 VALIDATION_MODE 可以先试运行不落库。加载会消耗仓库 credit:COPY INTO 跑在你指定的仓库上,大批量加载用大档位仓库换时间,与第3章的档位逻辑完全一致。
路径二:Snowpipe 持续加载
报表可以等批处理窗口,但风控、监控、运营大盘等不了几小时的批次。Snowpipe 的定位是"文件落地后自动加载",链路是:文件写入对象存储 → 事件通知(如队列服务消息)→ Snowpipe 触发加载。延迟通常在一分钟上下。
-- 1. 定义文件格式(可复用) CREATE FILE FORMAT json_ff TYPE = JSON; -- 2. 建管道(Pipe),绑定暂存区与目标表 CREATE PIPE orders_pipe AUTO_INGEST = TRUE AS COPY INTO raw_orders FROM @my_s3_stage FILE_FORMAT = (FORMAT_NAME = json_ff); -- 3. 在云平台侧为暂存区配置事件通知后,查看管道状态 SELECT SYSTEM$PIPE_STATUS('orders_pipe'); -- 4. 加载历史:刷新管道以扫描遗漏的历史文件 ALTER PIPE orders_pipe REFRESH;
计费是 Snowpipe 与 COPY INTO 的分水岭:Snowpipe 不占用仓库、不按 credit/小时计费,而是按实际消耗的服务器资源按秒计费。频率低、单次量小的加载用它非常划算;如果是每分钟涌来几个 GB 的洪流,攒成批次走 COPY INTO 反而更省。
图:两条加载路径的对照
案例:一条埋点数据的进表之路
把两条路径放进一个真实场景。某电商有三种数据源:每天凌晨从业务库导出的订单快照(几 GB 的 CSV)、渠道方的对账文件(不定期到达)、App 埋点 JSON(全天持续产生)。三者的落地选择各不相同:
- 订单快照走 COPY INTO:夜间调度器合并导出文件到暂存区,仓库用 L 档位跑十几分钟完成,白天不产生任何加载费用;
- 对账文件走 Snowpipe:到达时间不可预期,事件触发自动进表,运维零值守;
- 埋点 JSON 同样走 Snowpipe 进原始层表(全列 VARIANT),后续再用任务调度做清洗建模——这正是"先落地、后建模"的 ELT 风格,清洗细节在 4.4 与第5章继续。
结果对比:改造前,三种数据源共用一个每半小时跑一次的导入脚本,对账文件平均延迟半小时、埋点延迟半小时且高峰积压;改造后,订单快照零变化,对账与埋点延迟降到一分钟左右,且没有为"随时可能来的文件"常驻任何仓库。加载路径的选型,本质上是在"延迟需求"与"计费模型"之间做匹配。
本节要点回顾
- Stage 是候车厅:表级、用户级、命名级三种;生产环境用命名暂存区配存储集成。
- COPY INTO:批量主力,按仓库 credit 计费;文件合并到 100 至 250MB,注意 ON_ERROR 策略。
- Snowpipe:事件驱动的持续加载,按量计费,延迟约一分钟;不适合超大洪流。
- ELT 风格:原始数据先原样落地,清洗建模在库内用 SQL 完成。
数据进了门,下一节打开引擎盖看它落地后的物理形态——微分区。
问题:坏行混进文件怎么办?
分两步:先用验证模式试运行,把错误文件与错误行数先暴露出来,再决定策略。强一致场景选整体中止并修数重跑;日志类场景选跳过坏文件,同时把被跳过的记录另存到错误表供事后补录。关键是把"容错策略"写成加载规范的一部分,而不是每次出错临时决定。
问题:要支持多少种文件格式?
CSV、JSON、Parquet、Avro、ORC、XML 都有原生支持,优先级建议:上游能产出 Parquet 就优先 Parquet——列式文件天然跳过不需要的列,加载又快又省;CSV 次之但要把编码、分隔符、转义规则写进文件格式定义;XML 消耗最高,能转 JSON 就转。