4.2 微分区与列式存储:数据如何落地
4.2 微分区与列式存储:数据如何落地
本节摘要:微分区(Micro-partition)是 Snowflake 存储层的原子单位:约 16MB 压缩后的一批行、按列组织、自带 min/max 统计,全部自动完成。本节把"免索引为什么可行"这个第1章留下的伏笔彻底讲清:不是没有索引,而是把定位数据的职责从人工建的索引转移到自动维护的统计剪枝上。附一次剪枝效果的实测与聚簇初识。
把一张表放大看
从本节起,我们进入存储层内部。上一章的架构图里,存储层只是底部一条蓝色横带;现在把这条横带放大,里面是 snowflake 落地数据的全部秘密。先建立三个尺寸概念:
- 数据加载或写入时,行被自动分成连续的批次,每批压缩后约 16MB(压缩前约 50 到 500MB);
- 每个批次内部不按行堆叠,而是按列切开存储,同列数据类型一致、相似度高,压缩率因此极高;
- 每个批次为每列记录最小值、最大值等统计,存进元数据。
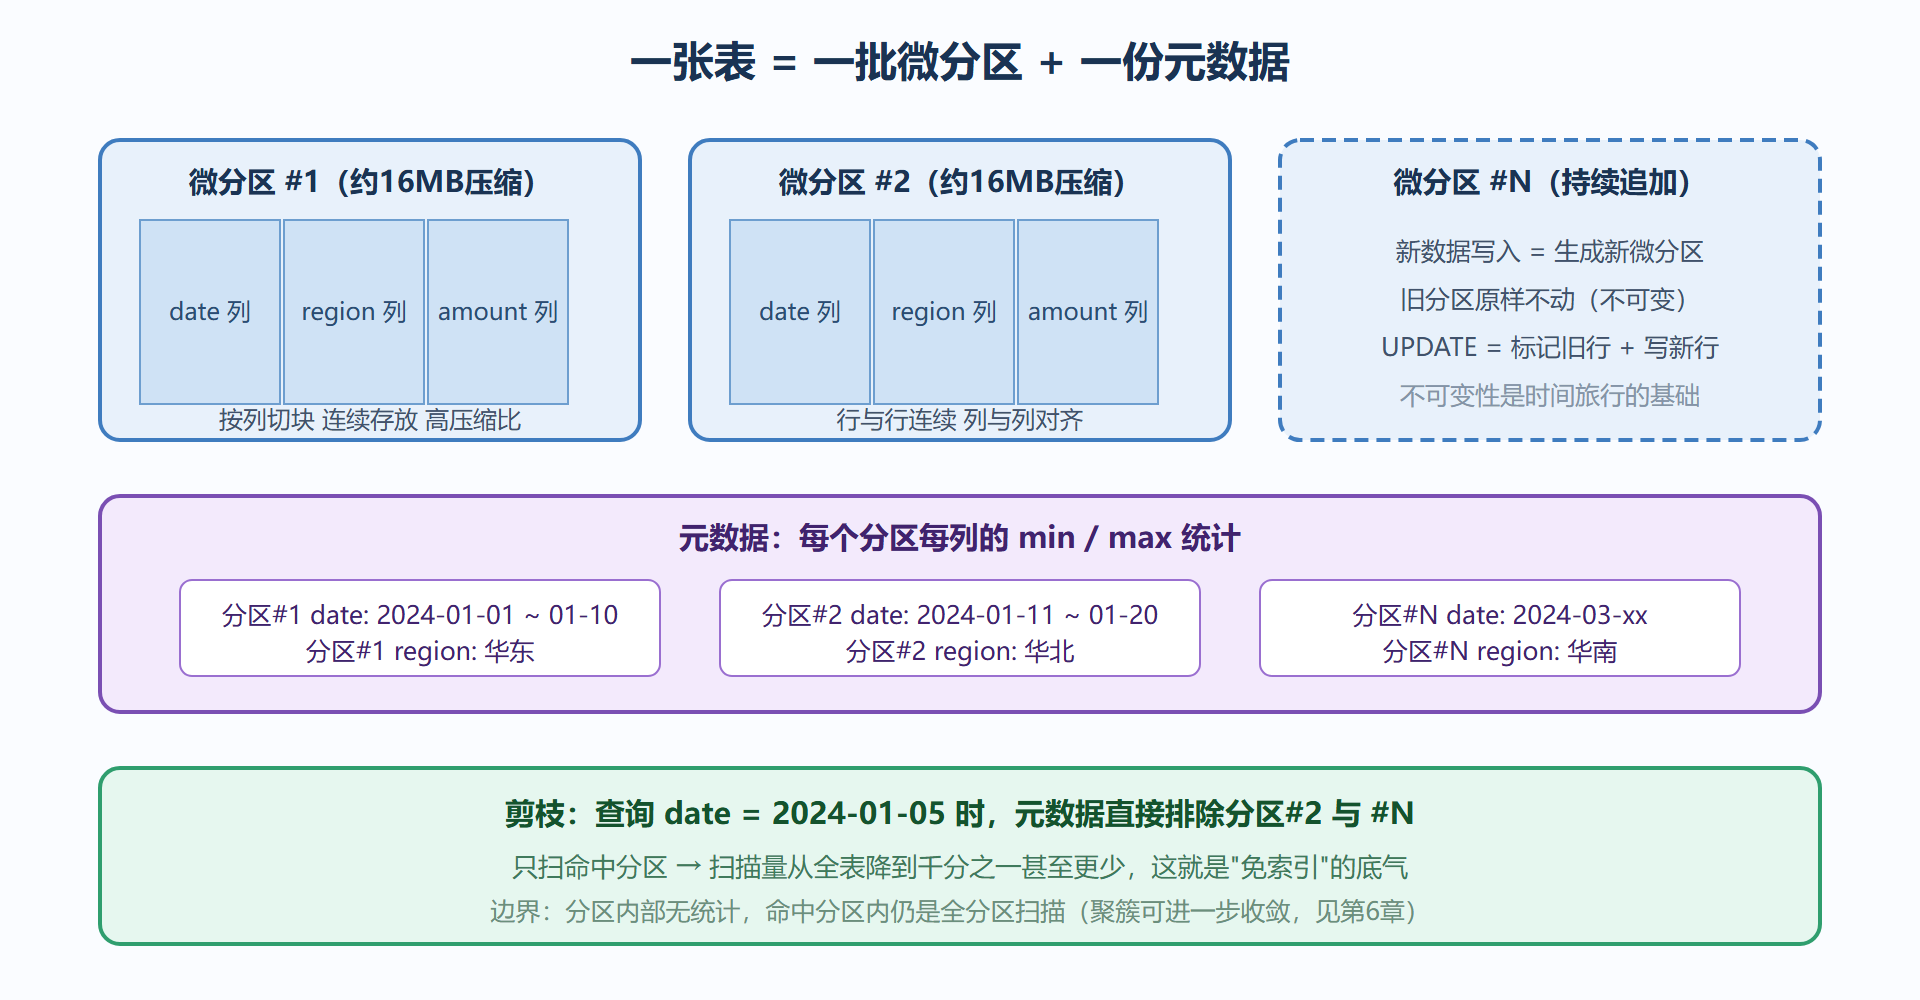
这三个批次就是微分区。一张表就是一批微分区的集合,外加一份描述"哪行数据在哪个分区"的元数据。整个过程全自动:没有分区函数要写,没有分区键要选,数据来了就切。
图:微分区与列式存储结构
剪枝实测:统计元数据值多少钱
上一节的示意图需要用数字兑现。建一张日期分布很宽的表,然后看一条点范围查询到底扫了几个分区:
-- 用示例数据集做实验(内置的 TPC-DS 样例库,约几十亿行的目录表) USE WAREHOUSE demo_wh; USE DATABASE SNOWFLAKE_SAMPLE_DATA; -- 查看这张表的微分区概况 SELECT SYSTEM$CLUSTERING_INFORMATION('TPCDS_SF10TCL.DATE_DIM'); -- 一条窄范围查询:理论上只应命中极少数分区 SELECT COUNT(*) FROM TPCDS_SF10TCL.CATALOG_RETURNS WHERE SR_RETURNED_DATE_SK BETWEEN 2451189 AND 2451200; -- 关键证据:扫描分区数 / 总分区数 SELECT QUERY_ID, PARTITIONS_SCANNED, PARTITIONS_TOTAL, ROUND(PARTITIONS_SCANNED / PARTITIONS_TOTAL * 100, 3) AS pruned_pct FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY ORDER BY START_TIME DESC LIMIT 1;
预期能看到 PARTITIONS_SCANNED 远小于 PARTITIONS_TOTAL——多数分区根本没被打开,只是被元数据里的 min/max"否决"了。这就是剪枝(partition pruning)。对比传统方案,同样的效果需要你在设计期就选好分区键;而 Snowflake 对每一列都记录统计,任何列上的过滤条件都可能触发剪枝。查询按过滤条件"撞"上分区统计,撞中了就少扫。
微分区的不可变性
还有一个反直觉但极其重要的属性:微分区一旦写成就不可变。INSERT 生成新分区;UPDATE 不修改旧分区,而是把旧行标记为删除、把新值写成新行;DELETE 只是给行打删除标记。旧版本数据在保留期内一直物理存在——这正是下一节 Time Travel 能"回到过去"的物理基础,也是它不需要复制数据的根本原因。
不可变性同时解释了几件事:并发读写互不阻塞(读的是旧版本,写的是新版本);存储费用不只来自"活数据",删除标记未清理的旧版本同样占空间(保留期结束后才被后台清理,或进入 7 天 Fail-safe,详见下一节)。
聚簇初识:当自然顺序不够用
微分区默认按数据到达顺序排列。如果查询的过滤列恰好与到达顺序相关(如按天到达的事件表按日期查),min/max 区间窄、剪枝极好。但如果数据乱序进入(如多来源混合写入、按客户号查询事件表),每个分区的 min/max 区间都会很宽,剪枝失效。
这时可以给表定义聚簇键(Cluster Key),让后台服务按键值重新整理分区归属,使每列的 min/max 收窄。代价是后台重整消耗额外 credit 与存储(重整期间的临时文件),所以它只该用在"表很大 + 剪枝确实失效 + 查询频繁"的场景,第6章会给出判断流程与 SYSTEM$CLUSTERING_INFORMATION 的解读方法。
💡 关键直觉:免索引不等于免设计。设计被推迟到了写入之后——数据自己先长成自然的微分区,等查询模式清晰了,再决定要不要花聚簇的钱。这是"先跑起来再优化"在存储层的体现。
本节要点回顾
- 微分区三要素:压缩后约 16MB、列式组织、逐列 min/max 统计,全部自动维护。
- 剪枝机制:查询条件与分区统计比对,未命中分区直接不读——免索引设计的实现方式。
- 不可变性:分区只增不改,删改是"标记 + 重写",旧版本物理保留,是 Time Travel 的地基。
- 聚簇键:乱序数据剪枝失效时的补救,有明确成本,按需启用。
数据落地成了一堆只增不改的分区。那么问题来了:被"标记删除"的旧版本去了哪?答案就在下一节的时间线里。
与传统分区表的对照
用过 MySQL 或 Hive 分区表的读者,最容易把微分区当成熟悉的东西,三点差异值得摆清楚:其一,传统分区是"设计期决定",分区键选错要重建表;微分区是"写入期自动",没有选错的机会也没有选错的代价。其二,传统分区对未分区列没有统计;微分区对每一列都记 min/max,任何列上的过滤都可能剪枝。其三,传统分区的"分区裁剪"依赖执行计划识别;微分区剪枝是元数据比对的默认步骤。一句话:微分区把分区从"运维工作"变成了"物理事实"。
小文件问题存在吗
存在,但形态不同。传统数仓的小文件问题来自上游频繁产出小文件,导致元数据与扫描开销膨胀;Snowflake 侧由加载端合并文件(4.1 的尺寸建议)解决大半,服务层的后台任务也会合并碎片化的微分区。你仍然要管上游文件尺寸,但不必为库内碎片焦虑——这条边界划清后,小文件从"日常运维"降级为"加载规范"。